ChatGPT a changé sa façon de choisir ses sources, plus que tout autre modèle que nous suivons.
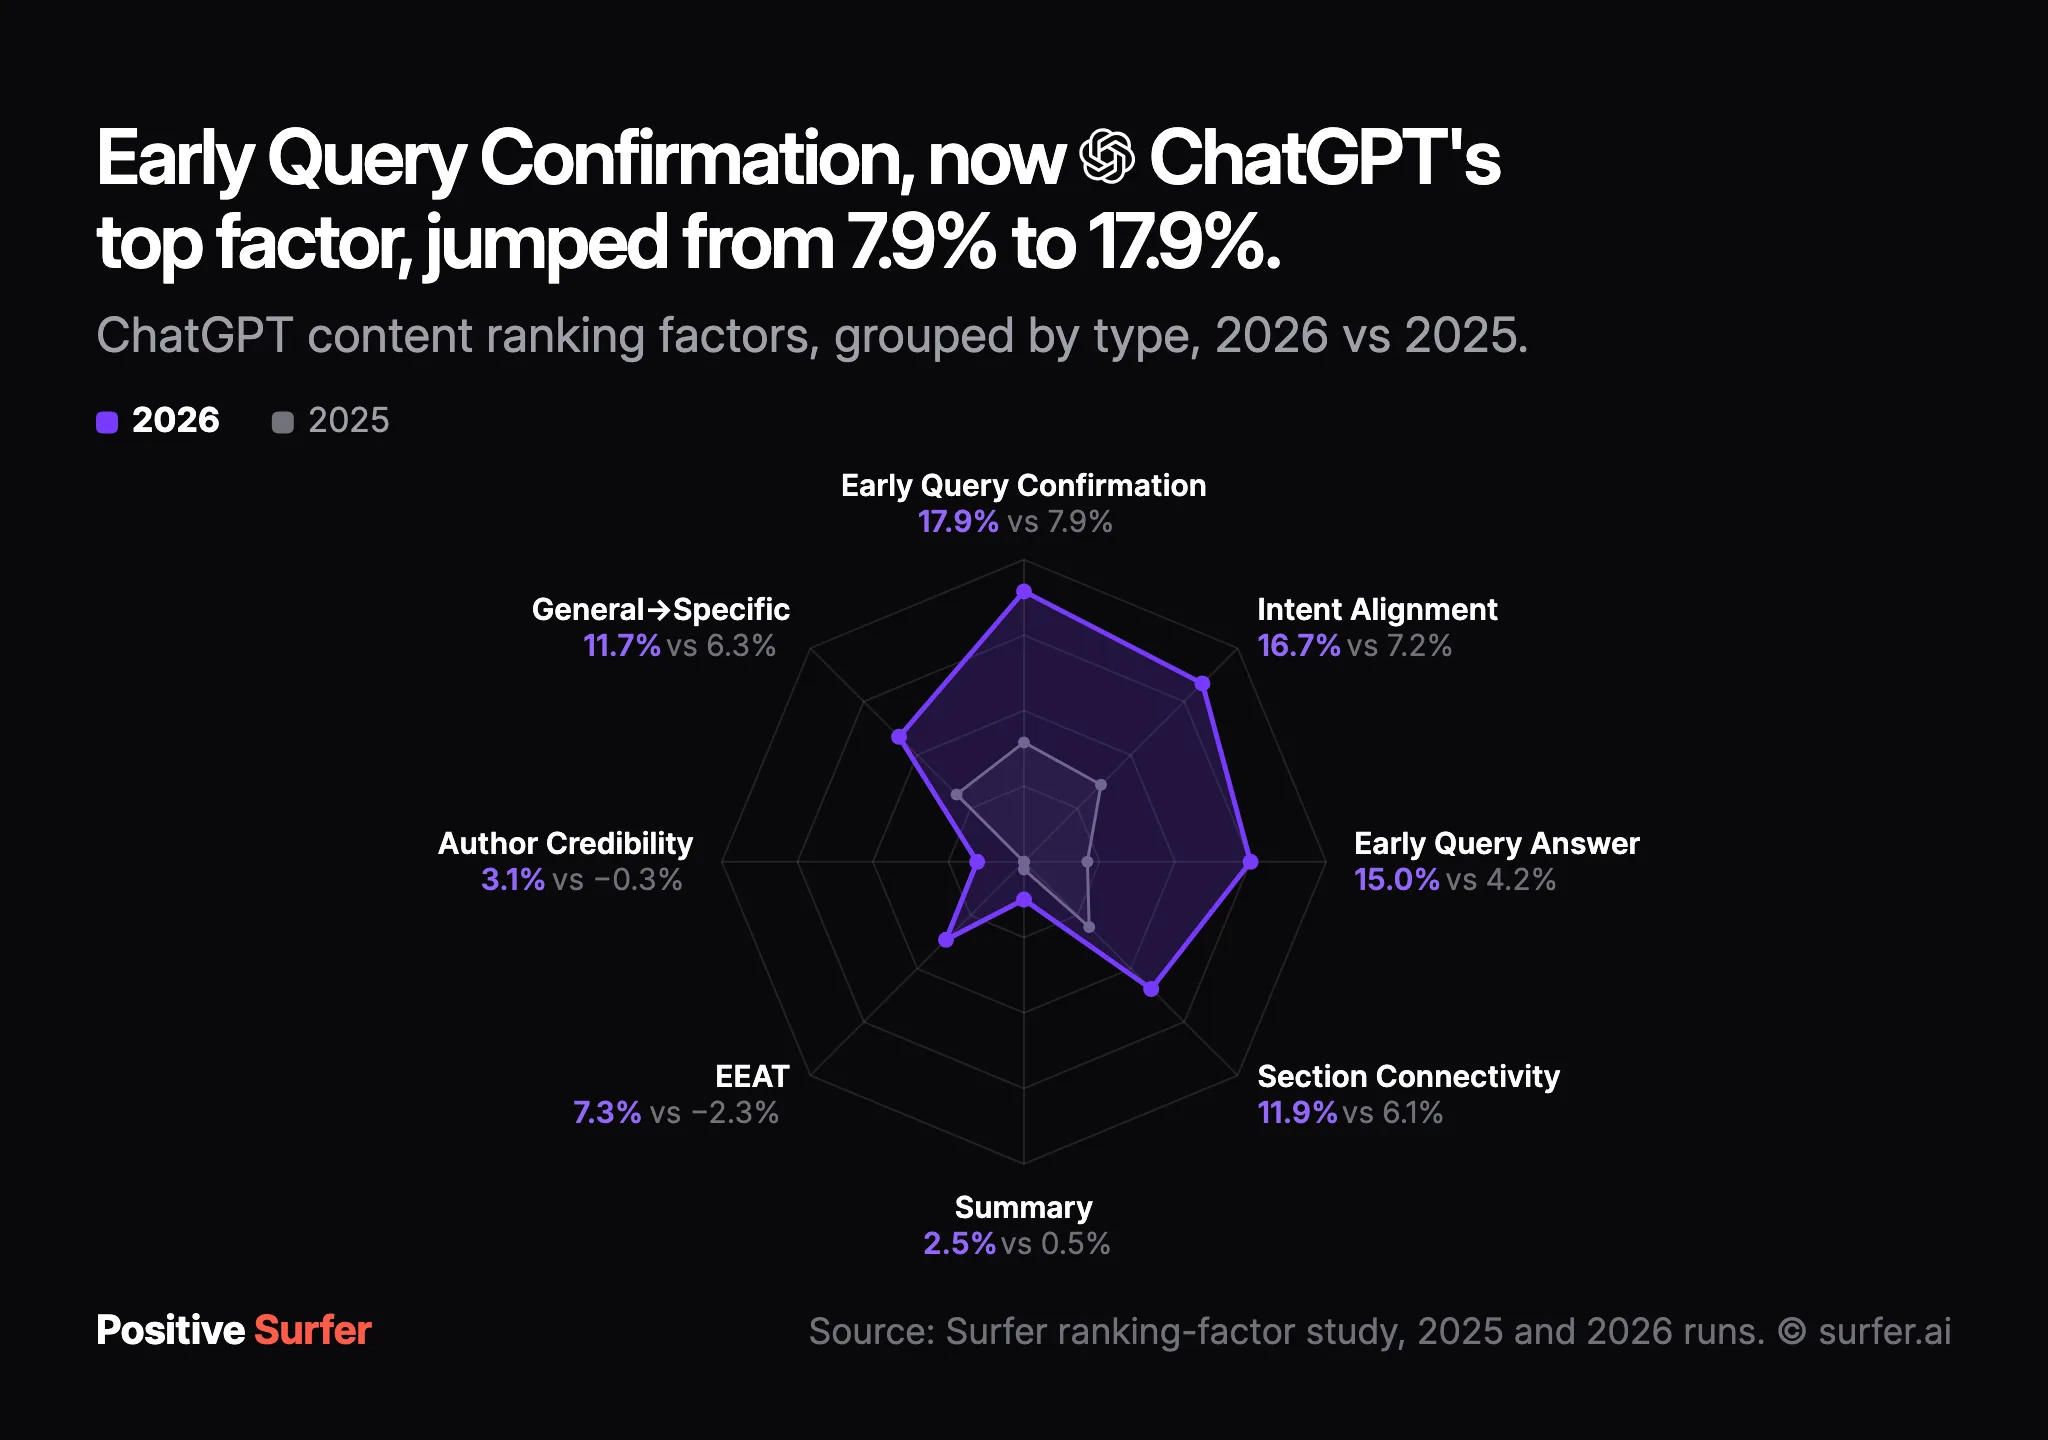
Depuis plus d’un an, nous évaluons les citations de l’IA au regard de critères de classement du contenu par l’IA, sur deux grandes campagnes de collecte. Lors de la campagne 2025, le premier critère de ChatGPT était de savoir si le contenu étaye ses affirmations par des données précises et des sources nommées, et il ignorait complètement les signaux E-E-A-T. Lors de la campagne 2026, il s’est mis à mesurer une seule chose (de trois manières différentes que j’explique ci-dessous) : ce qui se passe dans votre premier paragraphe.
Personne n’a publié cette comparaison avant nous, car personne d’autre ne dispose de données fiables. Nous l’avons gardée sous le coude pendant un an, en attendant la deuxième campagne.
Voici ce qui a changé, et ce qu’il faut faire en conséquence.
ChatGPT n’est plus l’exception
Lors de notre campagne 2025, ChatGPT faisait figure d’original.
Tous les autres modèles récompensaient les contenus bien structurés qui vont droit au but. ChatGPT, lui, se souciait peu de la structure : les valeurs de ses critères restaient basses, son premier critère était Factual Grounding and Attribution Quality (ancrage factuel et qualité de l’attribution : votre contenu cite-t-il des données précises et des sources nommées ?), et c’était le seul modèle de notre jeu de données à présenter des valeurs négatives : Author Credibility (crédibilité de l’auteur : la page indique-t-elle qui l’a écrite et pourquoi cette personne est qualifiée ?) et Experience Signals (signaux d’expérience : le contenu démontre-t-il une expérience de première main du sujet ?) se situaient tous deux sous zéro.
La campagne 2026 raconte une tout autre histoire :
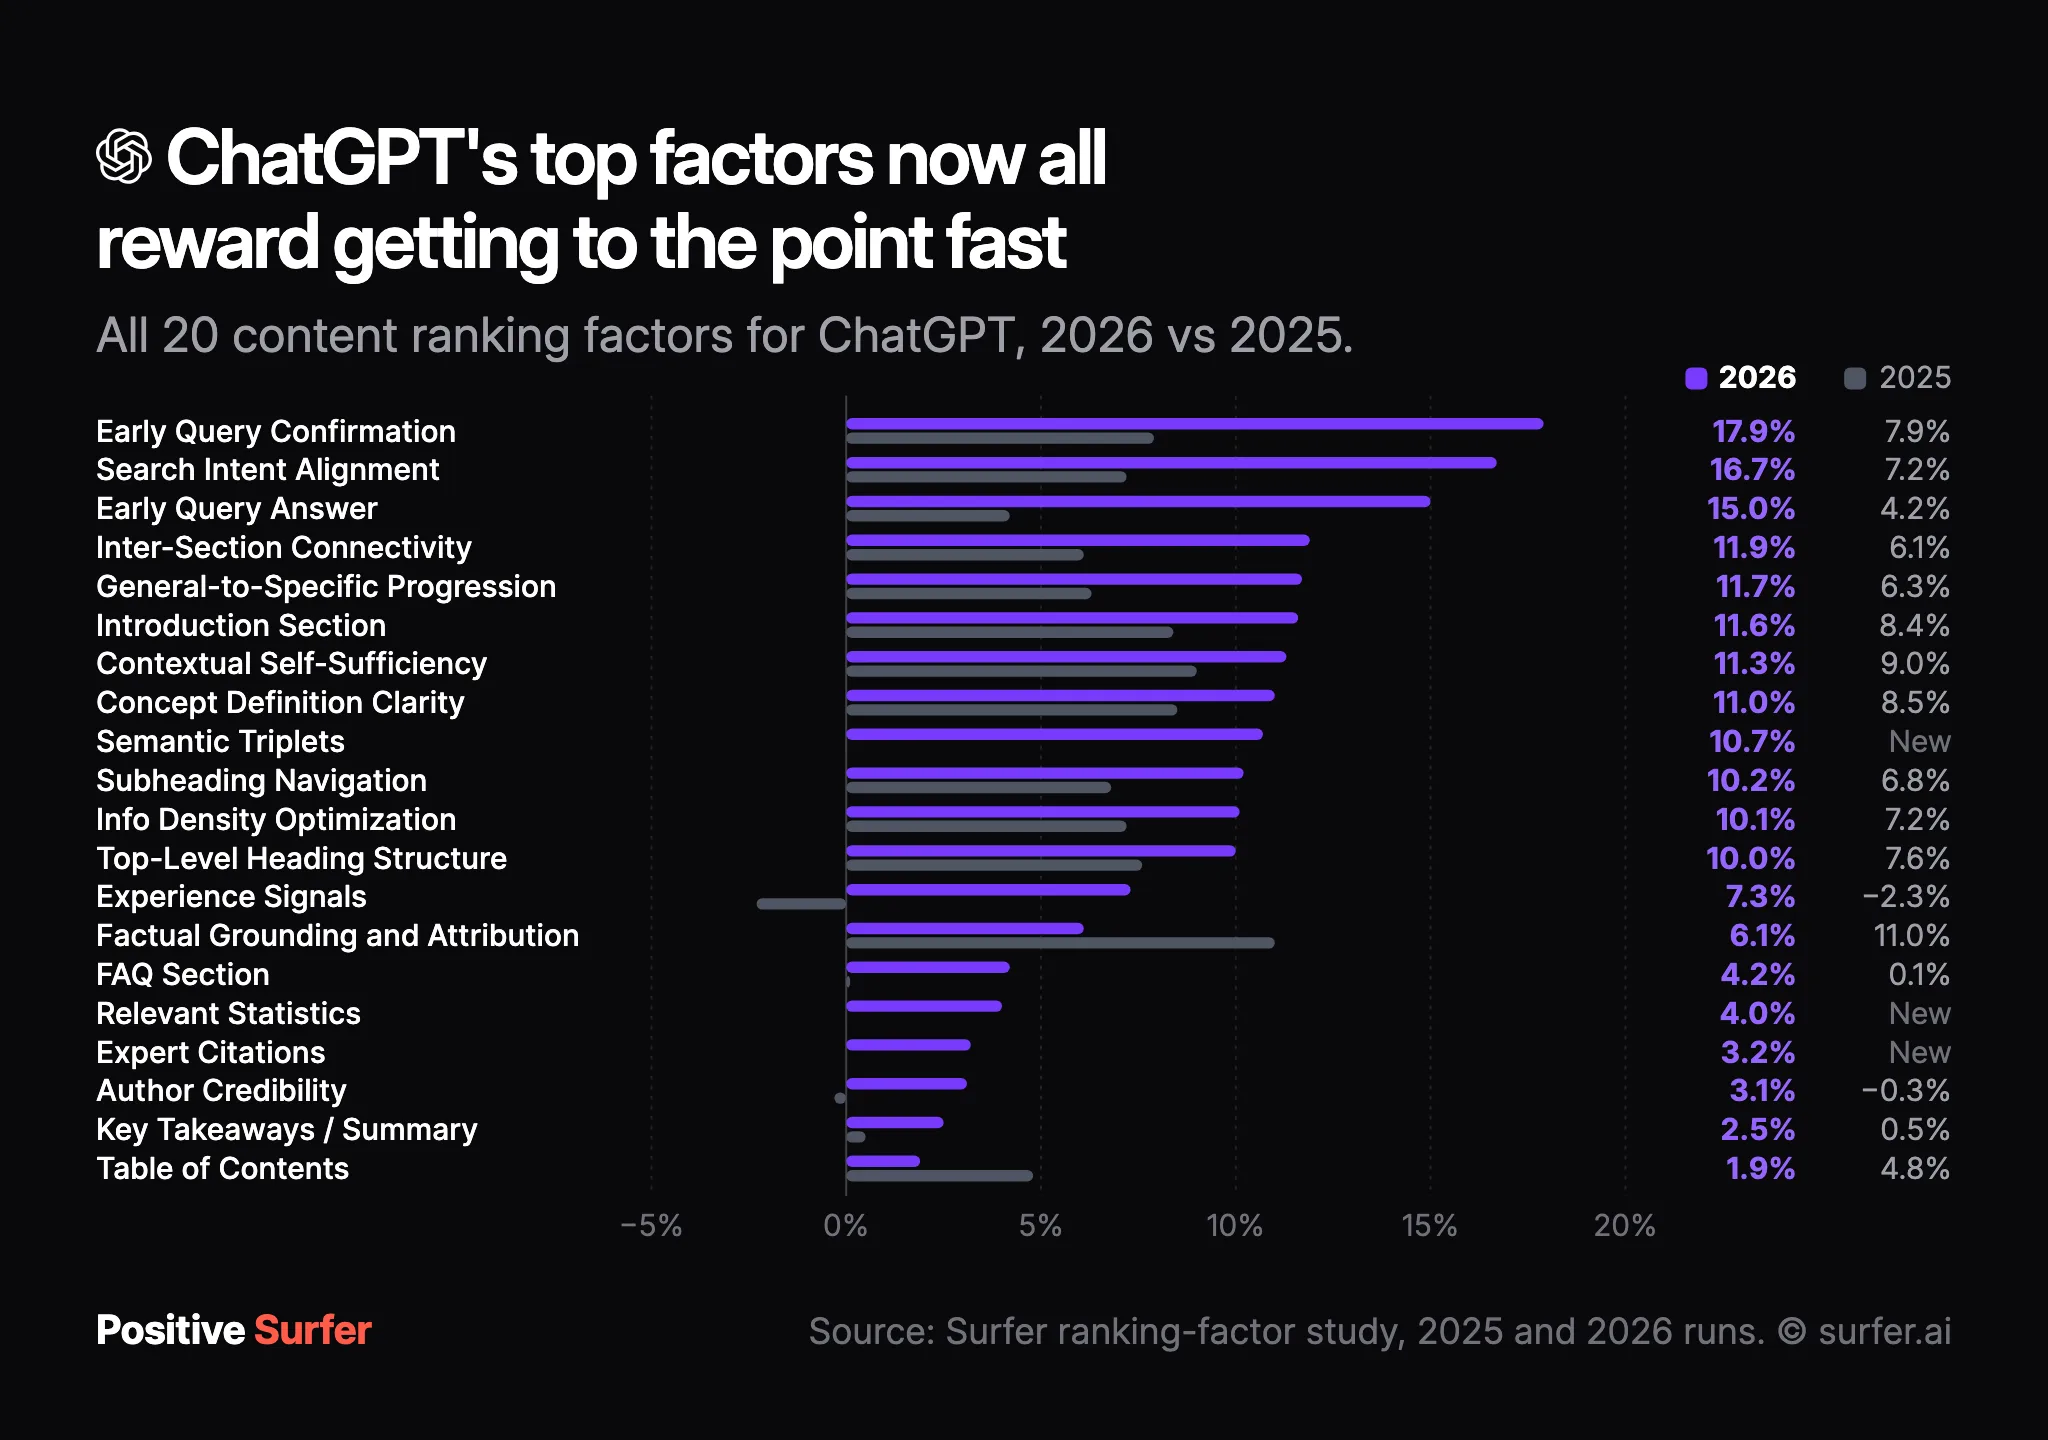
ChatGPT ressemble désormais beaucoup à Perplexity.
Trois changements se démarquent, et chacun modifie ce que vous devriez faire.
Selon l’étude publiée par OpenAI en septembre 2025, 52 % des interactions avec ChatGPT sont des questions ! Les gens cherchent des informations, des conseils ou de l’aide. Et vous voulez que votre marque soit celle qui détient ces informations, ces conseils, ou qui peut résoudre le problème. C’est le moment de diffusion de votre marque
Premier changement : c’est votre premier paragraphe qui décide
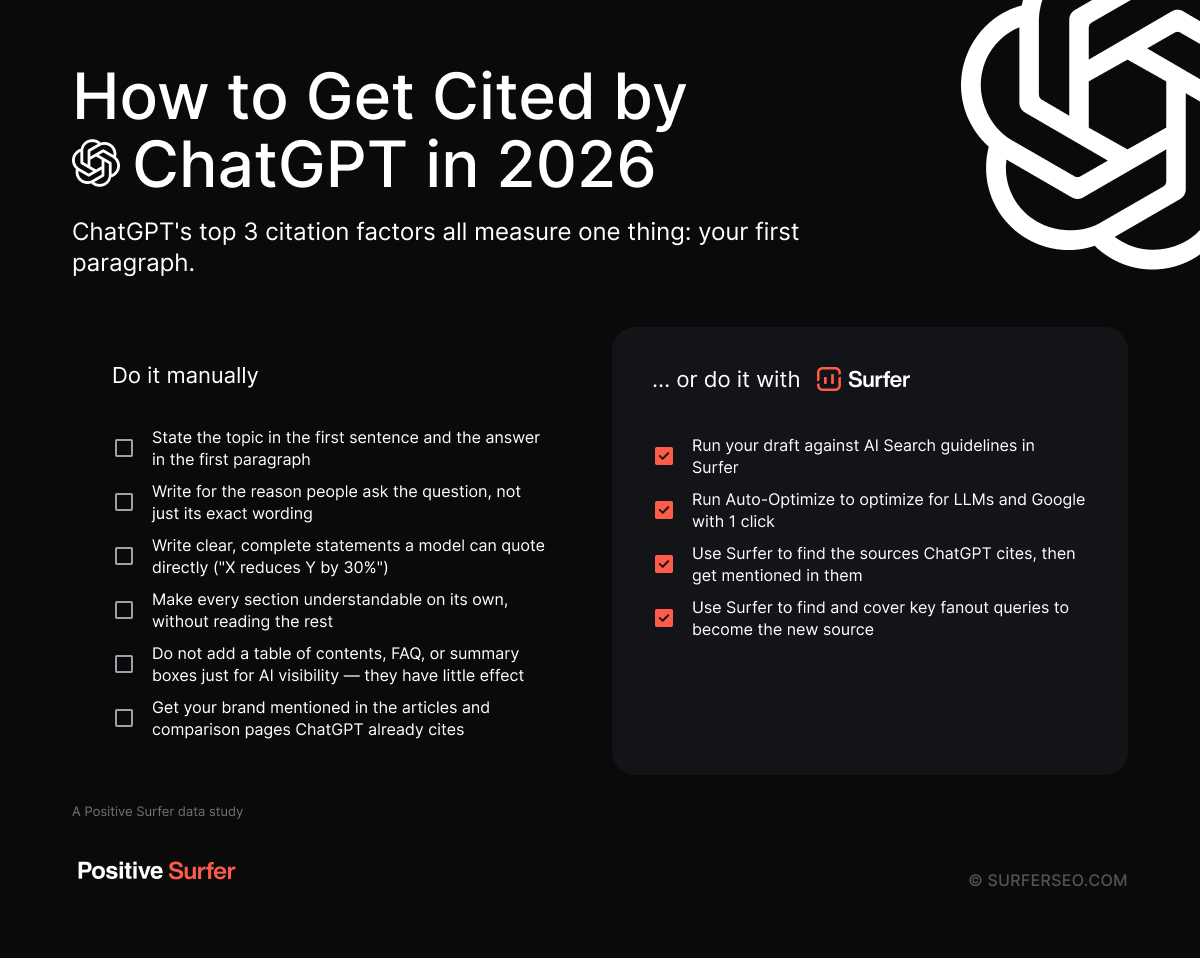
Les trois premiers critères de la campagne 2026, Early Query Confirmation (confirmation précoce de la requête : votre premier paragraphe indique-t-il qu’il répond à la bonne question ?), Search Intent Alignment (alignement avec l’intention de recherche : votre contenu répond-il à la raison pour laquelle la personne pose la question ?) et Early Query Answer (réponse précoce à la requête : donnez-vous une version courte de la réponse avant de développer ?), mesurent tous la rapidité avec laquelle votre contenu va droit au but.
Il y a un an, ces critères se classaient en milieu de tableau ou plus bas pour ChatGPT. Aujourd’hui, ils arrivent en tête avec une nette avance.
Cela concorde avec les résultats de notre étude sur l’emplacement des citations : près de 40 % de toutes les citations de l’IA proviennent des 100 premiers mots d’une page, une part qui a presque doublé en un an. Le changement de critères de ChatGPT et la tendance observée sur l’emplacement des citations sont deux facettes du même comportement. Les modèles convergent vers le haut de votre document.
Si vous avez lu notre étude sur Perplexity, la méthode vous semblera familière : nommez le sujet dès la première phrase, donnez la réponse courte avant de développer et répondez à l’intention réelle derrière la requête, pas seulement à sa formulation littérale. Ce que nos données désignent comme la stratégie gagnante pour Perplexity fonctionnera aussi pour ChatGPT.
Deuxième changement : l’effondrement de l’ancrage factuel
Voici le résultat auquel je ne m’attendais pas.
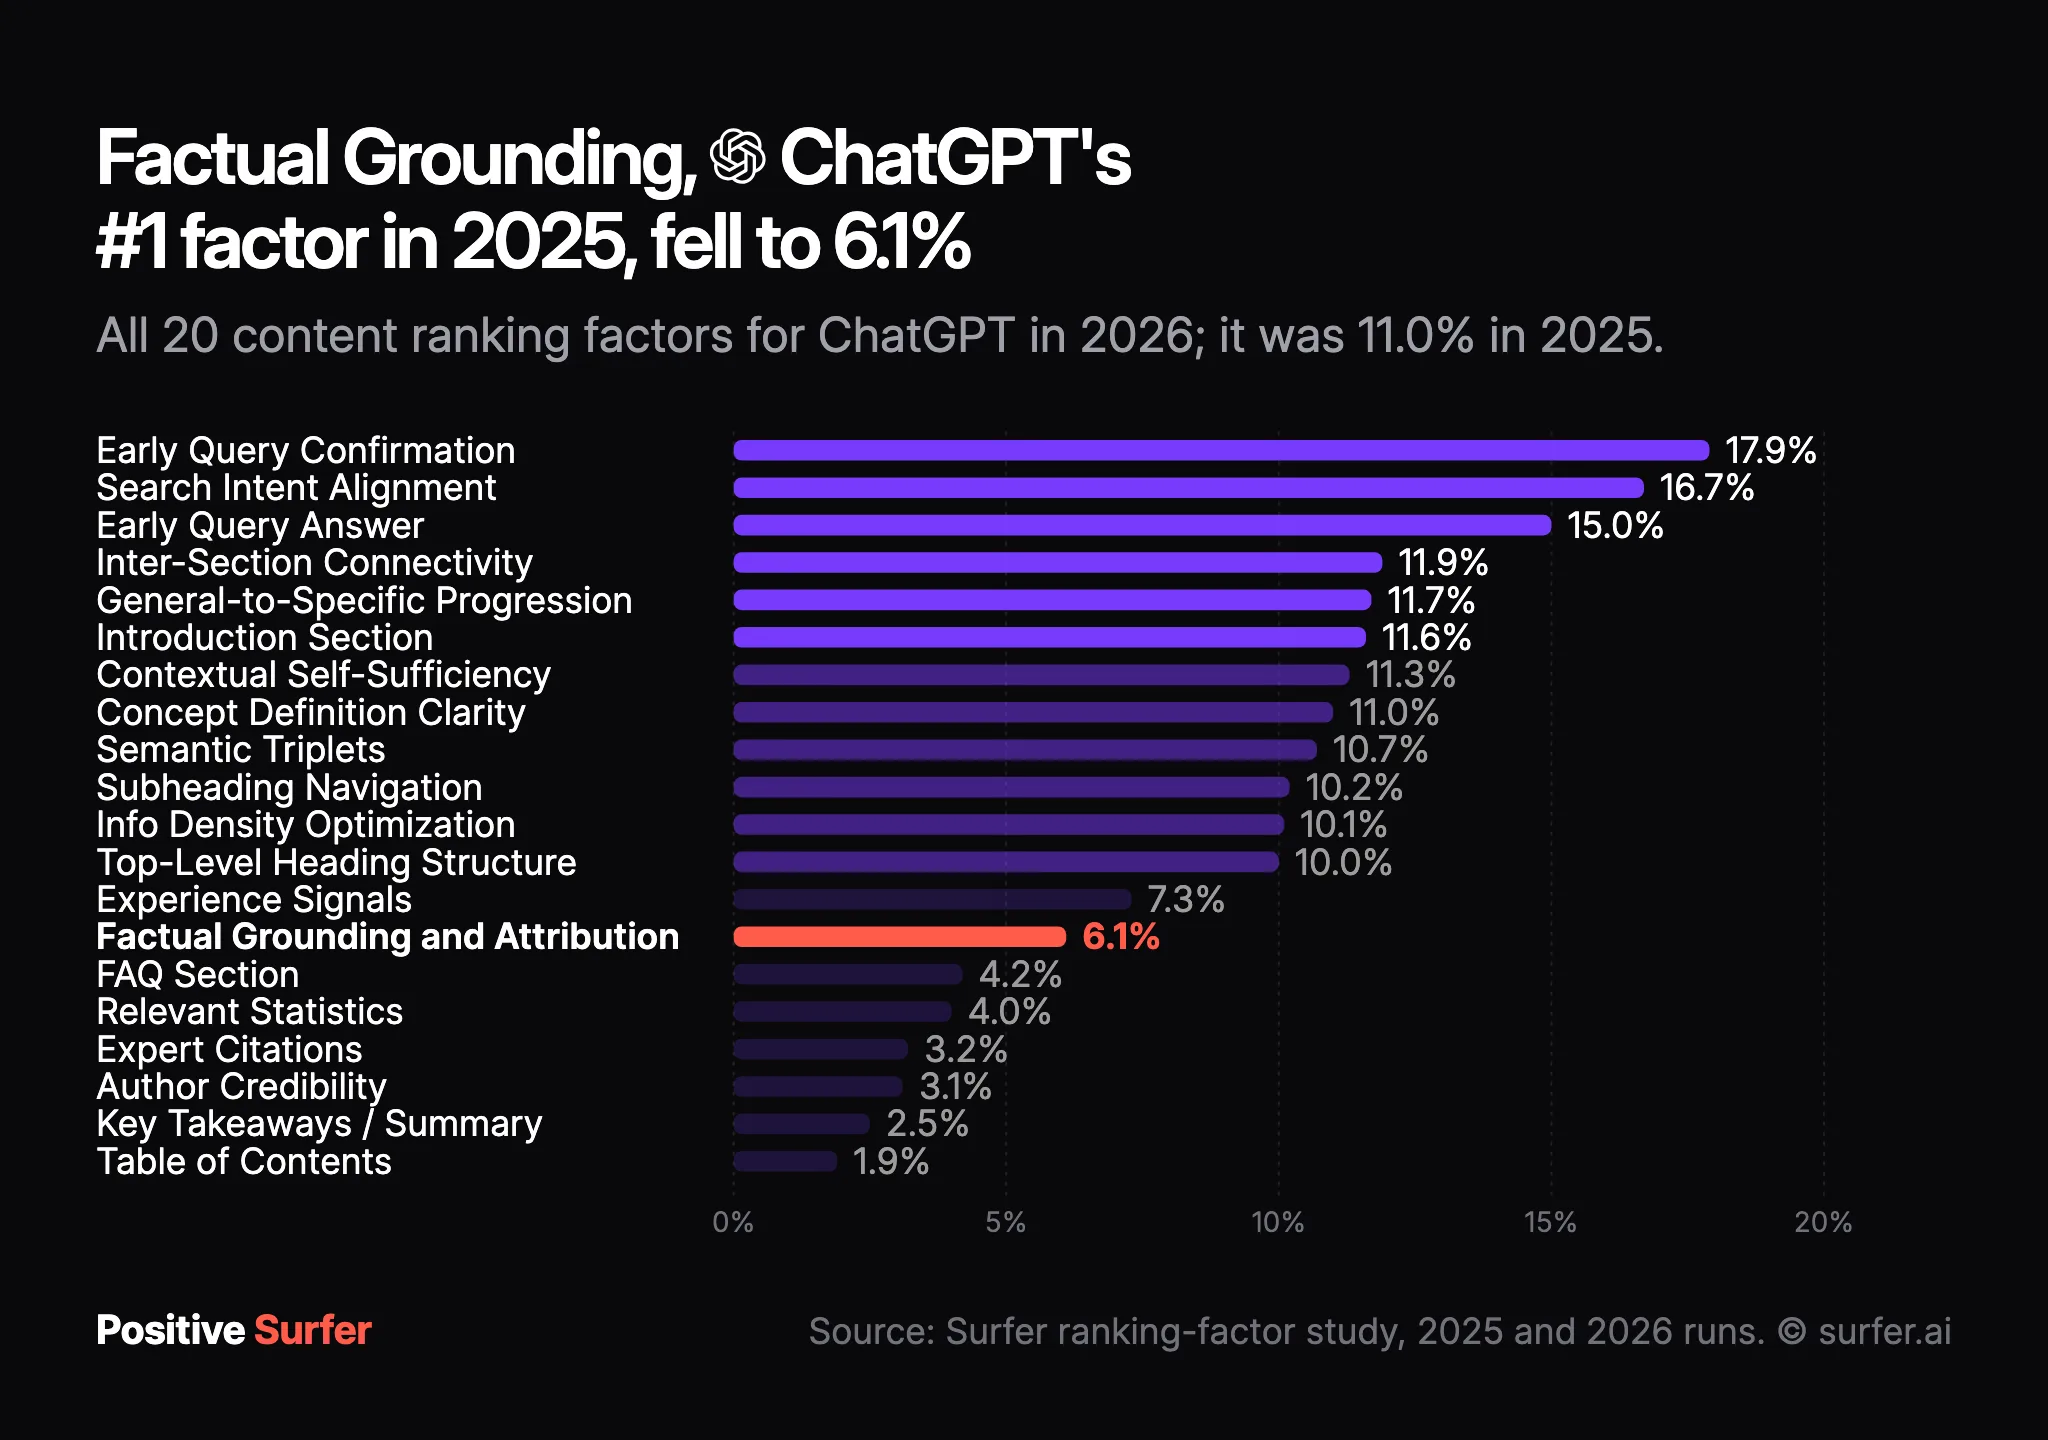
Factual Grounding and Attribution Quality, premier critère de ChatGPT il y a un an avec 11 %, est tombé à 6,1 %, dans le dernier tiers du tableau.
Soyons honnêtes sur ce que nous pouvons dire ou non. Les données montrent que la corrélation s’est affaiblie ; elles ne disent pas pourquoi. Peut-être que la récupération de ChatGPT est devenue meilleure pour vérifier les faits par elle-même. Peut-être que les contenus bien sourcés sont devenus si courants qu’ils ne permettent plus de se démarquer. Ce ne sont que des hypothèses.
Ce que les données disent clairement, en revanche : construire votre stratégie ChatGPT uniquement autour d’un sourçage dense, comme le justifiaient les chiffres de l’an dernier, ne correspond plus au comportement du modèle. Les faits précis et les sources nommées aident toujours, ils ont simplement cessé d’être l’essentiel.
Troisième changement : l’E-E-A-T est passé de négatif à… légèrement positif ?
L’an dernier, ChatGPT était le seul modèle avec des valeurs de critères négatives : Author Credibility à -0,3 % et Experience Signals à -2,3 %. Même en interne, nous étions prudents avec ce résultat : les valeurs étaient proches de zéro, et la lecture honnête était « l’E-E-A-T ne fait pas bouger les lignes pour ChatGPT », et non « ChatGPT pénalise les biographies d’auteur ».
Cette prudence s’est avérée justifiée.
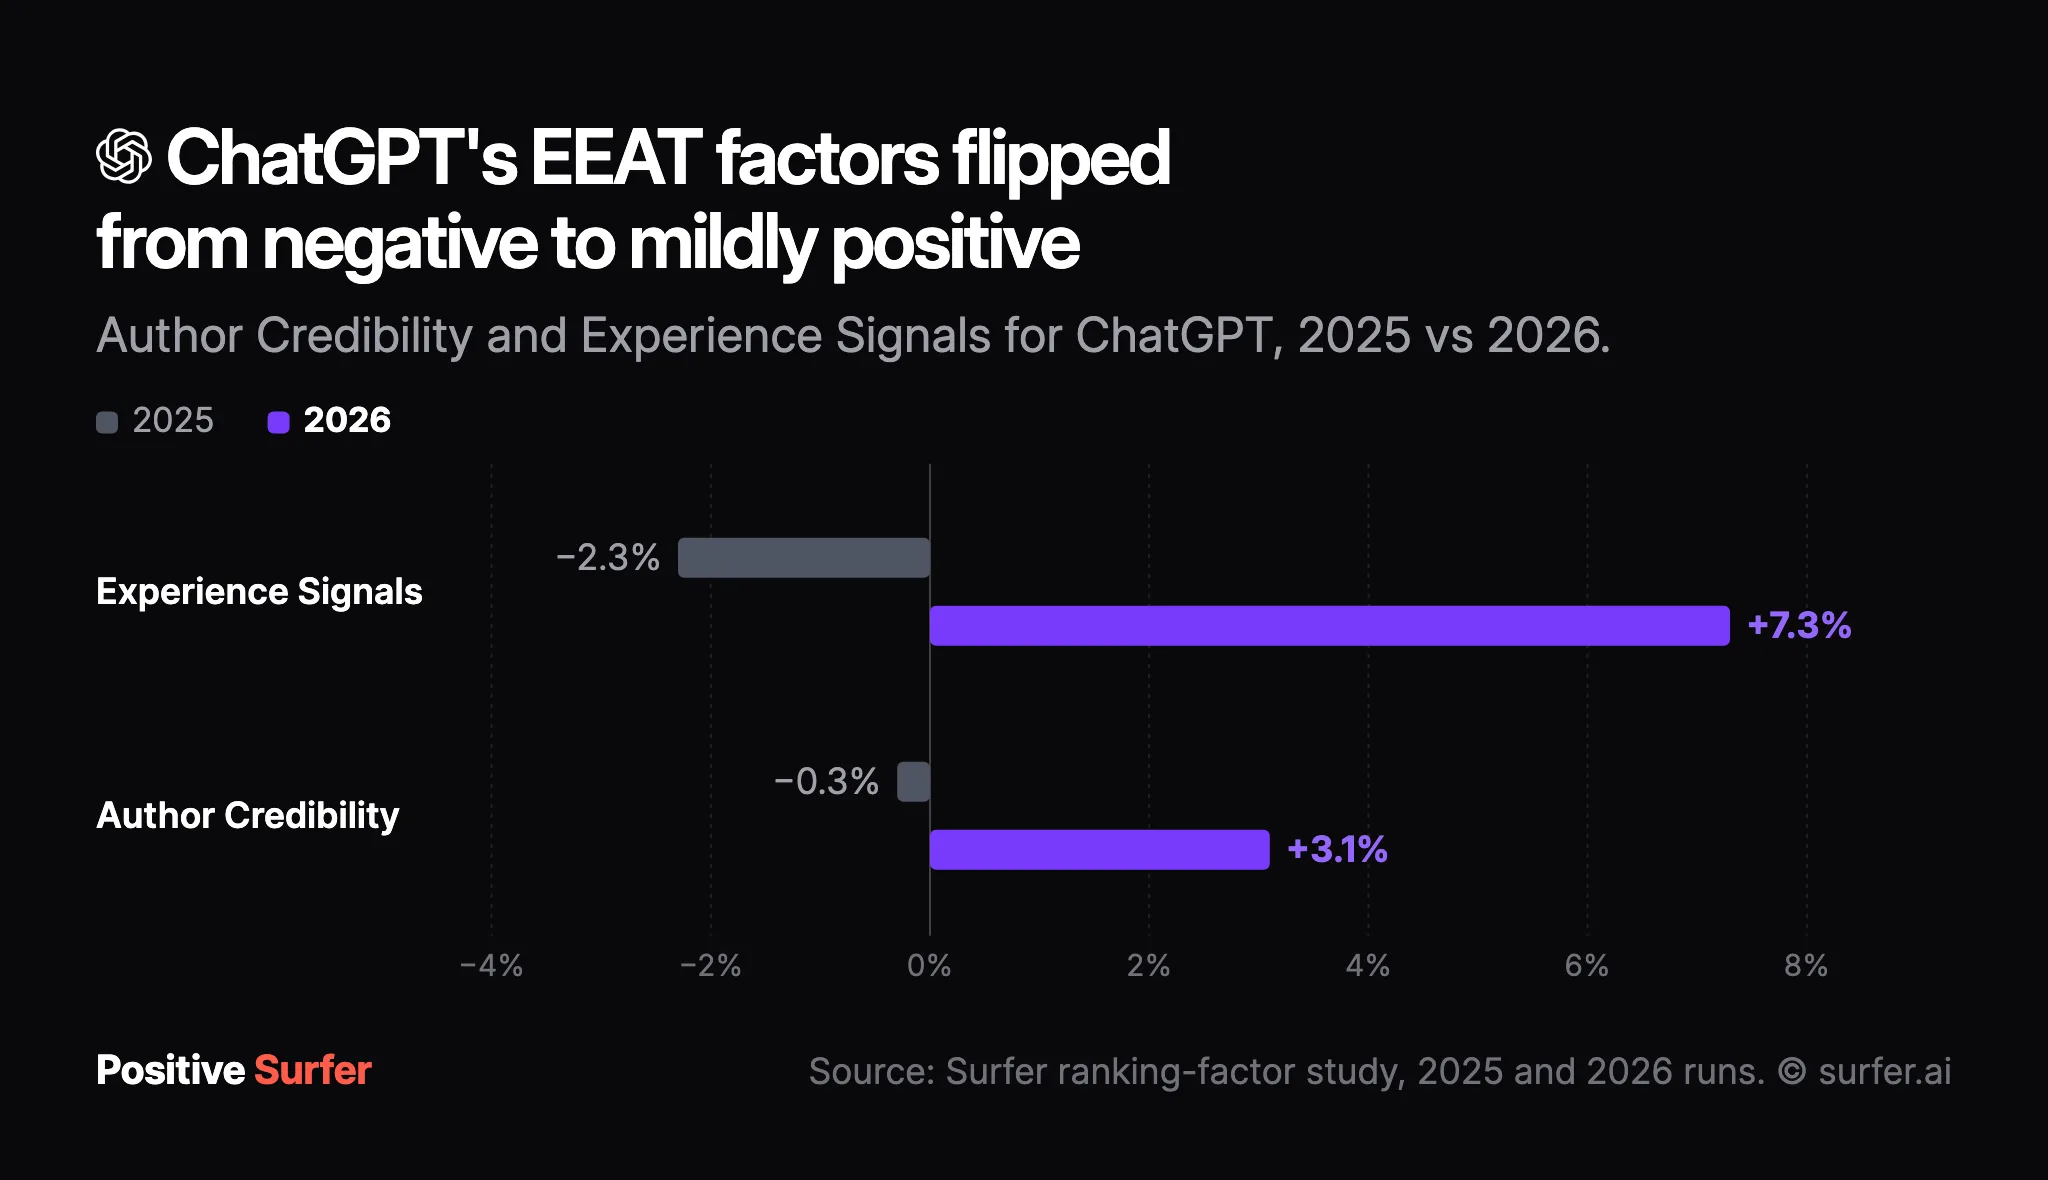
Lors de la campagne 2026, les deux sont devenus positifs : Experience Signals à 7,3 %, Author Credibility à 3,1 %.
Avant de refaire vos pages auteur : ces valeurs restent modestes. Experience Signals se situe désormais en milieu de tableau ; Author Credibility reste près du bas. La lecture honnête, c’est que les signaux E-E-A-T sont passés de non pertinents à légèrement pertinents pour ChatGPT, pas de pénalité à super-pouvoir.
ChatGPT ne contient pas d’index massif de contenus ; il ancre chaque réponse sur le web. Il n’évalue pas la crédibilité des auteurs comme Google : vous pouvez l’influencer avec des contenus qui ne sont pas rédigés par un professionnel, ni même par un auteur pertinent.
Si vous investissez déjà pour démontrer une expérience de première main parce que d’autres modèles la récompensent (AI Mode pondère Experience Signals à 17,4 %, la valeur E-E-A-T la plus élevée de notre jeu de données), ChatGPT ne vous donne plus de raison de vous retenir.
Il ne vous donne pas non plus de raison d’en faire votre priorité.
Ce qui ne fonctionne toujours pas pour ChatGPT
Certaines choses n’ont pas changé.
Le sommaire (1,9 %), les encadrés de points clés (2,5 %), les sections sur la crédibilité de l’auteur (3,1 %), les citations d’experts (3,2 %) et les sections FAQ (4,2 %) se situent tous en bas du tableau 2026, là où ils se trouvaient déjà en 2025.
Si vous ajoutez ces éléments spécifiquement pour votre visibilité dans ChatGPT, les données indiquent toujours que votre temps est mieux investi dans le premier paragraphe. Gardez-les s’ils servent vos lecteurs. Mais ne les rangez pas dans l’optimisation pour l’IA.
Un nouveau critère à connaître : les Semantic Triplets
La grille 2026 comprend un critère qui n’était pas mesuré l’an dernier, et il fait une entrée remarquée à 10,7 % : les Semantic Triplets (triplets sémantiques).
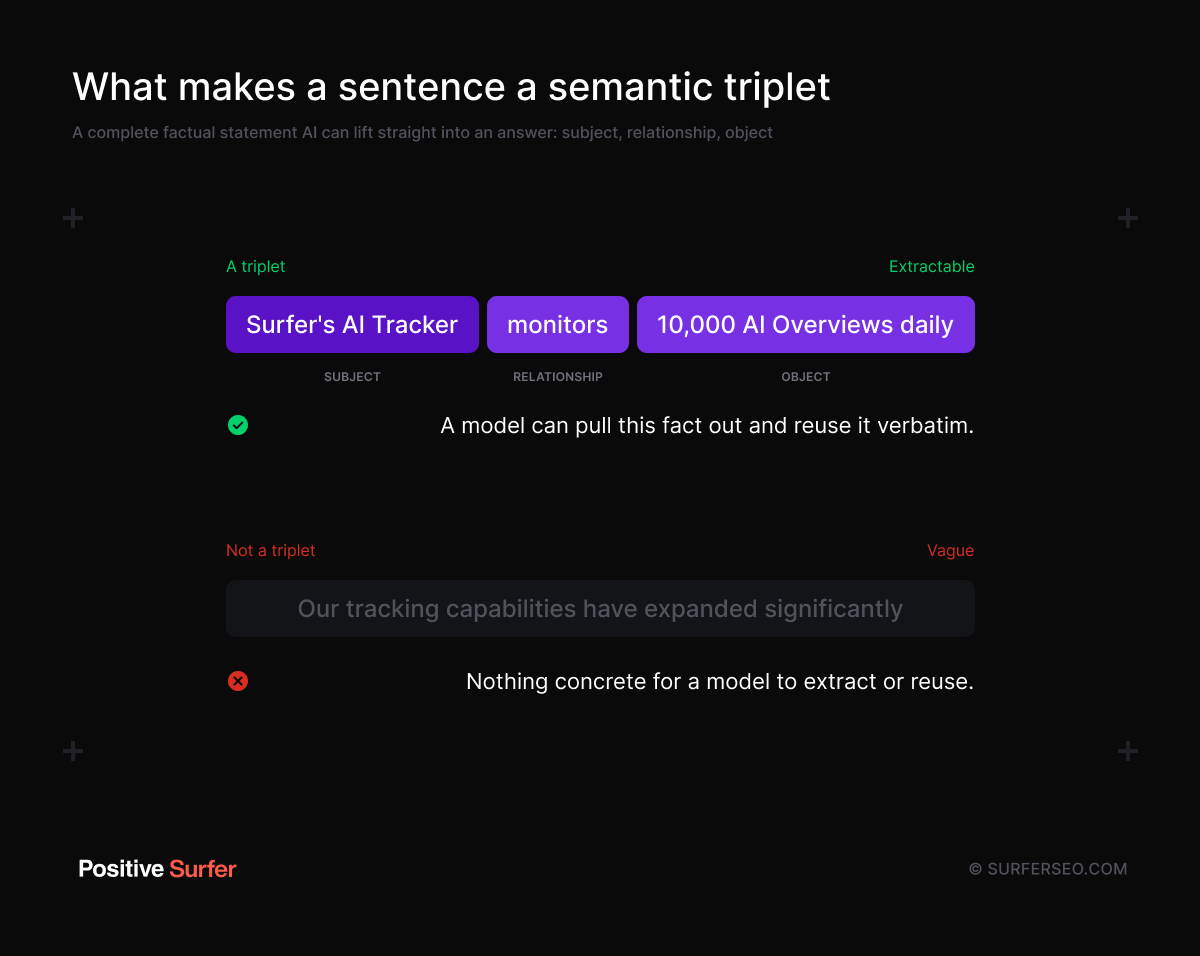
Un triplet sémantique est une affirmation factuelle simple et complète : sujet, relation, objet. « Le Suivi de visibilité IA de Surfer surveille 10 000 AI Overviews par jour » est un triplet. « Nos capacités de suivi se sont considérablement élargies » n’en est pas un : un modèle n’a rien à en extraire ni à réutiliser.
Un contenu fait d’affirmations claires et extractibles offre à un modèle d’IA une matière toute prête à citer. Un contenu fait d’une prose vague et autocentrée oblige le modèle à faire un travail d’assemblage, et comme nous l’avons vu dans l’étude sur l’emplacement des citations, les modèles n’aiment pas en faire plus.
Optimisez pour ChatGPT avec Surfer
L’éditeur de contenu de Surfer intègre désormais un Score de contenu SEO et IA qui réunit au même endroit les consignes SEO et celles de la recherche IA.
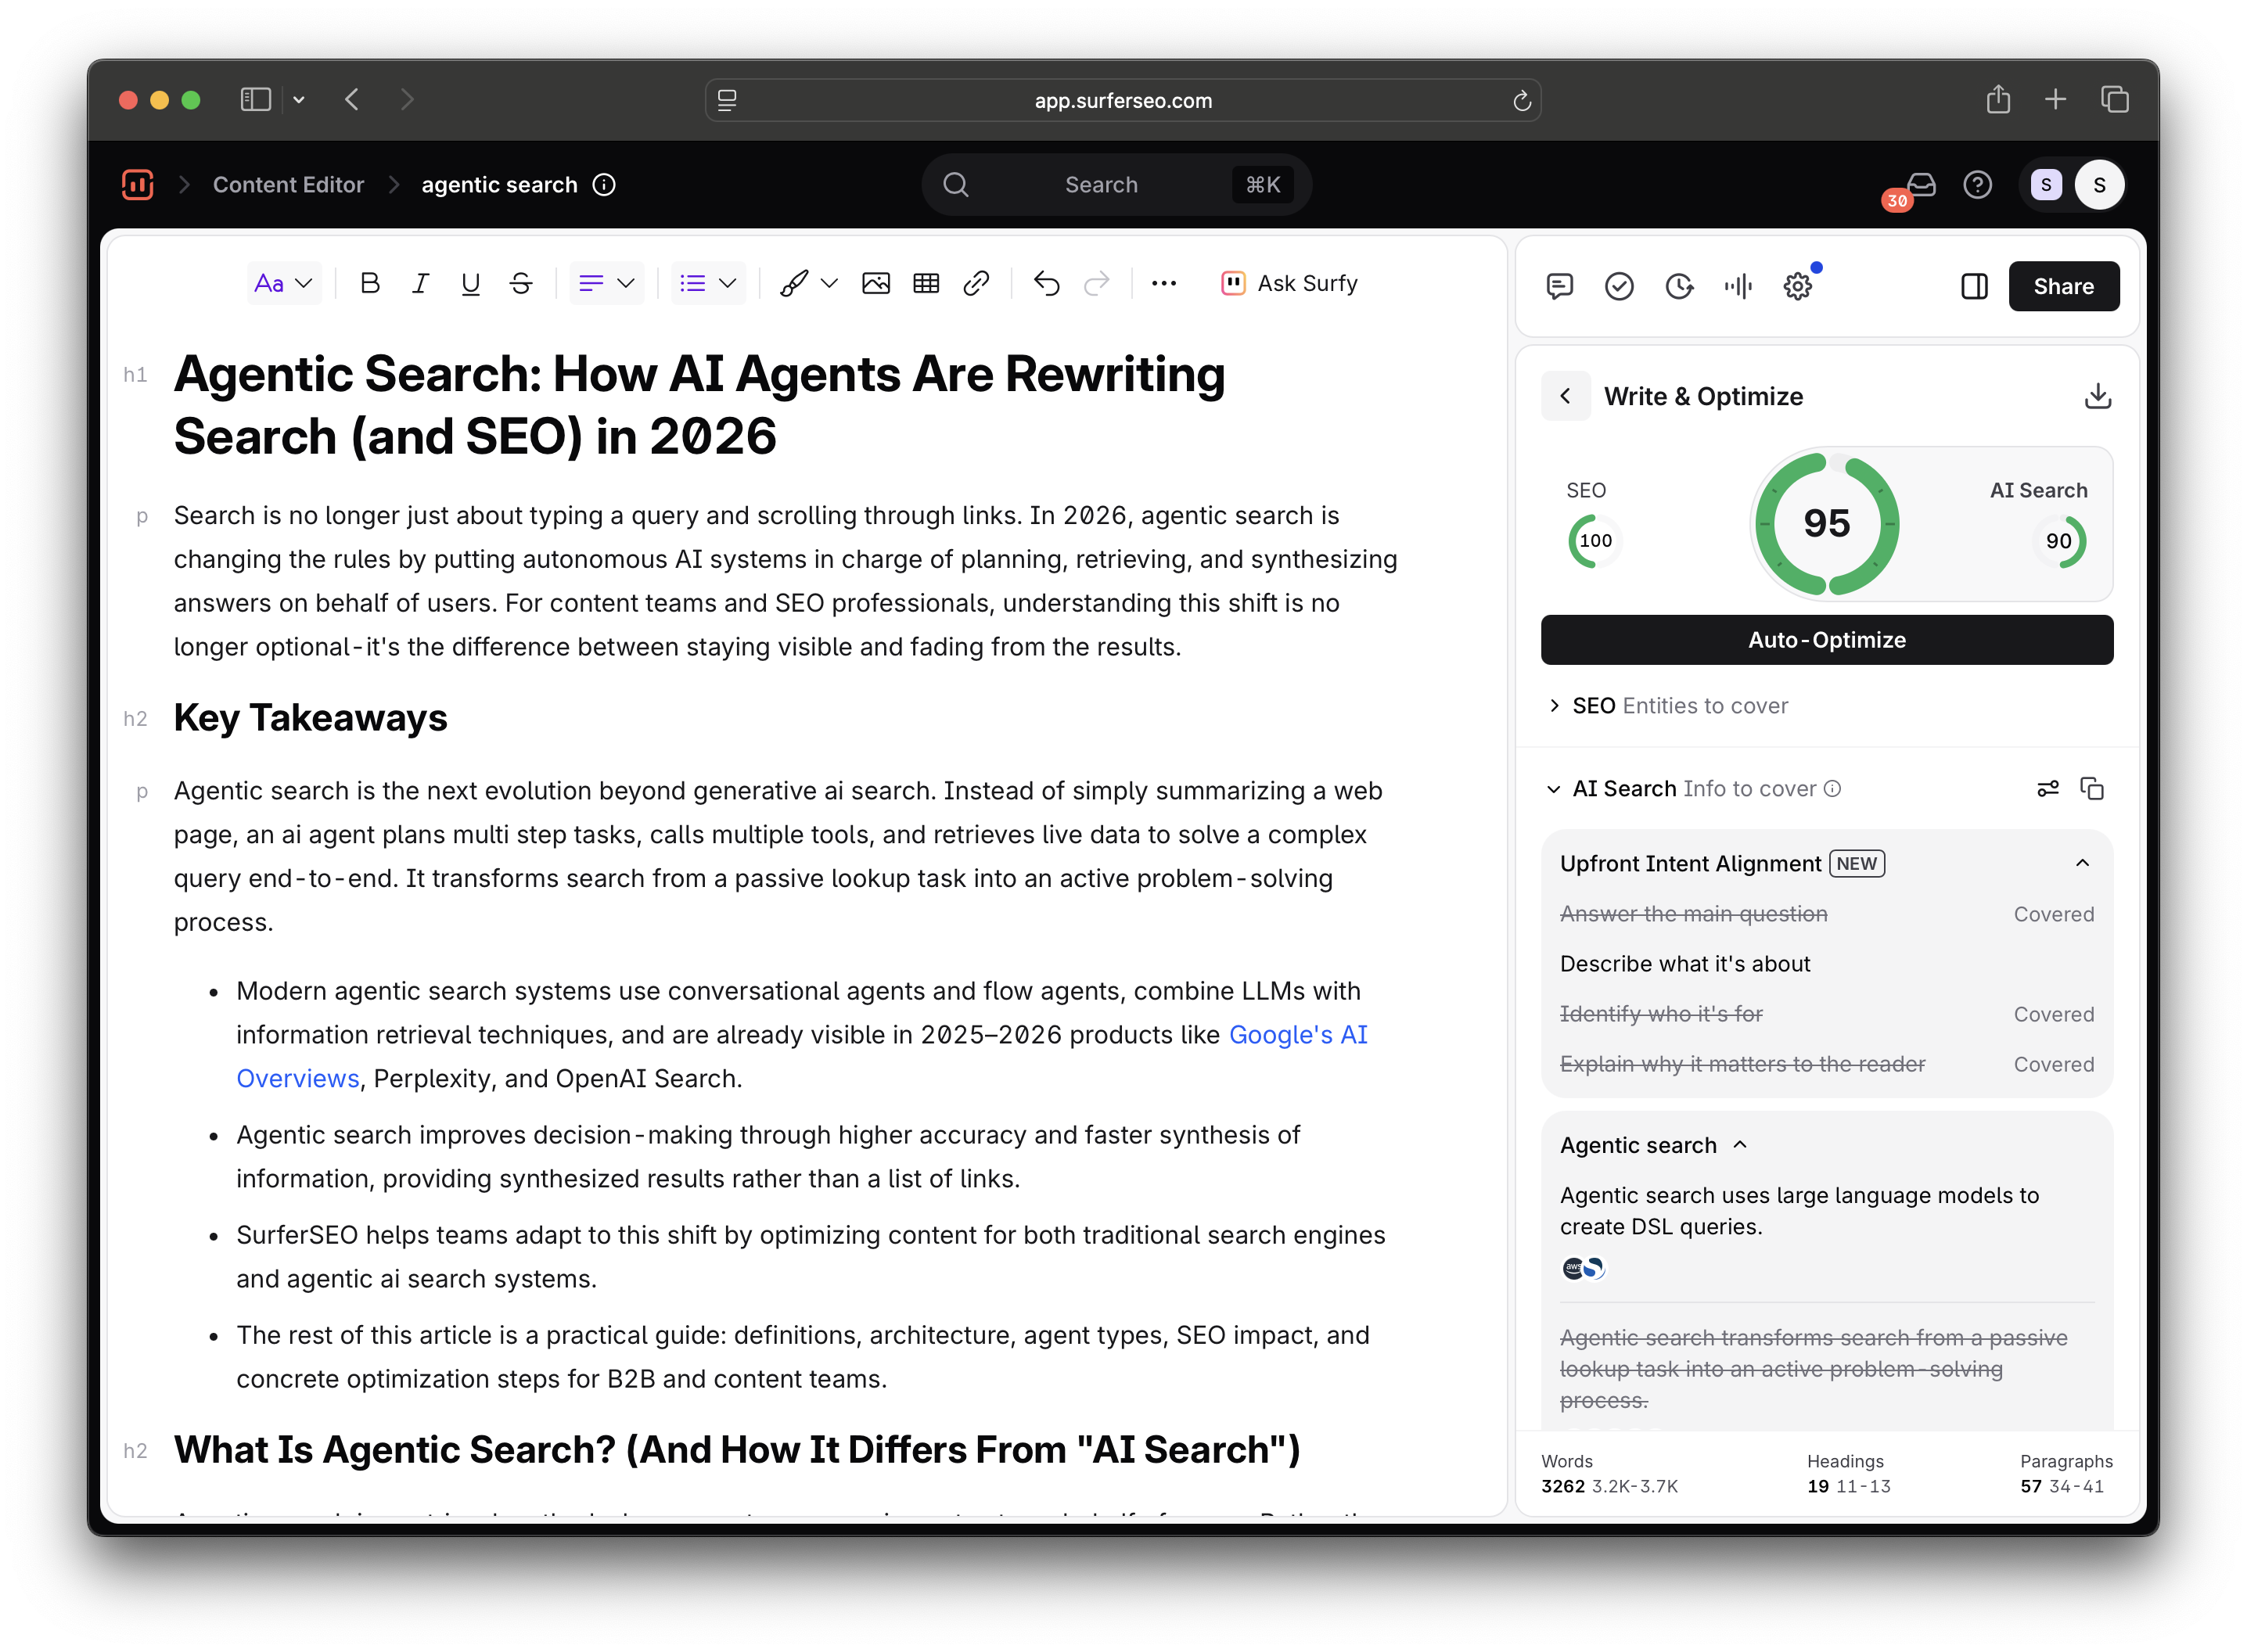
Au vu des chiffres de 2026, la consigne la plus importante pour ChatGPT est l’alignement avec l’intention dès l’introduction (Upfront Intent Alignment) : elle vérifie que votre premier paragraphe nomme le sujet dès la première phrase, inclut un ancrage factuel et donne la réponse avant de développer. Exactement ce que récompensent les trois nouveaux premiers critères de ChatGPT.
Les recommandations pour la recherche IA comprennent aussi les informations à citer issues de la recherche agentique (Agentic Search) : les faits précis que les modèles d’IA recherchent pour répondre aux questions de votre thématique. Plus votre contenu en couvre, plus vous avez de chances de devenir la source dans laquelle puisent les modèles.
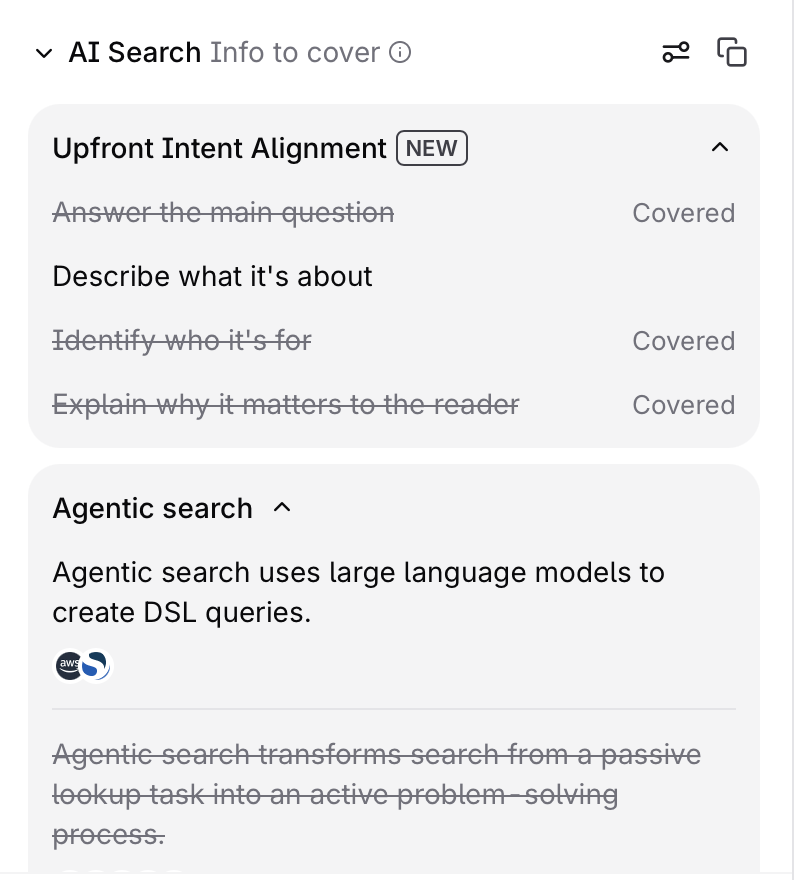
Vous pouvez passer en revue les deux séries de suggestions dans l’onglet des consignes de recherche IA et les appliquer une à une manuellement, demander à Surfy d’en traiter certaines dans votre ton, ou utiliser l’Auto-optimisation pour corriger vos consignes SEO et de recherche IA, réécriture de l’introduction comprise, en une seule passe (ma méthode préférée).
Et si vous générez vos contenus avec Surfer AI plutôt que de les écrire de zéro : il crée automatiquement des liens vers vos pages existantes les plus pertinentes et renvoie vers les sources externes qui étayent les affirmations de l’article généré.
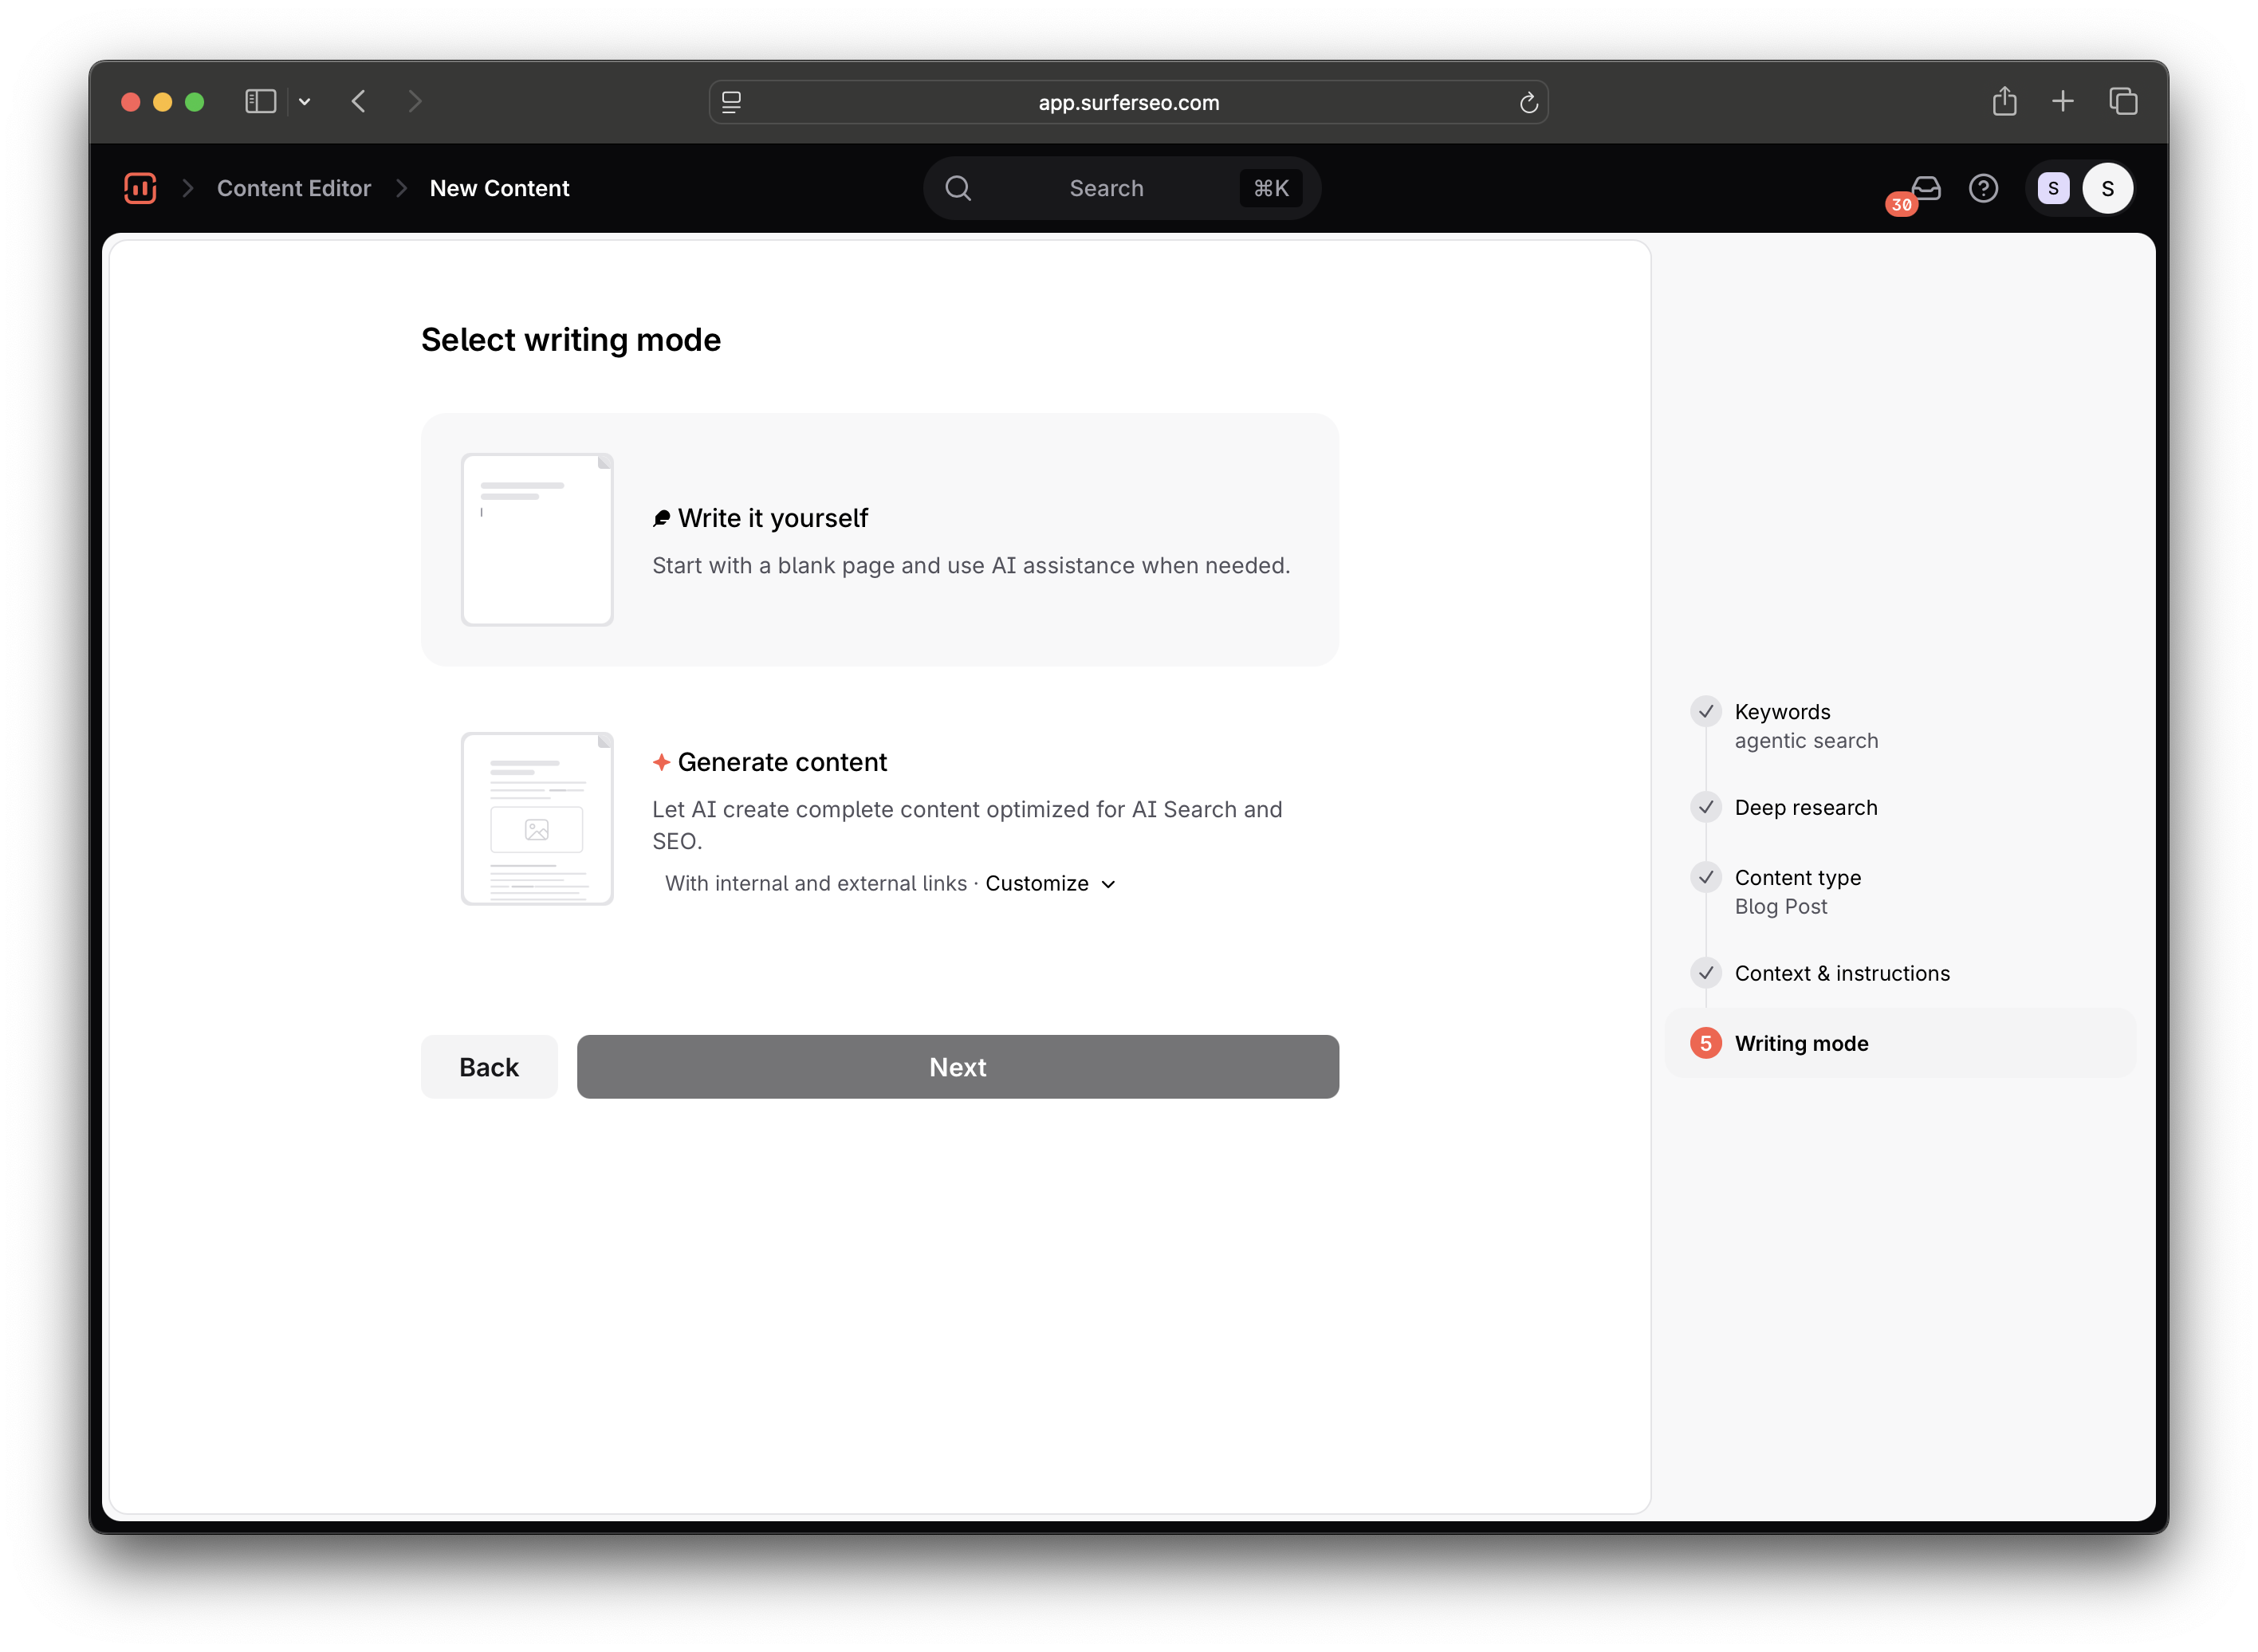
Les sources comptent moins pour ChatGPT qu’il y a un an, mais elles comptent toujours pour tous les autres modèles, et des affirmations extractibles et bien attribuées sont exactement ce que récompense le critère Semantic Triplets.
Deuxième étape : découvrez qui est cité à votre place
Rendez-vous dans le Suivi de visibilité IA et configurez des prompts organisés selon les thématiques que vous voulez suivre ; pour nous, ce sont par exemple la visibilité IA, les outils SEO pour l’IA et l’optimisation de contenu :
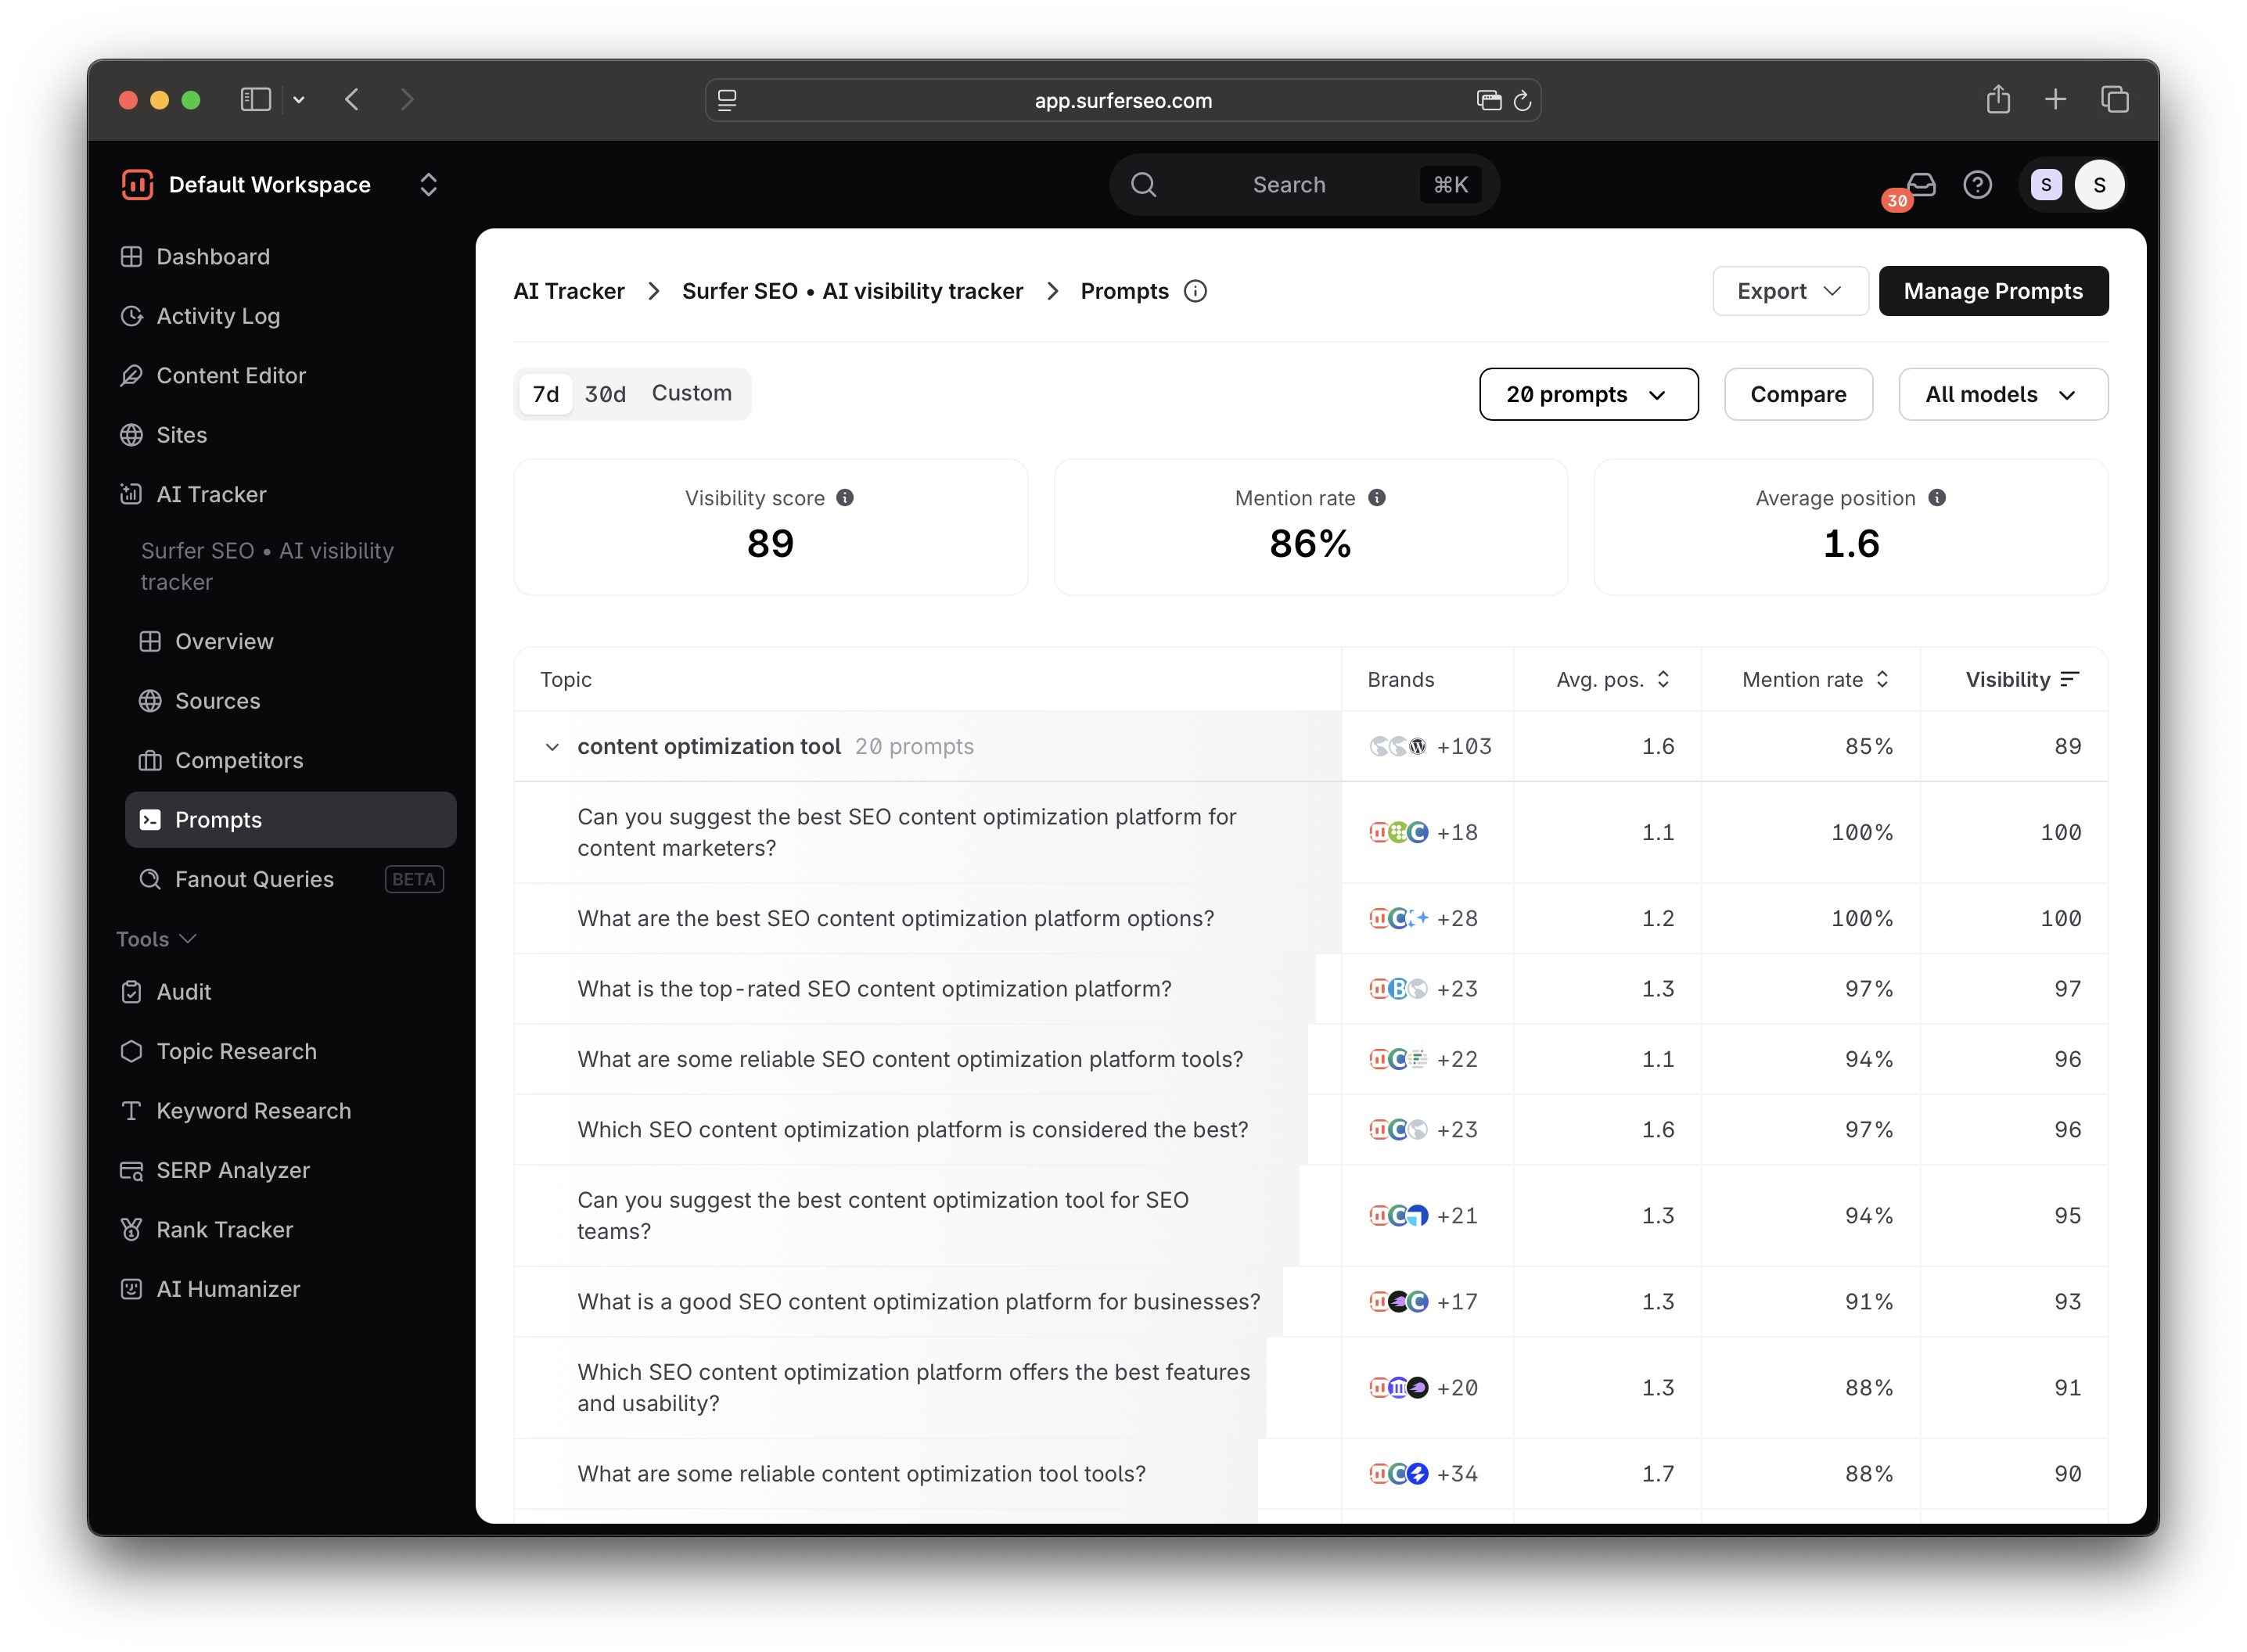
Vous voyez ainsi qui est actuellement cité pour les questions les plus importantes que vos acheteurs posent sur votre niche. Chaque réponse entre dans l’une de trois catégories : vous, vos concurrents, ou des contenus tiers dans lesquels vous pourriez figurer.
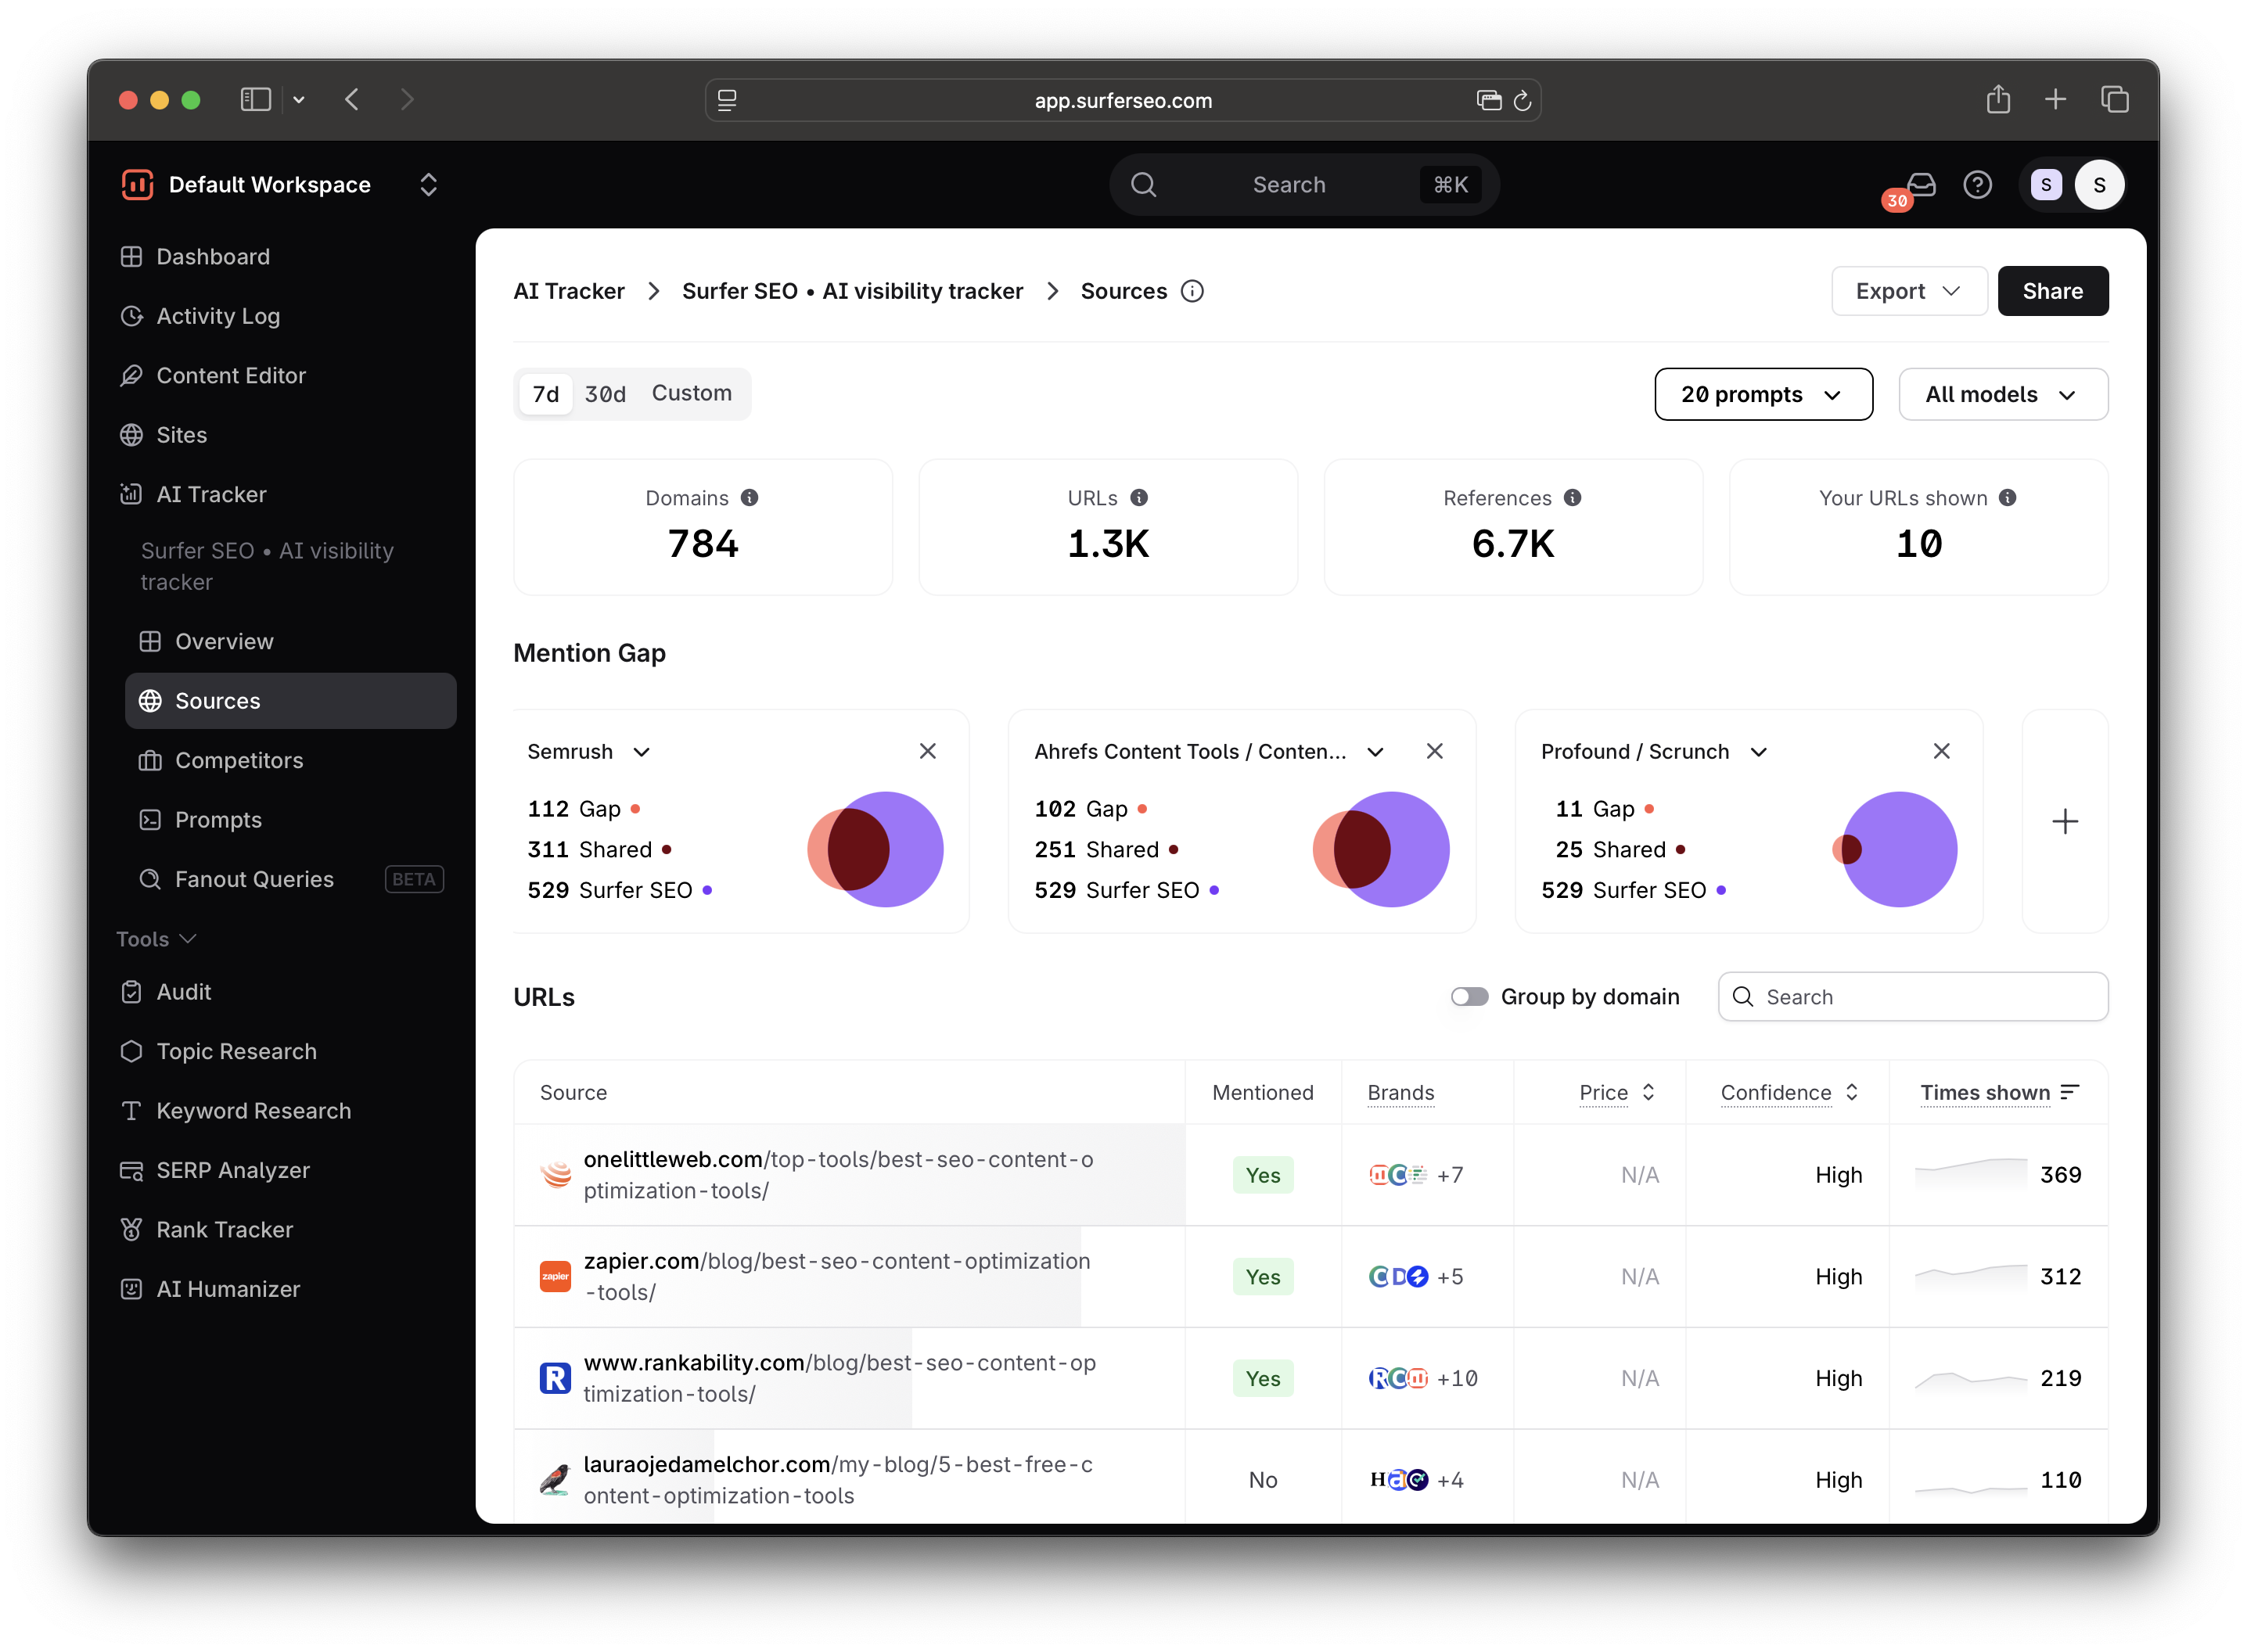
C’est généralement dans cette troisième catégorie que se trouve l’opportunité : les articles tiers et les pages comparatives constituent une présence hors site que vous pouvez obtenir sans devancer qui que ce soit dans le classement.
Votre objectif à partir de là : être mentionné dans le plus grand nombre possible des principales sources, le plus haut possible s’il s’agit d’un article de liste, et toujours sous un jour favorable.
La manière d’y parvenir dépend de votre temps et de votre budget. Si vous manquez de temps mais disposez d’un budget pour la visibilité IA, utilisez les insertions payantes : chaque fois qu’une source est couverte par l’un de nos fournisseurs de backlinks actuels, vous verrez un prix et une option pour acheter l’emplacement directement dans le Suivi de visibilité IA.
Sinon, ou pour les sources que nos fournisseurs ne couvrent pas, je recommande une approche plus personnalisée : la prospection. Personnalisez votre message, proposez quelque chose en échange (un échange de contenu unique, des données introuvables ailleurs, ou de l’argent) et écrivez comme un humain. Vous demandez à quelqu’un de prendre sur son temps pour modifier un article publié et vous y ajouter. Vos chances augmentent considérablement quand votre demande ne ressemble pas aux deux cents autres emails types reçus cette semaine-là.
Une dernière chose pendant que vous êtes dans le Suivi de visibilité IA : consultez l’onglet des requêtes dérivées.
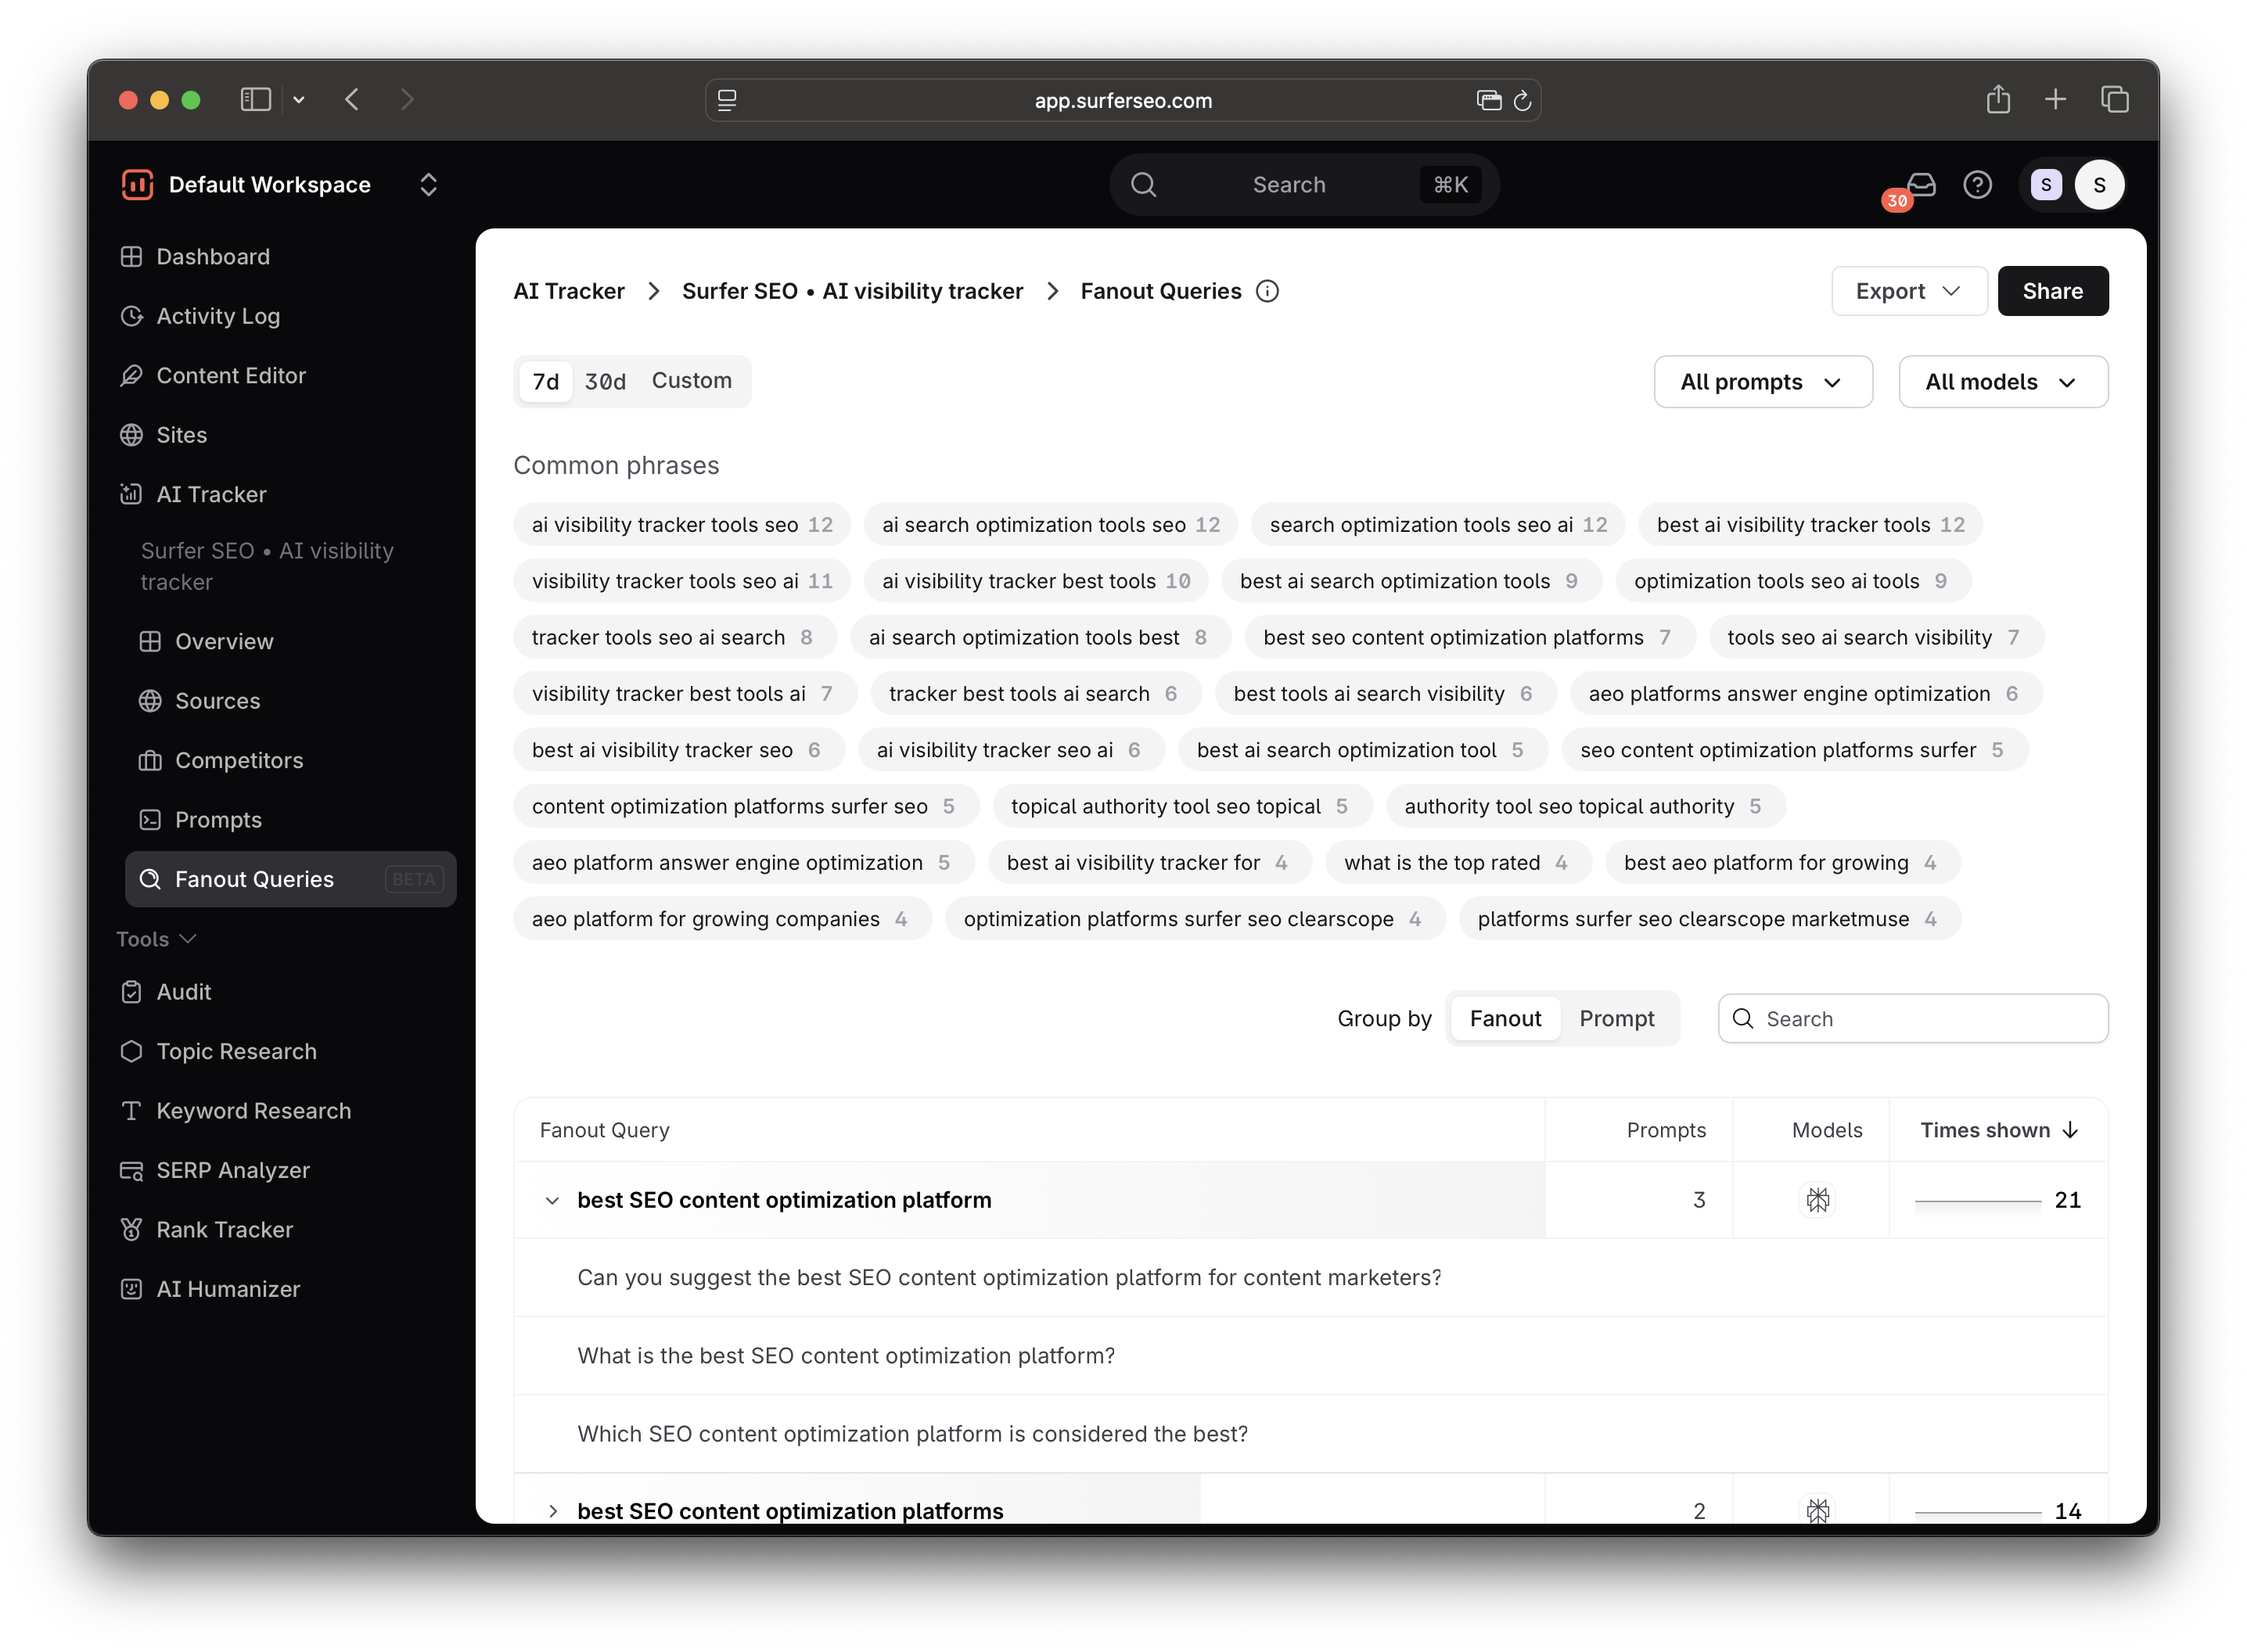
Les modèles d’IA ne répondent pas aux questions de vos acheteurs à partir d’une seule requête : ils lancent discrètement plusieurs recherches connexes et en assemblent les résultats. L’onglet des requêtes dérivées vous montre ces requêtes connexes, qui vous servent de carte pour étoffer vos clusters de contenus autour des thèmes principaux que vous suivez. Si vous voulez aller au-delà du suivi de qui est cité et devenir vous-même la source, ce sont les prompts auxquels votre blog devrait répondre directement.
Données : plus de 650 000 réponses générées par l’IA, issues des interfaces utilisateur réelles et non des réponses de l’API (nous avons expliqué pourquoi cette distinction compte ici). Chaque source citée a été évaluée selon une grille de 20 critères de contenu sur ChatGPT, Google AI Overviews, AI Mode et Perplexity, lors de deux campagnes de collecte : octobre 2025 et avril 2026. Analyse : Michał Suski, responsable de l’innovation et cofondateur de Positive Surfer, et Maciej Gruszczyński, data scientist chez Positive Surfer.
Il s’agit de données corrélationnelles : nous pouvons montrer à quoi ressemble un contenu cité par ChatGPT, et comment cela a évolué d’une campagne à l’autre, pas expliquer de façon définitive pourquoi il est choisi plutôt qu’un autre.
Une étude plus vaste est en préparation pour rassembler tout cela : notre approche complète, et ce qui a changé au fil du temps. Les éléments actionnables passent en premier, parce que c’est dans cet ordre qu’ils vous sont utiles ;)