Les outils de suivi de la visibilité IA obtiennent leurs données soit via des API commercialisées, soit en extrayant (scraping) les vrais résultats affichés par les LLM. Chez Surfer, nous avons choisi la seconde option. Et nous savons que c’est la seule bonne approche.
Le scraping est le seul moyen de vous donner des recommandations qui reflètent ce que voient vos acheteurs lorsqu’ils utilisent la recherche IA. Car les données d’API et les données extraites des interfaces diffèrent énormément. Le recoupement n’est que de 30 % au mieux. Et dans bien des cas, il est encore plus faible.
Nous avons les données pour le prouver. Nous avons soumis 1 000 prompts à cinq produits d’IA selon deux méthodes : une fois en extrayant les interfaces que voient les vrais utilisateurs, une fois via une API. Nous avons recueilli 13 779 réponses sur 14 combinaisons de modèle et de méthode, et analysé les aspects suivants : marques, sources et pages citées, ainsi que la longueur des réponses.
(Une précision : la méthode API d’AI Overviews est empruntée à AI Mode. D’après la documentation de Google, AI Overviews fonctionne avec Gemini 3, et aucun modèle de ce type n’est commercialisé. Les barres correspondantes sont grisées dans les graphiques ci-dessous.)
Tous les produits d’IA ne suivent pas le même schéma, mais les écarts sont assez importants pour prouver qu’aucune API ne reproduit ce qu’affiche le produit grand public.
Entrons dans le détail !
Avant tout : comment collecter des données à partir des modèles d’IA ?
Si vous connaissez déjà la différence générale entre les API et le scraping pour obtenir un enregistrement exploitable par machine des réponses de l’IA, passez directement à la section suivante.
Mais si, après l’introduction, vous vous êtes dit « Bon, de quoi parlent-ils au juste ? », voici un bref aperçu du fonctionnement de chaque méthode et de son importance pour le suivi de la visibilité IA.
Extraire les données de l’interface grand public
Le web scraping recueille exactement les réponses que les utilisateurs obtiennent lorsqu’ils font une recherche dans l’interface de ChatGPT ou de Perplexity. Le logiciel de scraping ouvre un chatbot, soumet un prompt, puis analyse le texte, les mentions de marques et les liens cités. Les informations obtenues intègrent donc toute la récupération, le classement, le filtrage de sécurité, la personnalisation et le raccourcissement des réponses que ces produits appliquent pour leurs utilisateurs directs.
À bien des égards, les scrapers sont plus difficiles et plus coûteux à maintenir. Les interfaces changent, l’affichage est lent par rapport à un appel d’API, et le scraper doit être mis à jour au rythme des évolutions de l’interface. Mais l’avantage d’obtenir exactement ce que voit l’utilisateur est difficile à égaler.
L’API
La collecte de données par API offre un accès structuré et programmatique via des endpoints officiels.
Chacun des LLM étudiés propose un accès par API à un modèle proche de celui qui fait tourner le produit. Mais tout est dans ce « proche ». Vous n’obtenez que le modèle brut. Vous n’avez ni la logique de l’interface, ni le comportement de recherche, ni les sources, ni aucune des autres personnalisations que les plateformes appliquent sans vouloir les rendre publiques.
Alors oui, les API sont pratiques pour développer des produits, car elles fournissent aux développeurs des réponses propres et prêtes à intégrer. Mais elles le sont beaucoup moins pour les utilisateurs finaux des outils de suivi IA, qui veulent être sûrs à 100 % de suivre exactement ce que voient les lecteurs, et non des approximations.
Les différences entre réponses de LLM extraites et résultats d’API : les résultats de 13 779 réponses
Surfer fonctionne avec des données extraites des interfaces : nous refaisons donc régulièrement cette étude comparative pour nous assurer que notre approche tient la route.
L’an dernier, nous n’avions étudié les API et les interfaces extraites que pour ChatGPT et Perplexity. Nous avions constaté des différences sur… eh bien, presque tout ce qui compte dans le suivi de la visibilité IA : marques et sources mentionnées, nombre de citations, longueur des réponses.
Cette année, nous avons ajouté AI Overviews, AI Mode et Gemini pour vérifier si ces conclusions tiennent toujours, et mesurer l’ampleur des écarts.
Comment avons-nous mené l’étude ? Nous avons mesuré chaque modèle deux fois : une fois via le produit grand public extrait, une fois via une API. Nous avons recueilli des réponses d’IA de 9 façons différentes, soit 13 779 réponses au total.
Nous les avons comparées selon les critères suivants :
- Citent-elles les mêmes marques, et le même nombre de marques ?
- Les réponses ont-elles la même longueur ?
- Citent-elles les mêmes sources, et le même nombre de sources ?
Voyons les résultats en détail. Nous avons aussi ajouté un bref résumé pour vous aider à lire nos conclusions, c’est-à-dire ce que nos tableaux de chiffres signifient concrètement pour votre suivi IA.
Les listes de marques des deux méthodes se recoupent à peine (même après nettoyage des noms)
Pour chaque prompt, nous avons pris l’ensemble des marques citées par chaque canal et calculé l’indice de Jaccard (une mesure statistique qui quantifie la similarité entre deux ensembles) entre l’ensemble issu de l’API et celui issu du scraping. Nous avons fait les tests sur les résultats bruts, puis après normalisation des noms (pour que « SurferSEO », « Surfer SEO » et « Surferseo » comptent comme une seule entreprise, par exemple).
Les marques mentionnées ne se recoupaient qu’à hauteur de 15,5 % à 23,8 %. La normalisation a fait monter le recoupement, mais les chiffres ne dépassaient toujours pas 21,3 % à 31,6 %.
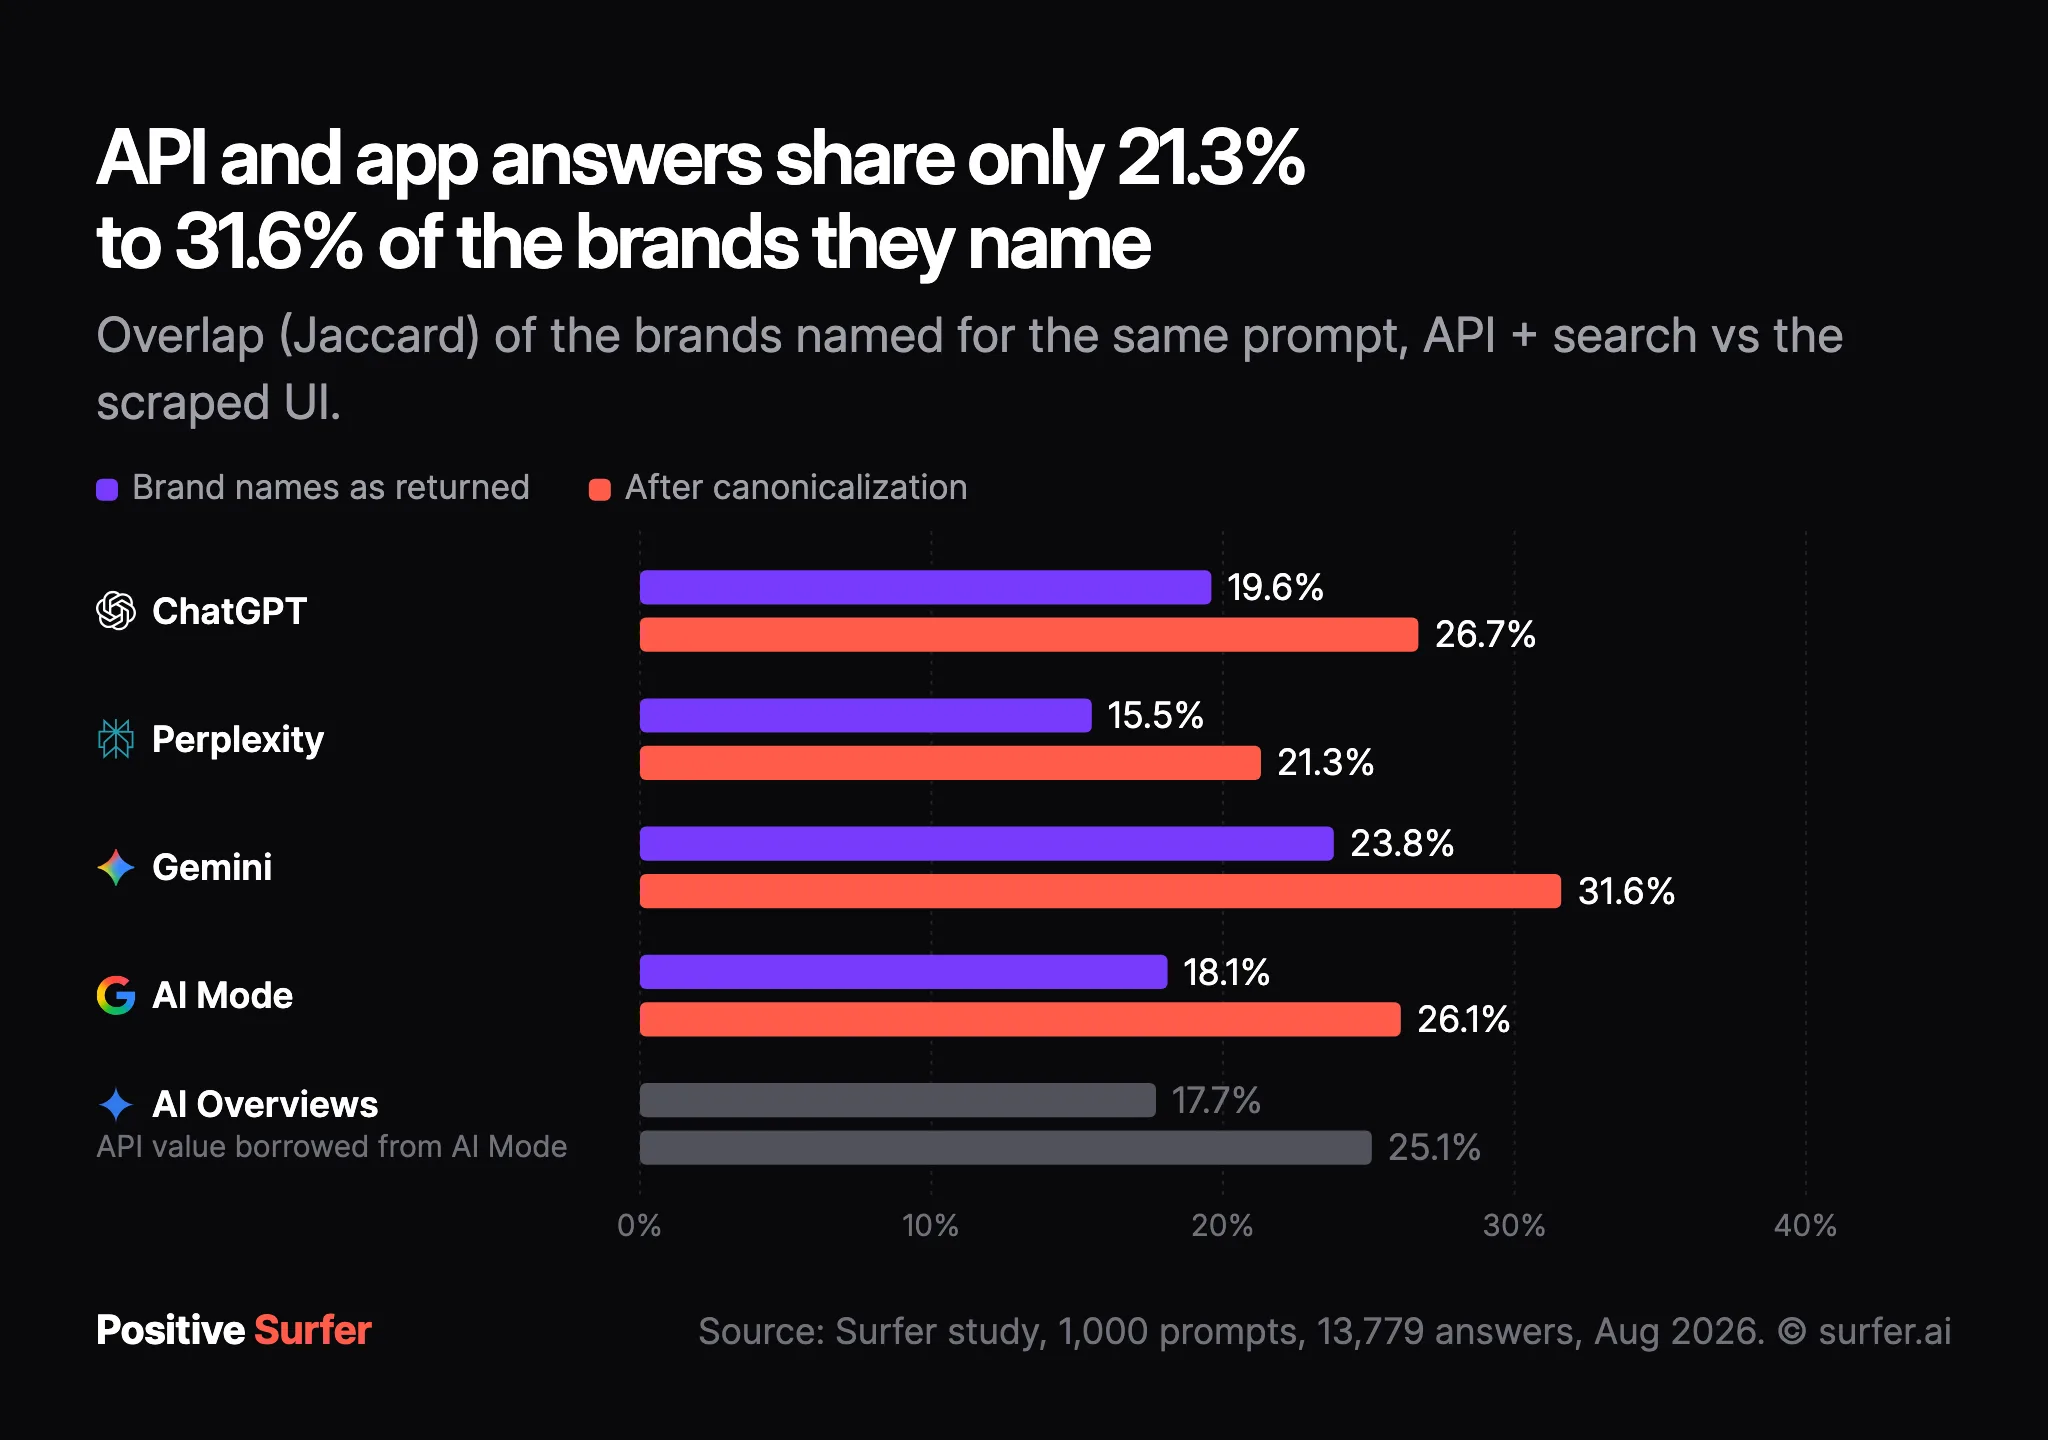
Gemini présente le plus haut niveau de similarité, mais cela ne représente que 3 marques sur 10 en commun. Perplexity atteint au maximum 21,3 % de recoupement.
Ce que cela signifie pour votre suivi de la visibilité IA : si vous mesurez la part de voix d’une marque à partir de données d’API, vous n’avez qu’environ 25 % de chances que votre rapport corresponde à ce que voit votre acheteur. C’est trop peu pour être sûr de vraiment dominer les recherches (ou d’en être absent).
Les API mentionnent plus de marques
L’API cite plus de marques que l’interface extraite, sur les cinq produits.
ChatGPT est le cas extrême, avec pas moins de 13,8 marques par réponse via l’API, contre seulement 7,9 dans l’interface standard. AI Overviews affiche aussi près de deux fois plus de réponses. Gemini et AI Mode sont proches de la parité, à 1,10 et 1,06 fois respectivement.
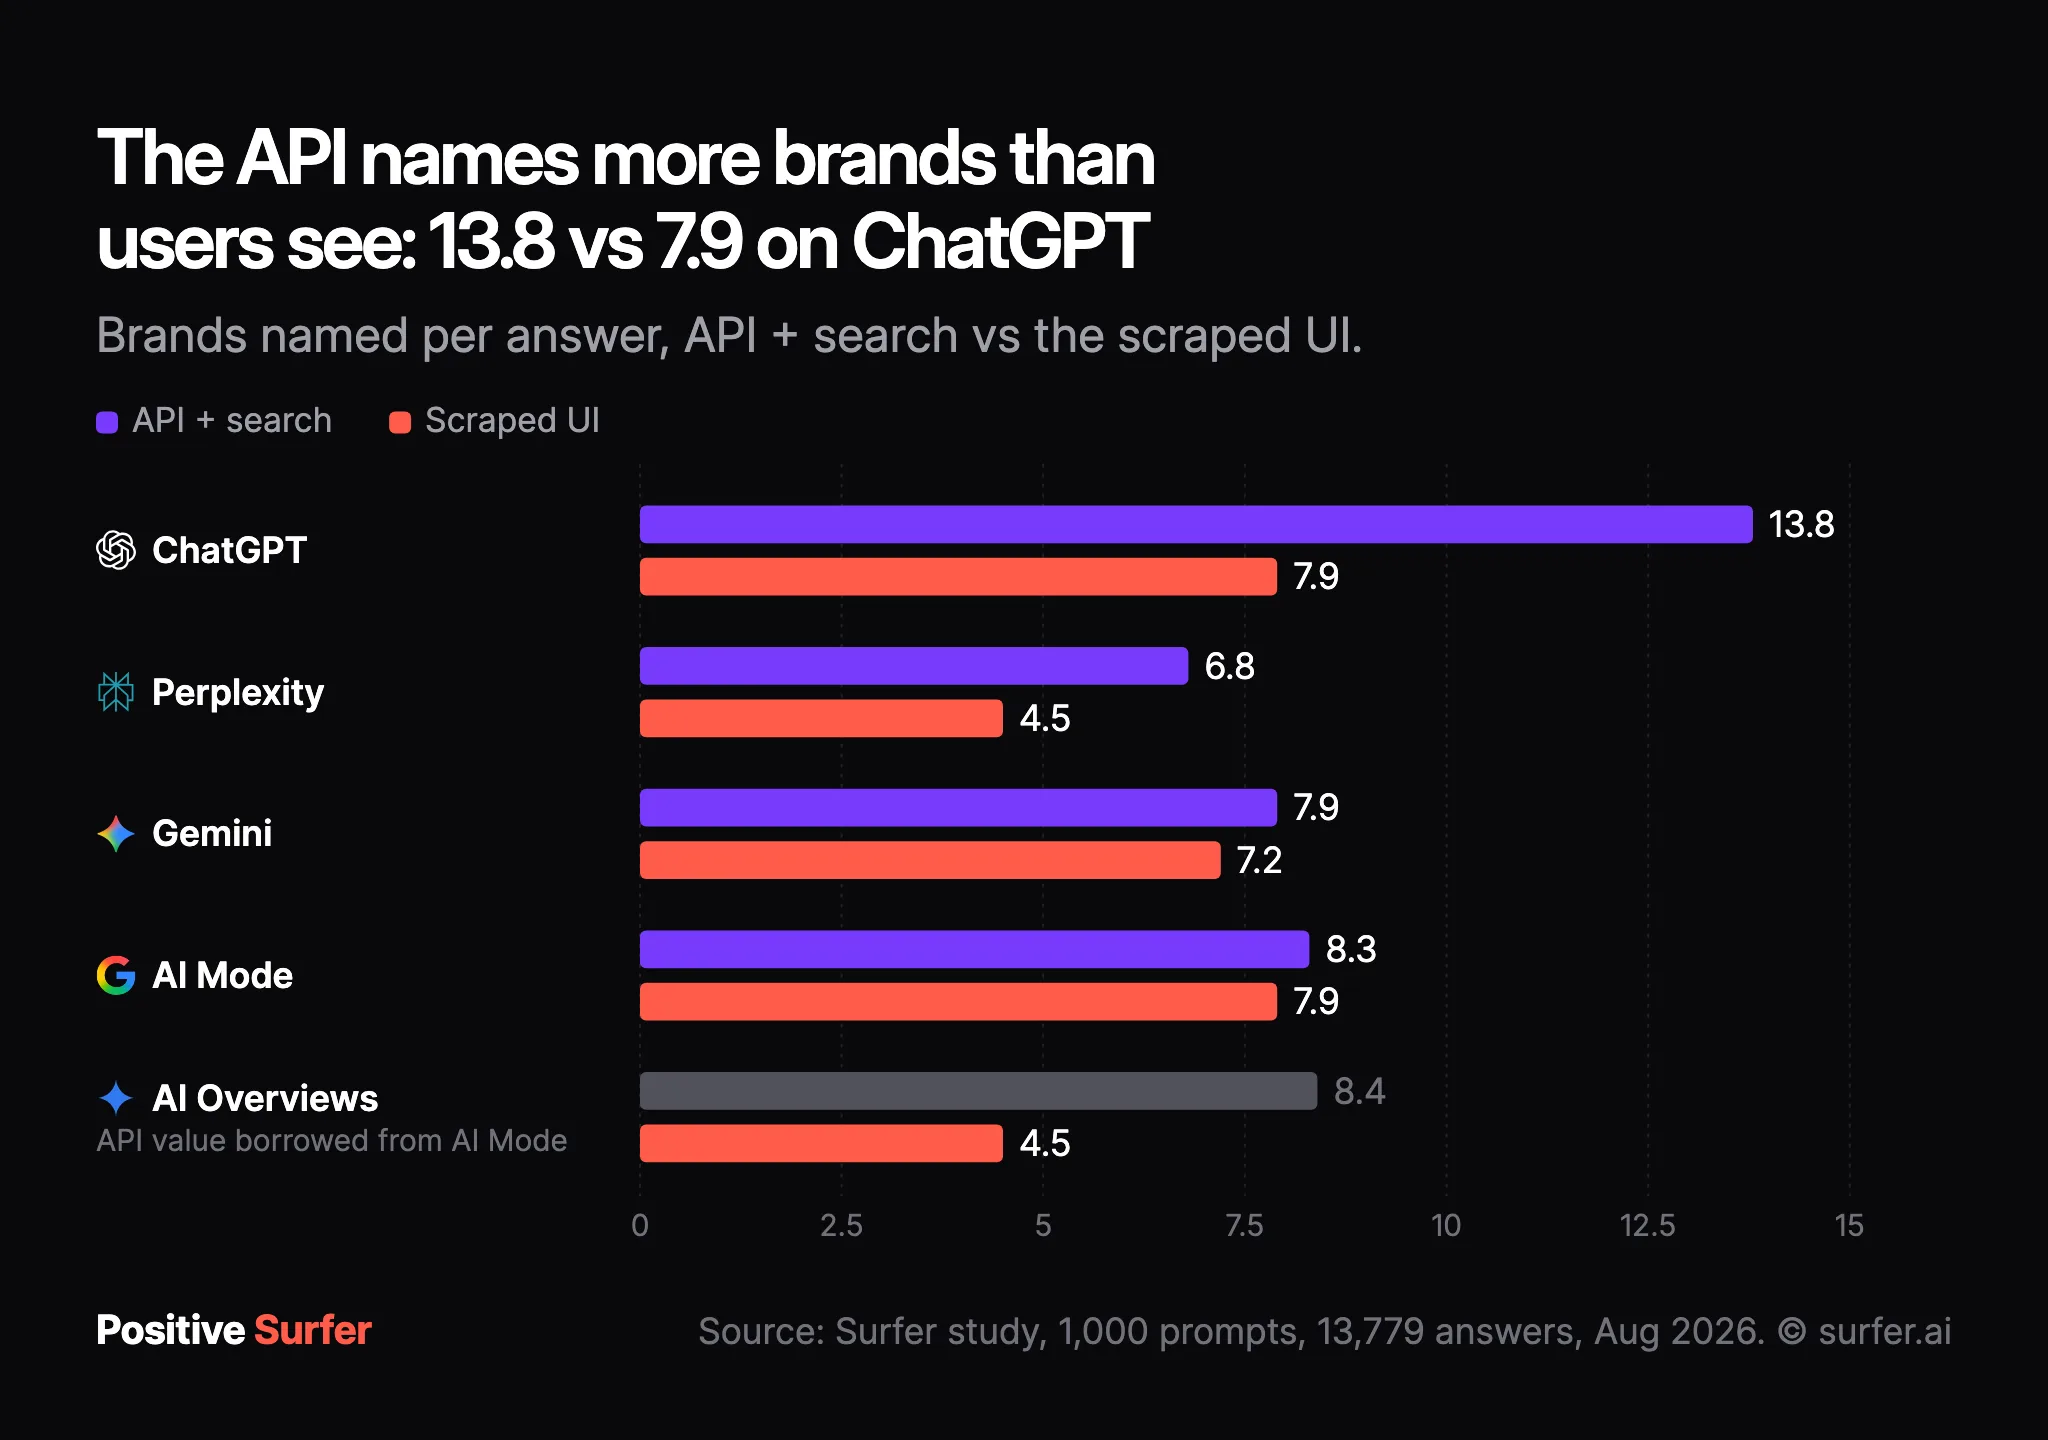
Ce que cela signifie pour votre suivi de la visibilité IA : un suivi basé sur l’API surestimera le nombre de marques retenues. Cette mention que vous voyez dans vos rapports ? Elle n’apparaît peut-être chez aucun de vos acheteurs.
La plupart des réponses d’API sont bien plus longues (mais c’est l’inverse pour Perplexity)
La plupart des réponses des API sont plus longues que celles des produits grand public. L’API de ChatGPT écrit 2,05 fois plus de mots que ce que ChatGPT montre à ses utilisateurs. Pour Gemini, le rapport est de 1,27, et pour AI Mode de 1,06. Perplexity fait exception : les réponses de son API sont légèrement plus courtes que celles de l’interface grand public.
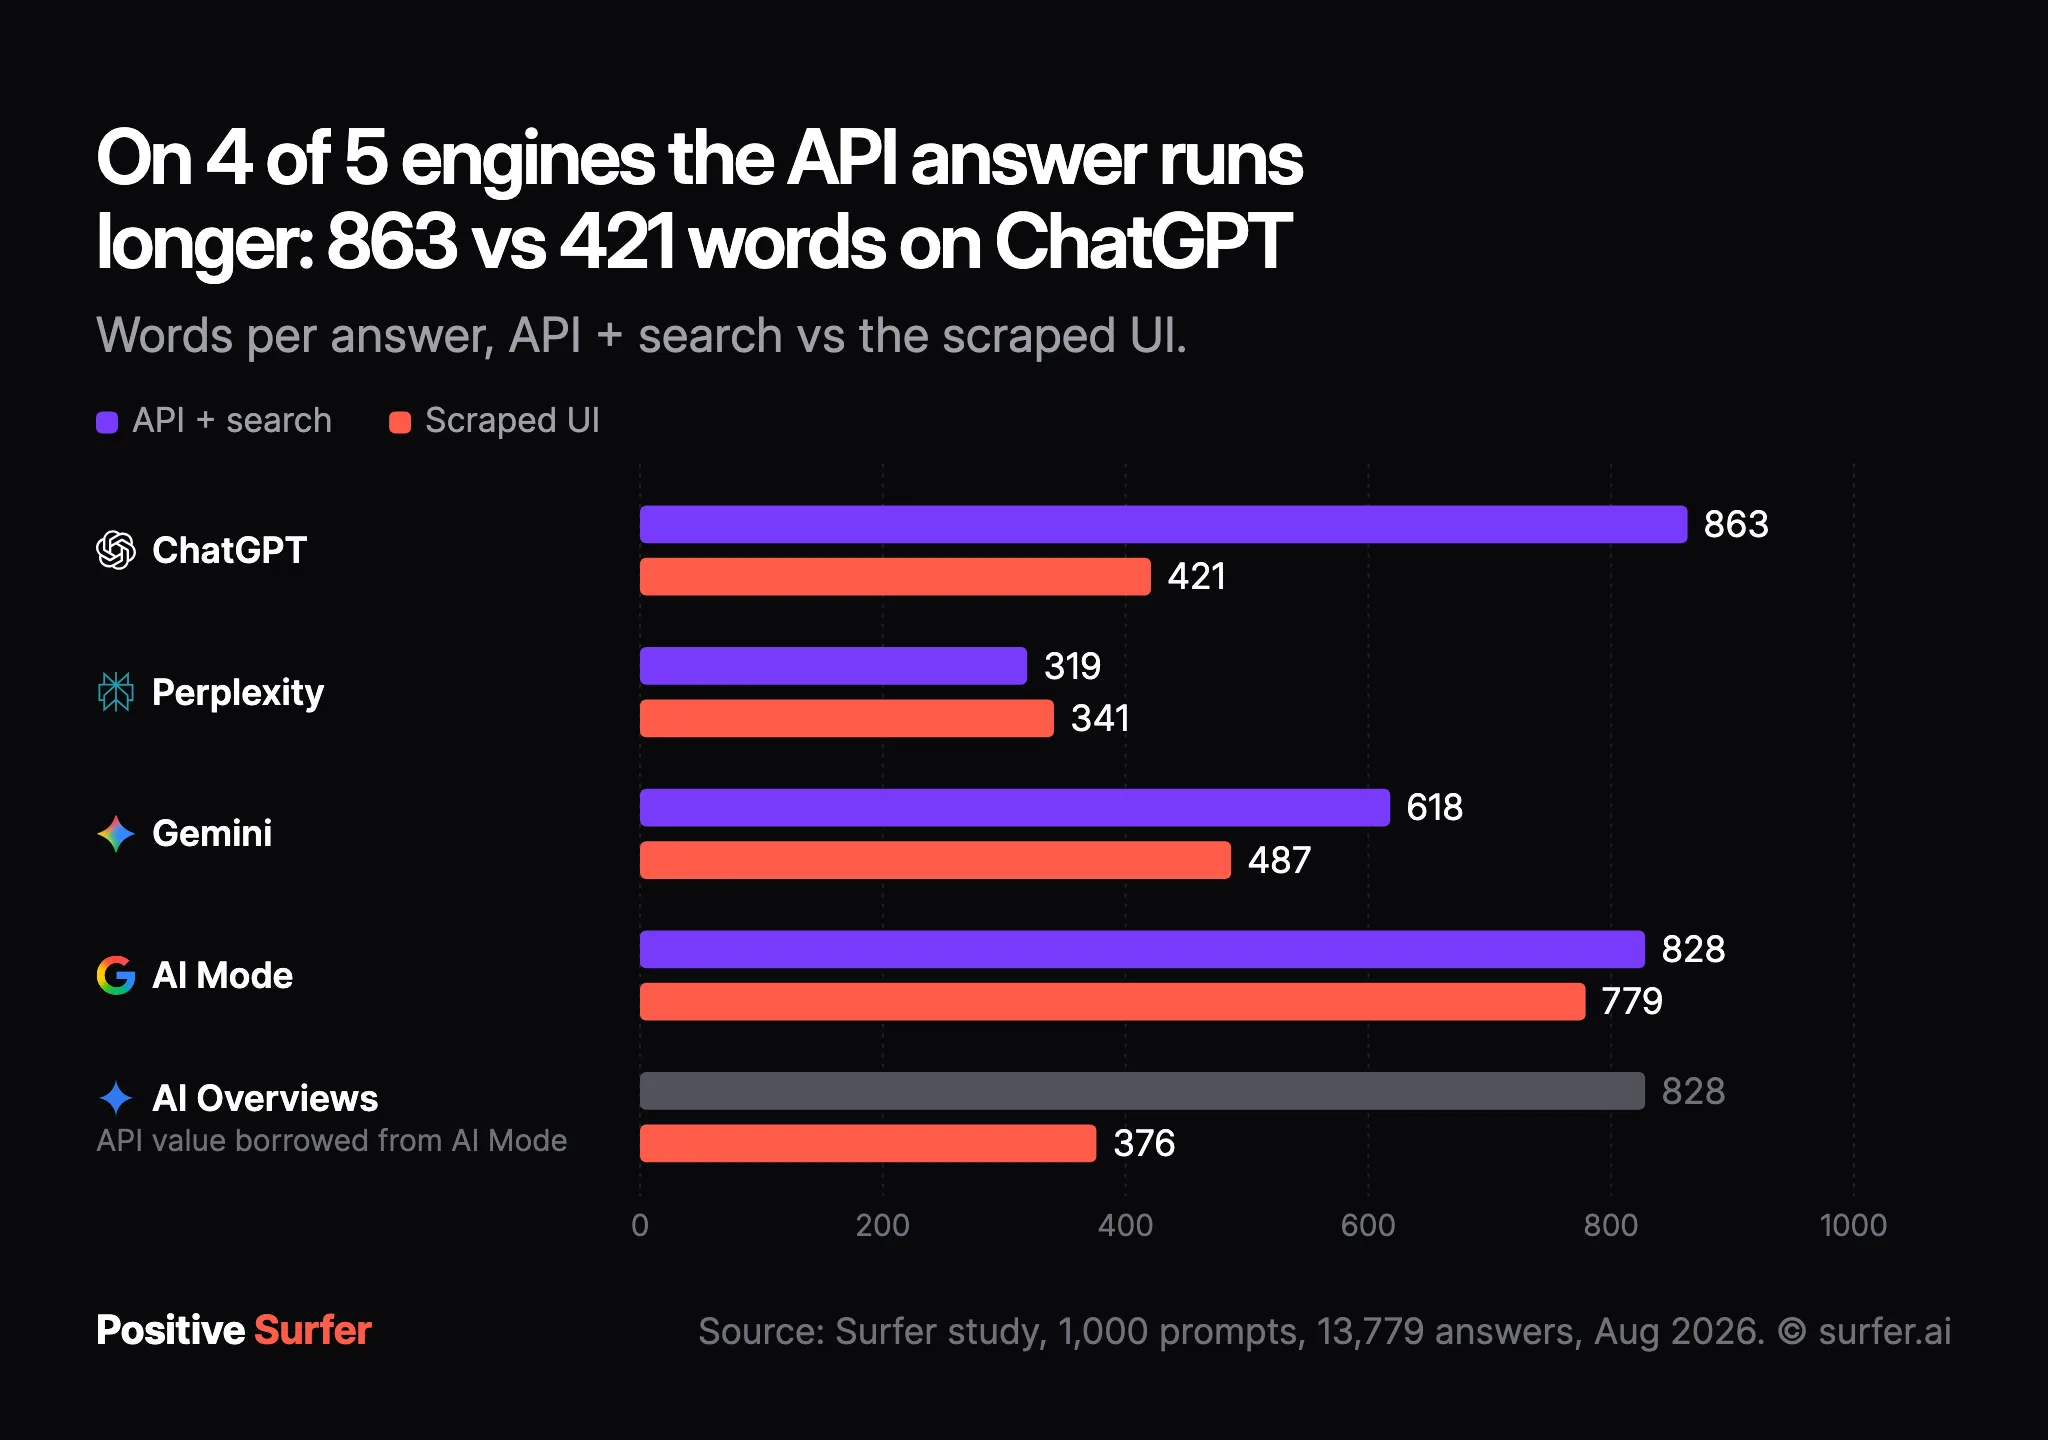
Ce que cela signifie pour votre suivi de la visibilité IA : si la réponse que voit le client est plus courte, c’est qu’elle a écarté une partie du contenu que l’API a conservé. Et il peut très bien s’agir de votre propre source. Même pour Perplexity, où la tendance est inversée, l’écart demeure : vos clients voient peut-être déjà votre marque, mais votre outil ne le signalera jamais.
Pour les sources citées par réponse, tout dépend du modèle (mais le recoupement reste faible)
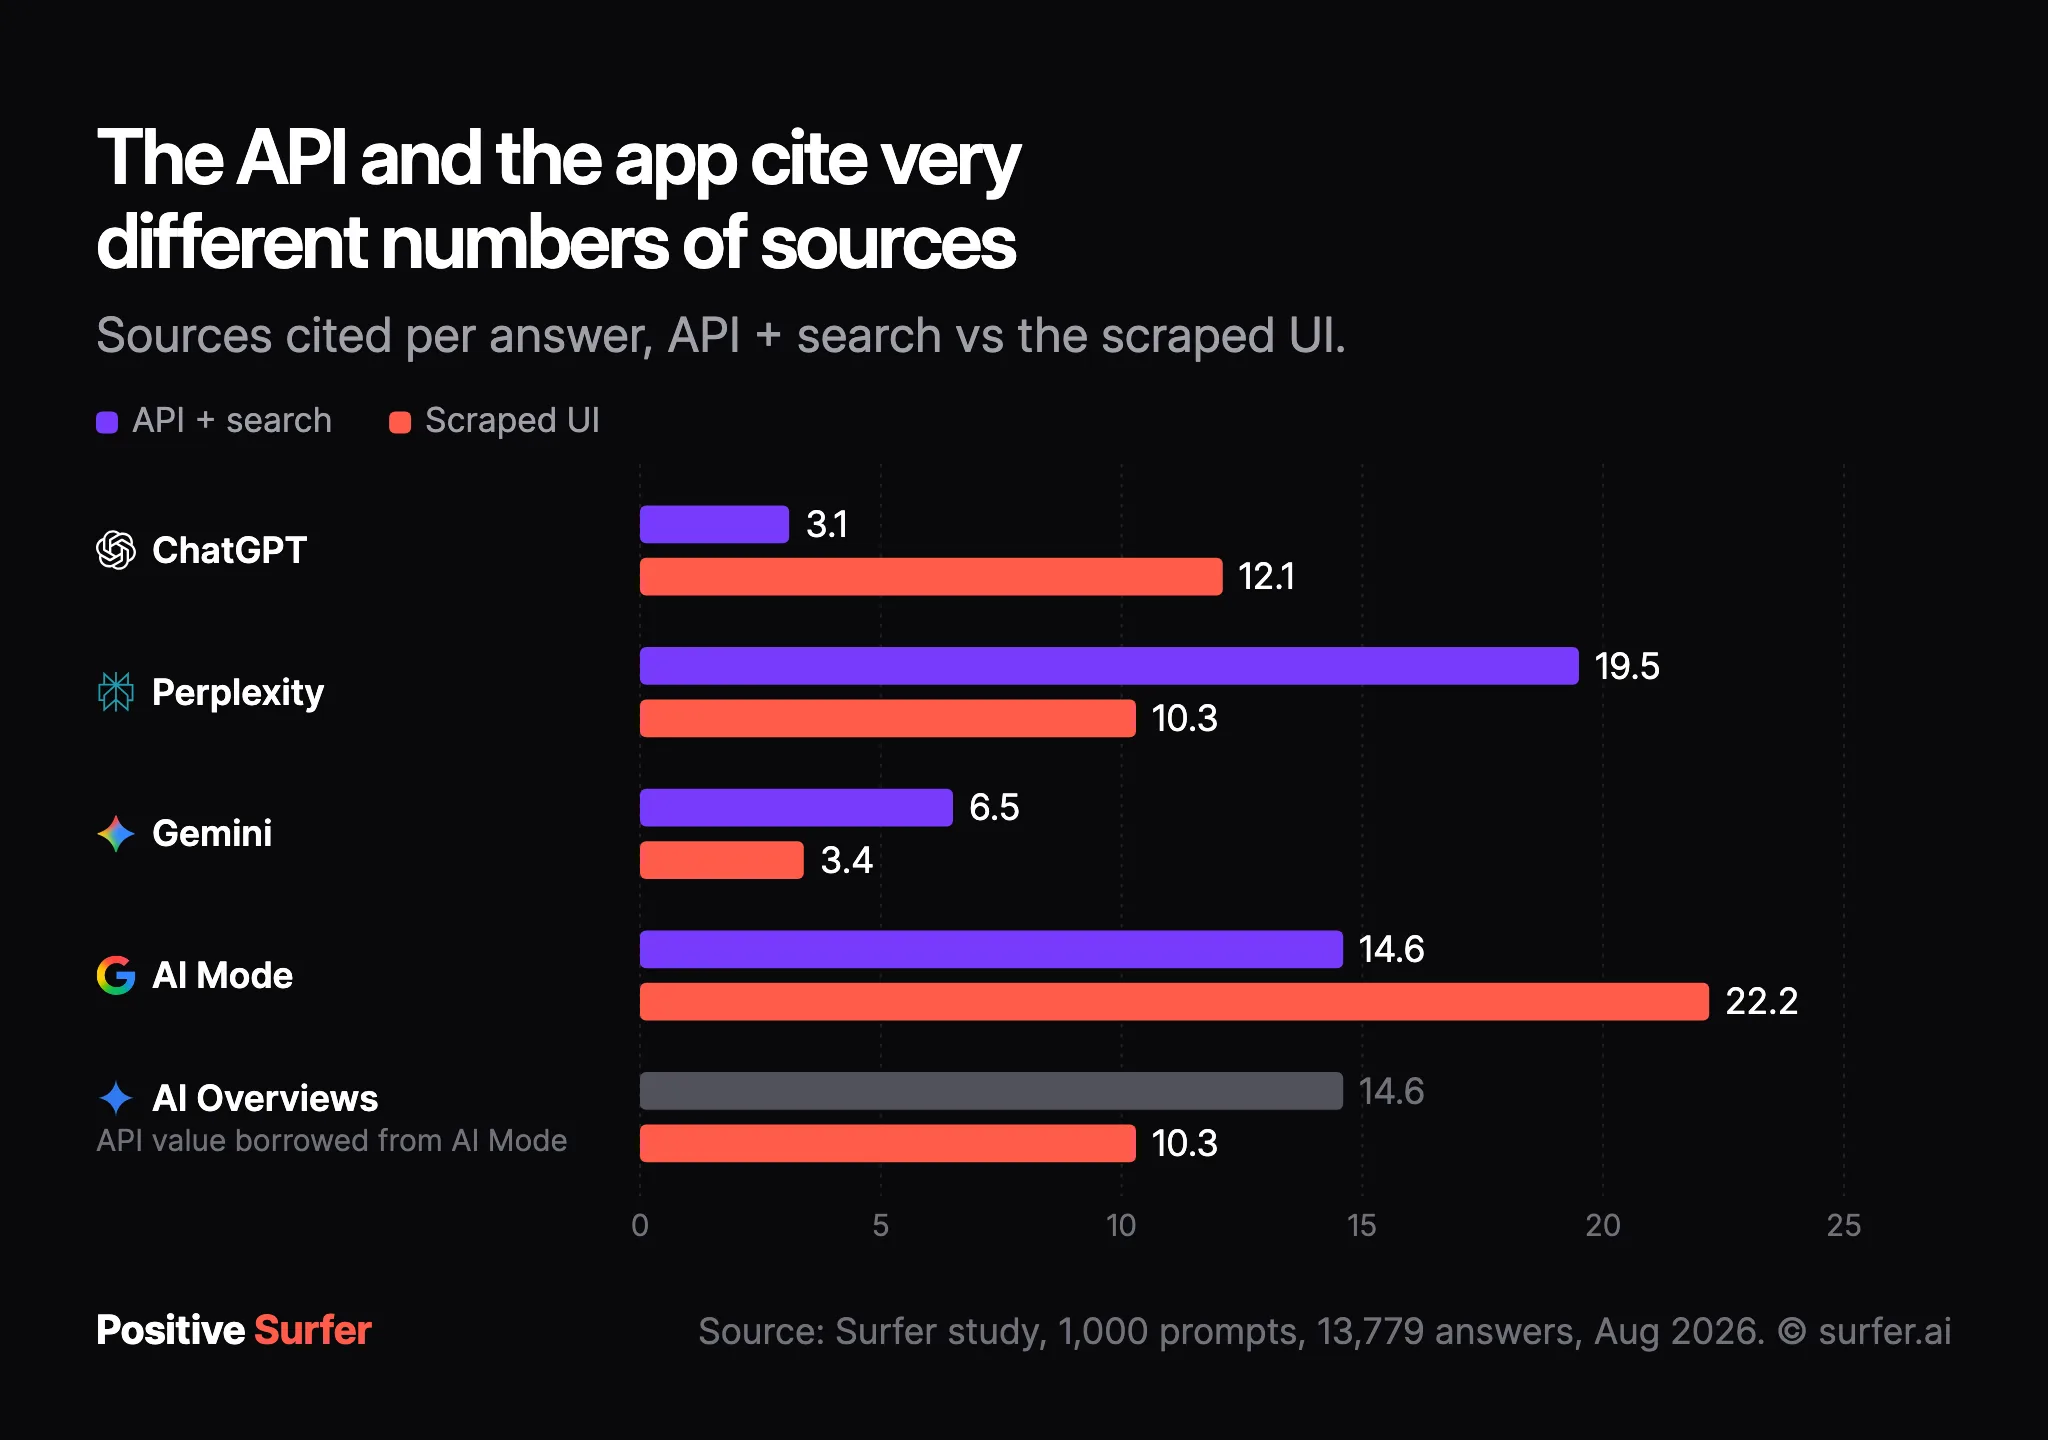
C’est la catégorie la moins concluante de toute l’étude. Pour certains modèles, l’interface extraite citait plus de sources que l’API. Pour d’autres, c’était l’inverse.
ChatGPT mène le premier groupe avec l’écart le plus important de l’étude : 12,1 sources citées dans l’interface standard contre 3,1 via l’API. AI Mode cite aussi plus de sources que son API, 22,2 contre 14,6.
En revanche, l’API de Perplexity cite 19,5 sources contre 10,27 dans l’application, celle de Gemini 6,5 contre 3,4, et la méthode empruntée pour AI Overviews 14,6 contre 10,3.
Nous avons toutefois découvert autre chose. Les interfaces extraites lançaient une recherche web pour presque chaque prompt : 88 % pour ChatGPT et 100 % pour les quatre autres. Côté API, seul Perplexity atteignait 100 %. L’API de ChatGPT a lancé une recherche pour 83 % des prompts, AI Mode et AI Overviews pour 94 %, et Gemini pour 85 %. Le comportement de recherche lui-même diffère donc aussi.
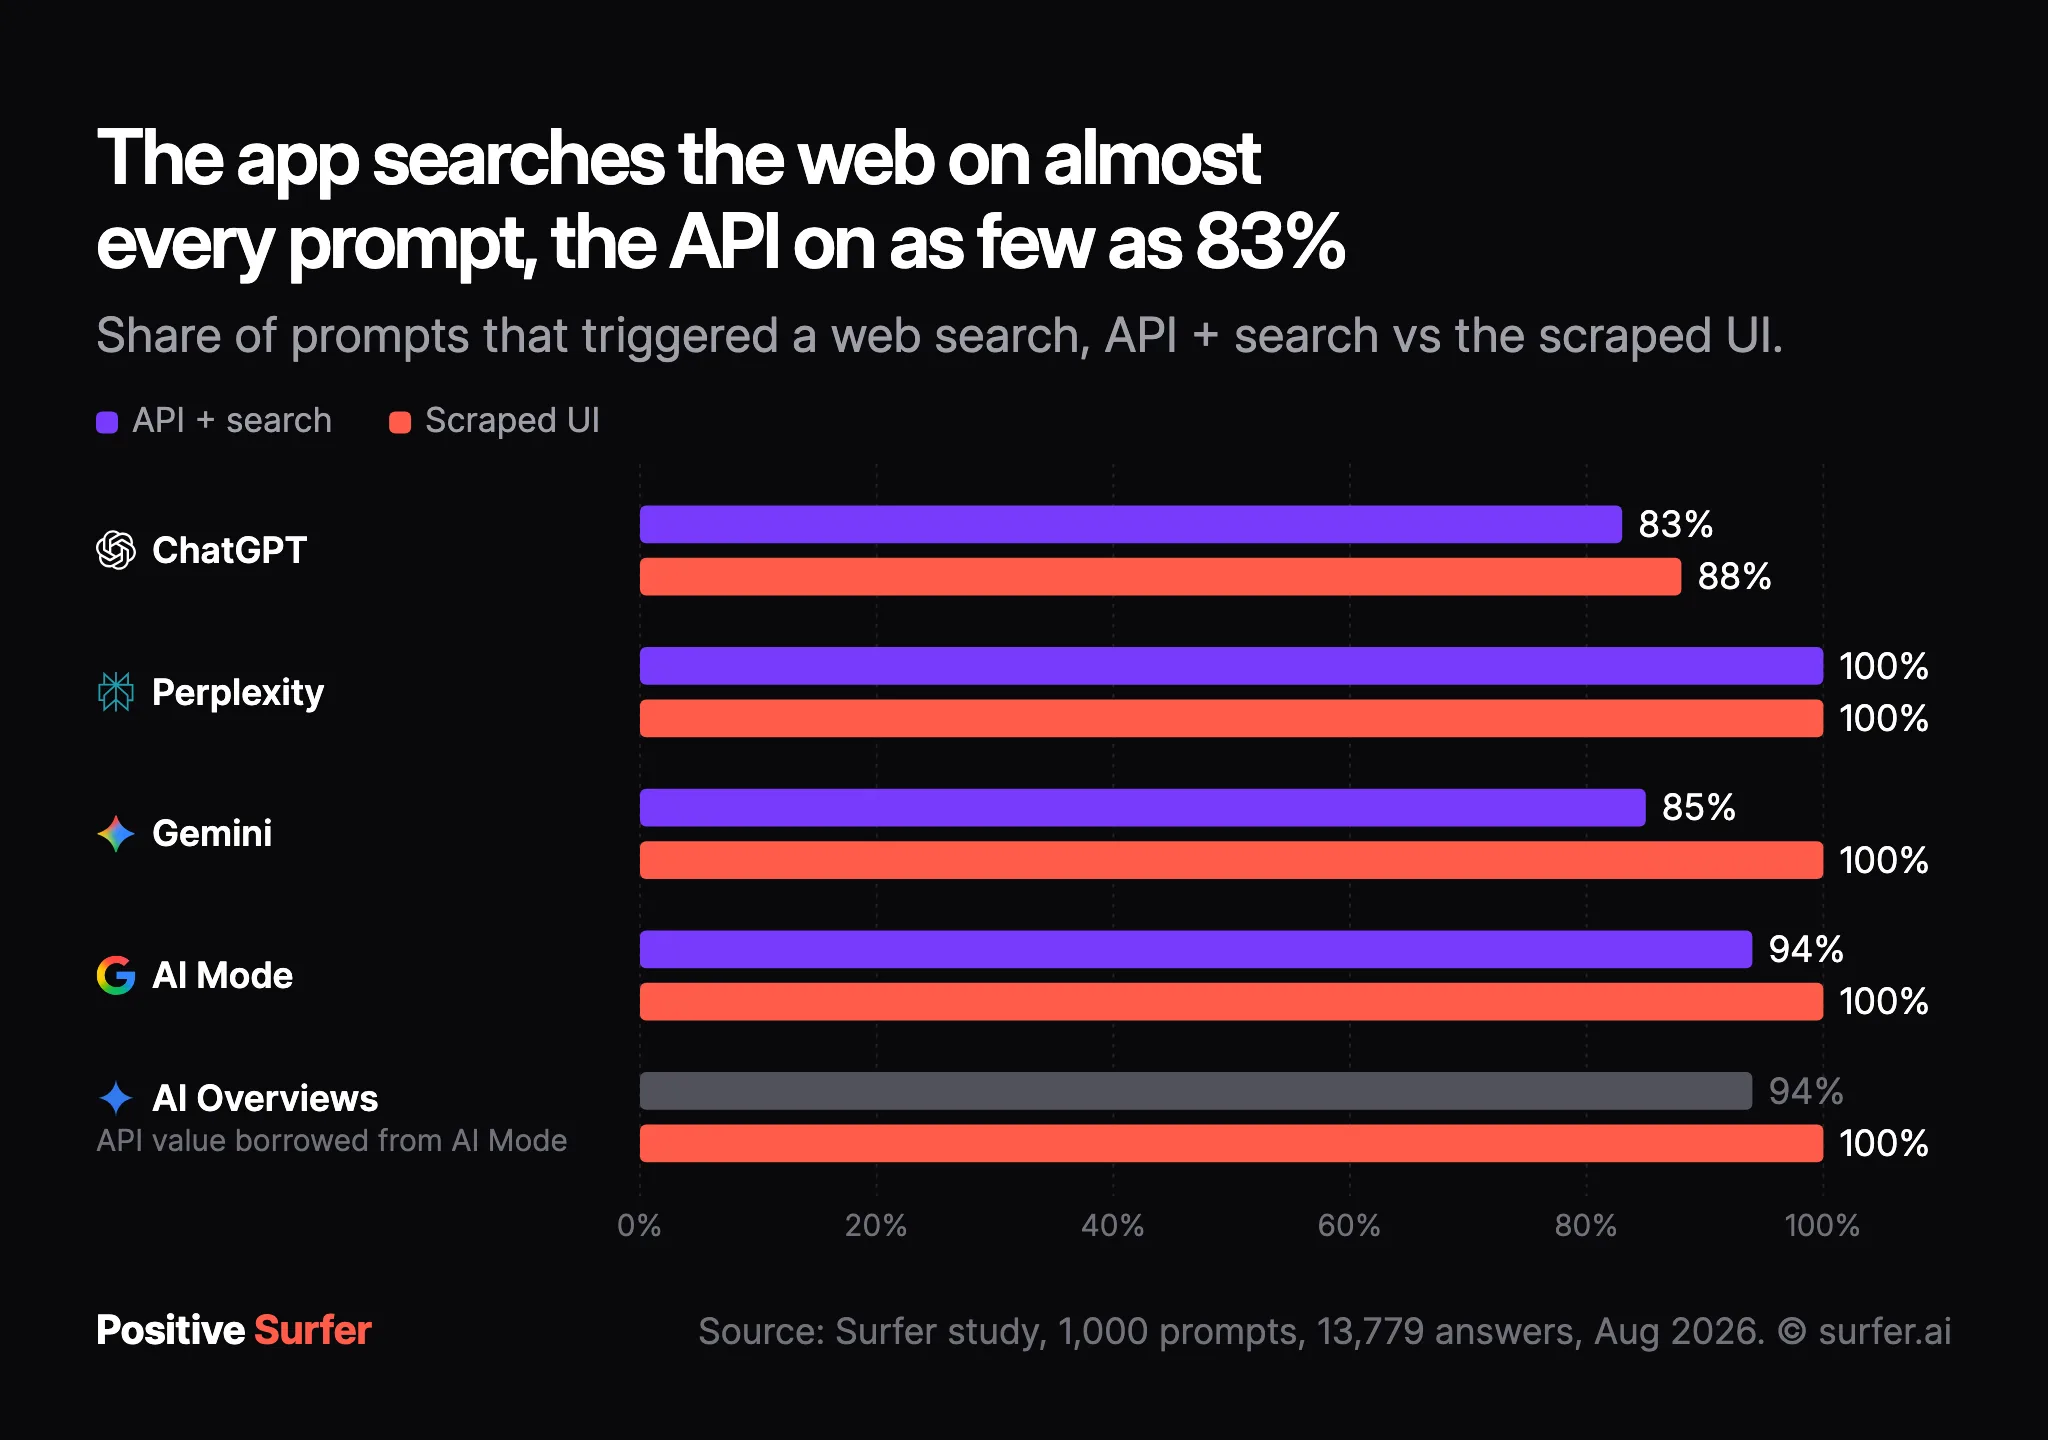
Ce que cela signifie pour votre suivi de la visibilité IA : même si la tendance sur les sources citées n’est pas concluante, ce déséquilibre révèle une énorme différence entre les méthodes de recherche. Cela prouve que l’API n’est pas une source fiable.
Même quand les API et les interfaces s’accordent sur les éditeurs cités, elles divergent sur les pages
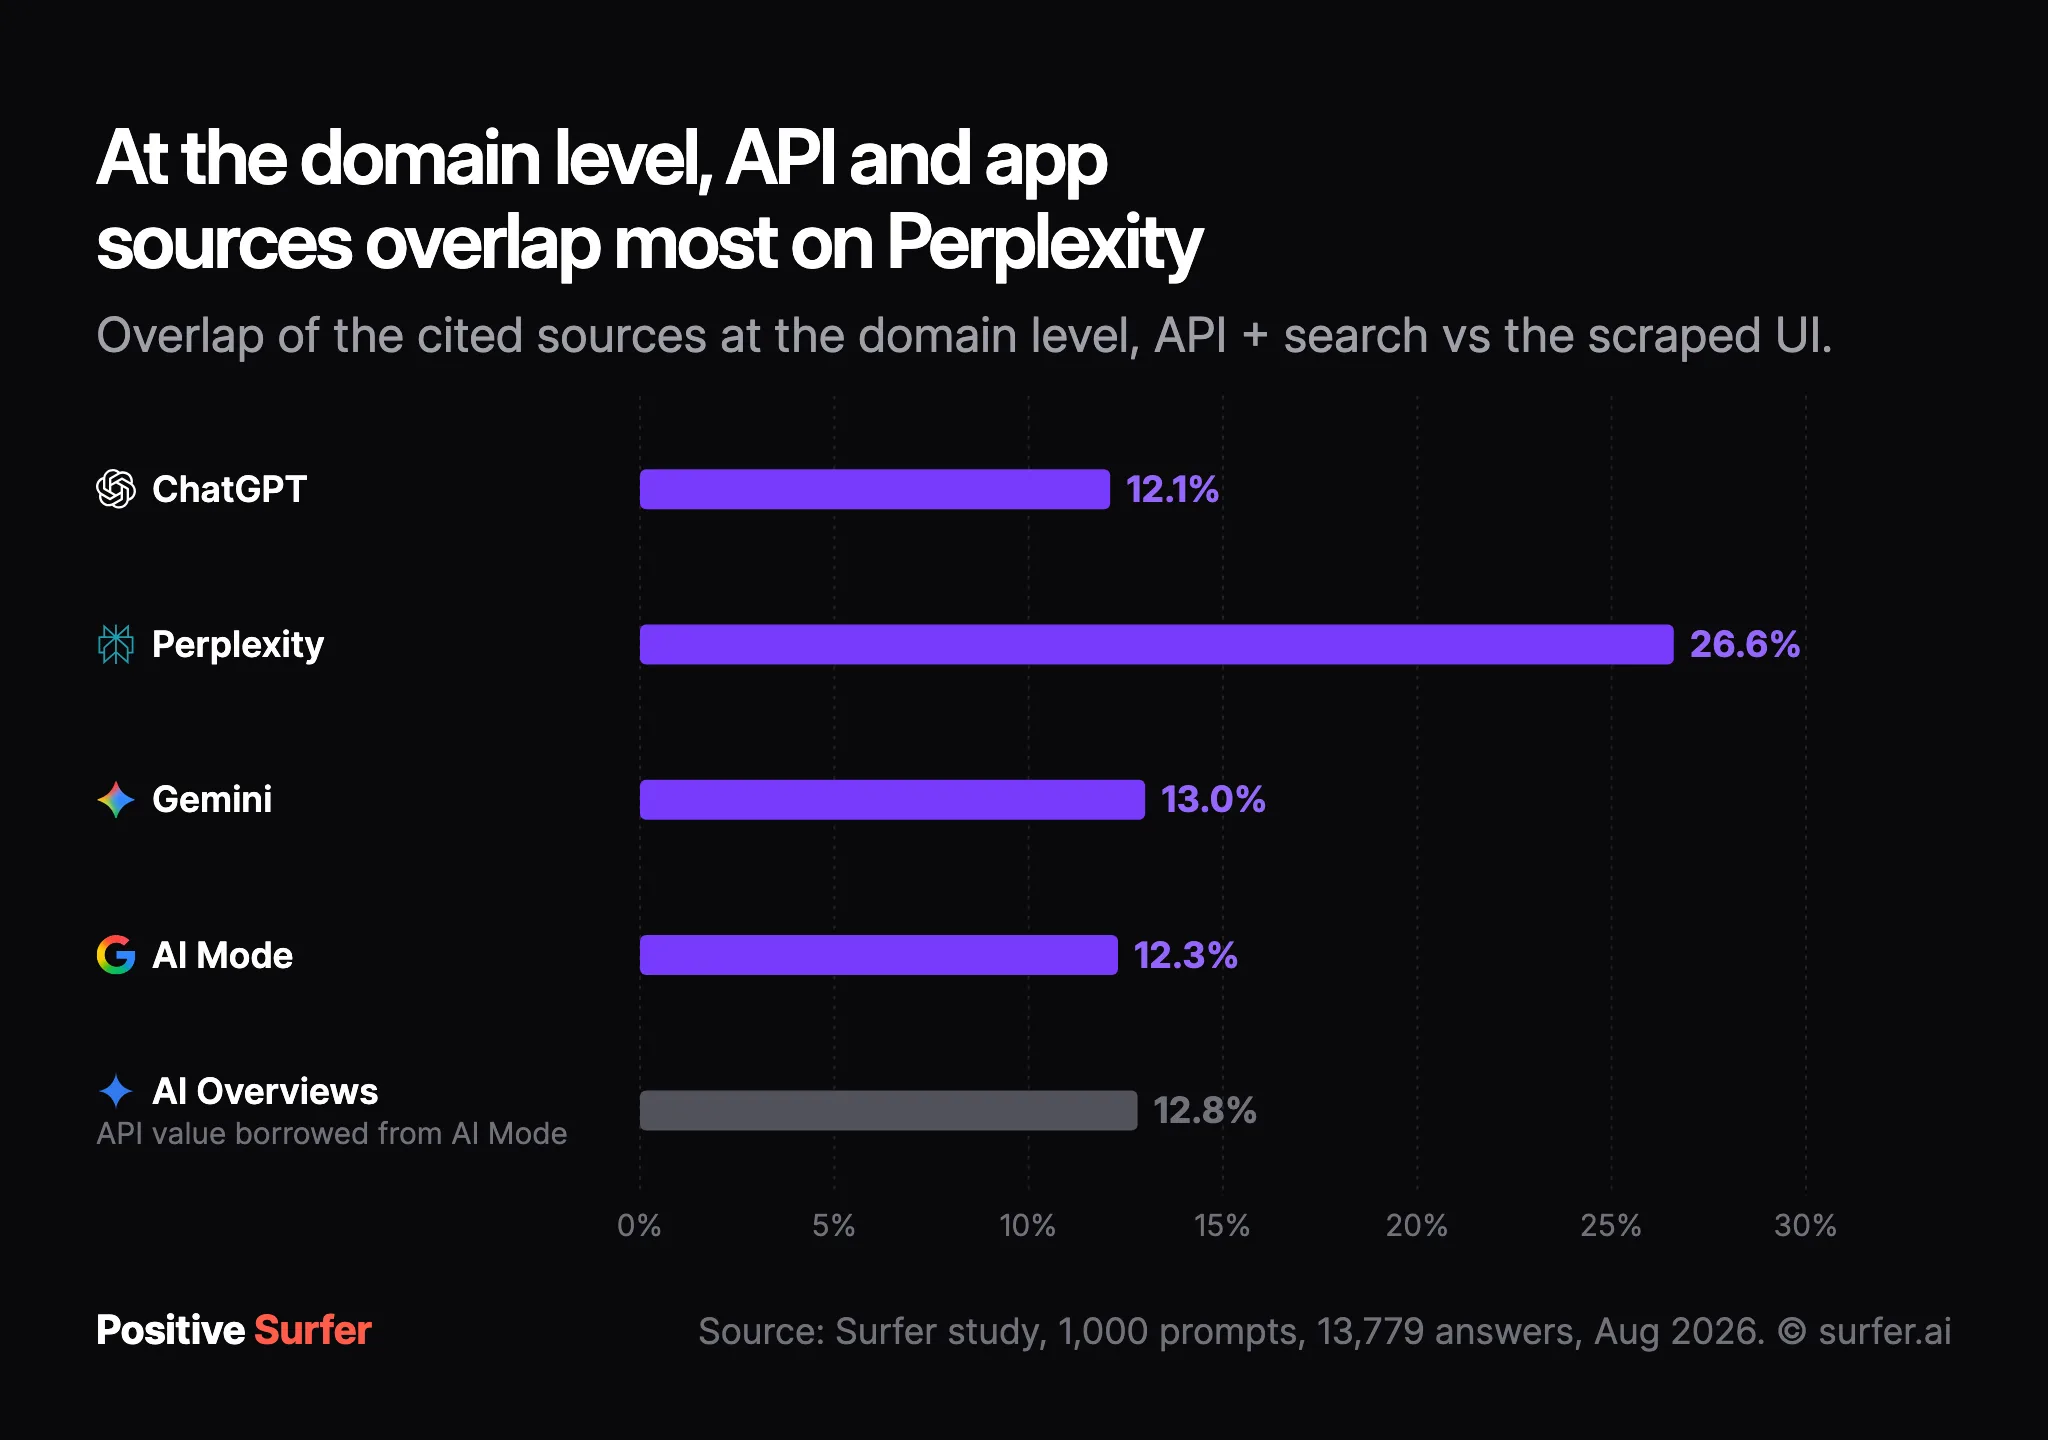
Pour comparer les sources citées, il faut distinguer le recoupement au niveau du domaine et au niveau de l’éditeur. Les chiffres ne sont pas les mêmes dans les deux cas.
Le recoupement des domaines est le plus élevé pour Perplexity (26,7 %) et le plus faible pour ChatGPT, avec à peine 4,8 %.
Pour Gemini, AI Mode et AI Overviews, impossible de mesurer le recoupement au niveau des pages : leurs API renvoient des jetons de redirection propres à chaque appel au lieu des URL de destination.
Pour ChatGPT et Perplexity, les chiffres sont inférieurs au recoupement au niveau des domaines : 19,7 % sur Perplexity et de 4,8 % à 6,2 % sur ChatGPT.
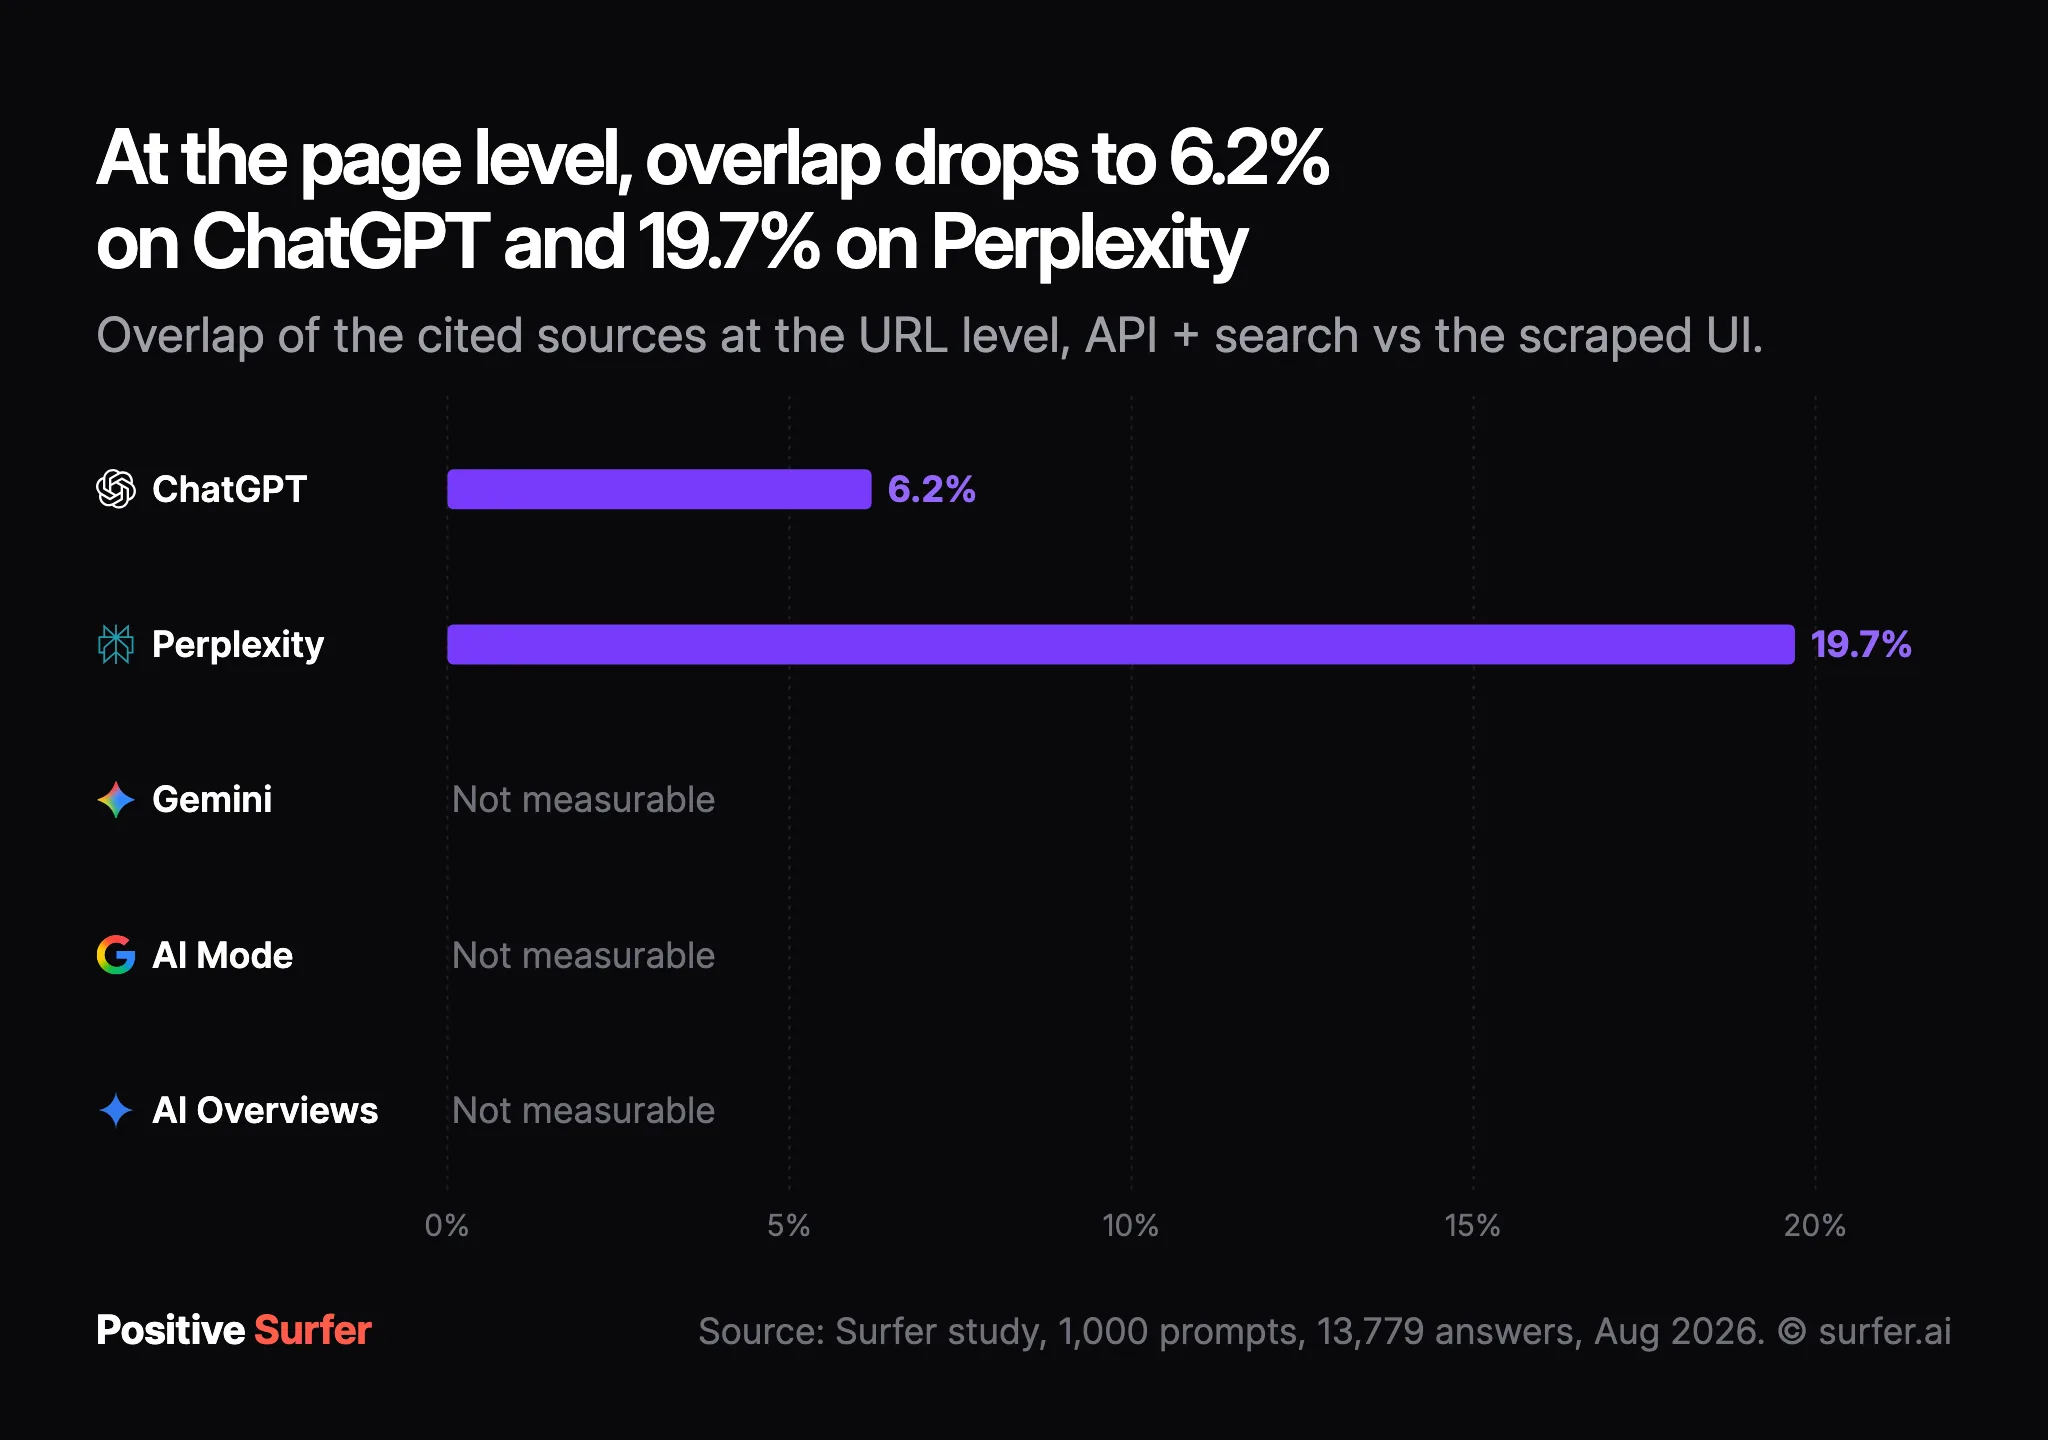
Ce que cela signifie pour votre suivi de la visibilité IA : le recoupement au niveau des domaines comme des pages est trop faible pour garantir des résultats fiables à partir de l’API. Si votre méthode consiste à trouver les pages citées par les modèles d’IA puis à les contacter, les outils basés sur l’API risquent de vous orienter vers des sources que vos clients ne voient pas réellement.
Faisons le point
Les chiffres sont clairs : les API et les applications grand public divergent sur chacun des critères étudiés. Même si les tendances n’étaient pas identiques, les écarts restaient énormes :
- Quelles marques sont citées : le recoupement va de 15,5 % seulement jusqu’à 32 %, même après nettoyage des noms.
- Combien de marques sont citées : les API citent plus de produits, jusqu’à 1,85 fois plus. Vous pensez peut-être avoir obtenu cette mention, mais vos acheteurs ne vous voient jamais.
- La longueur de la réponse : les réponses des API sont nettement plus longues.
- Combien de sources sont citées : sur ChatGPT, les réponses extraites citent près de quatre fois plus de sources. Sur Perplexity et Gemini, c’est l’API qui en cite près de deux fois plus. Dans tous les cas, les nombres de citations sont très différents.
- Quelles sources sont citées : le recoupement au niveau des pages descend à 4,8 % et ne dépasse pas 19,7 %. Une mauvaise nouvelle pour les stratégies de prospection et d’optimisation, où il est crucial d’être présent exactement sur les bonnes pages.
L’API et le produit partagent le modèle, mais ce sont des systèmes différents. Vous ne pouvez pas suivre de façon fiable votre visibilité IA à partir des API. Et il ne s’agit pas d’une simple petite marge d’erreur.
« Une seule phrase dans le prompt système peut faire changer la réponse d’un LLM à 180°, et les LLM ont généralement des instructions très détaillées qui varient selon l’application. C’est pourquoi un alignement aussi faible entre l’API et le produit final ne me surprend pas. »
Comment suivre votre visibilité IA avec Surfer ?
Si vous voulez mesurer la façon dont votre marque apparaît dans les outils d’IA qu’utilisent vos acheteurs, vous devez vous appuyer sur les données des interfaces utilisateur, et non des API. C’est exactement le type de données qu’utilise Surfer.
La visibilité IA, c’est être mentionné, être mentionné souvent, et être mentionné favorablement. Et nous pouvons vous aider sur ces trois points. Avec AI Search Analytics de Surfer, vous pouvez analyser vos sources, vos concurrents, vos prompts et vos requêtes dérivées, avec la certitude de voir la même chose que vos utilisateurs.
Voici un rapide tour d’horizon des fonctionnalités de l’outil :
Avant tout : la configuration
Rendez-vous dans la section Visibilité IA du menu de gauche et sélectionnez Vue d’ensemble. Surfer analyse votre marque et vous suggère des sujets et des prompts à suivre.
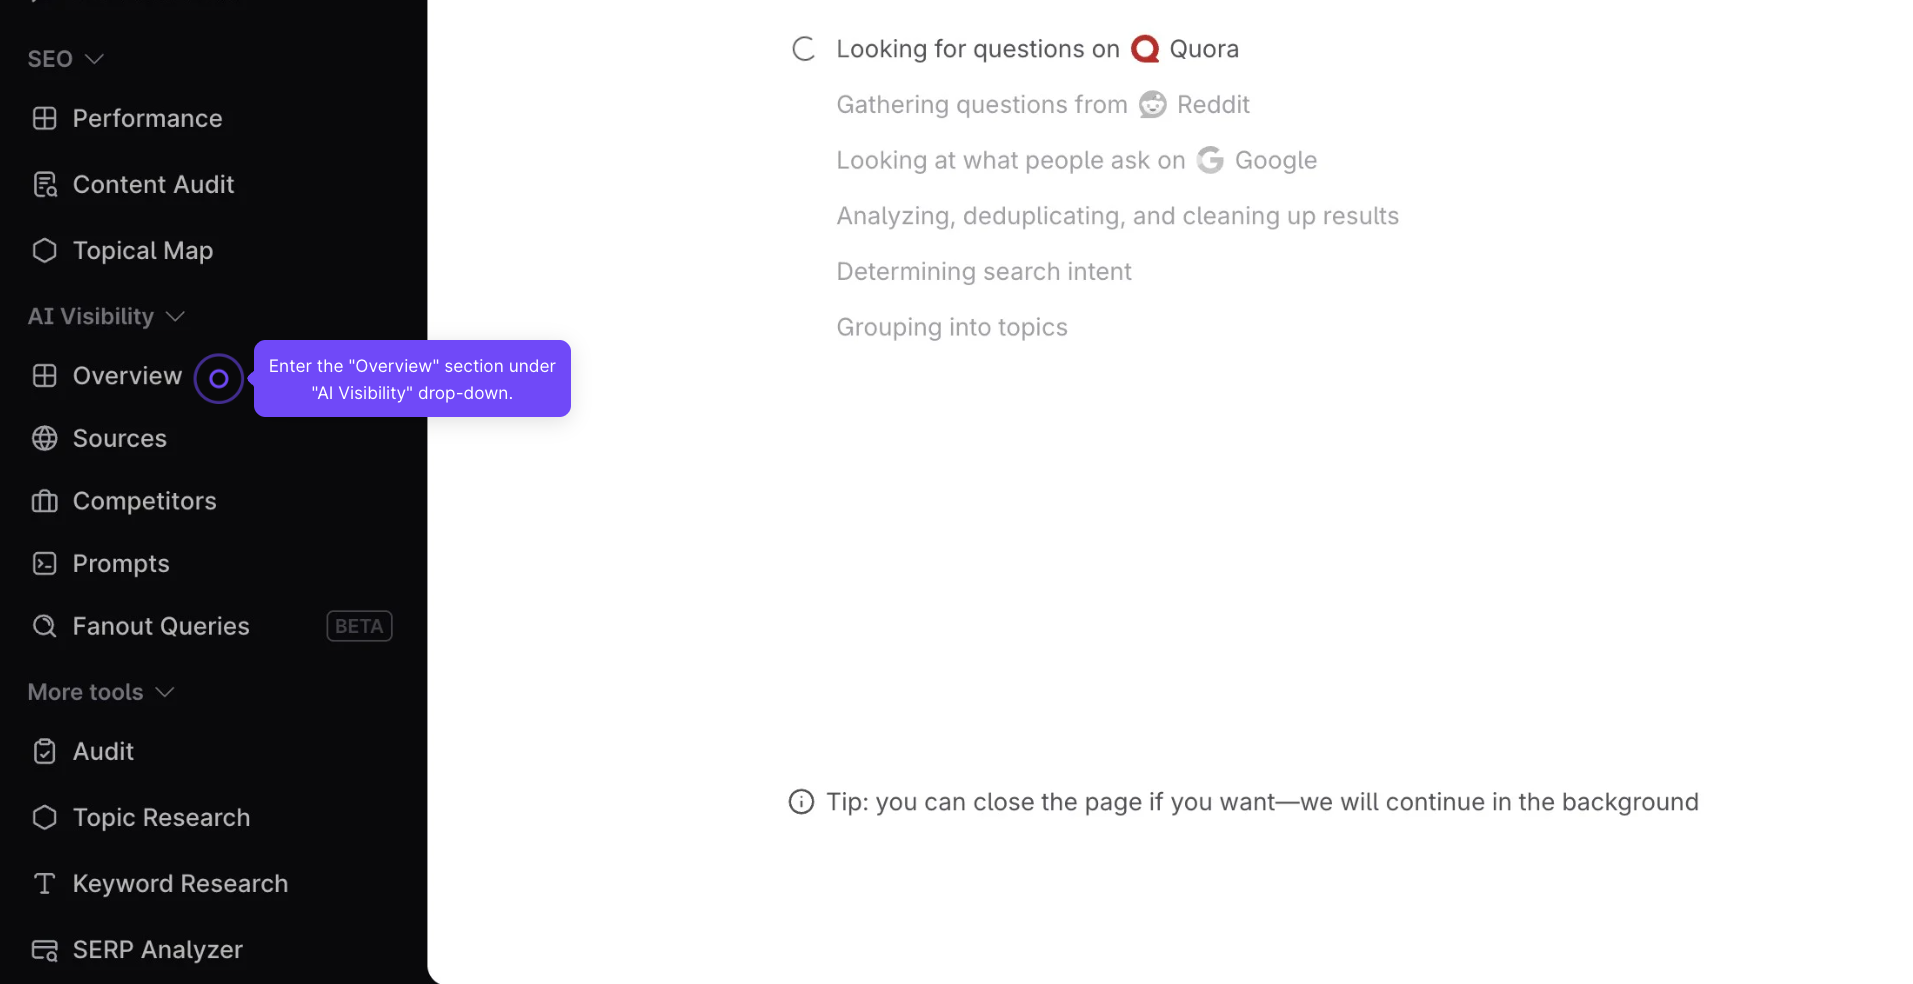
Une fois l’analyse terminée, vous voyez une liste de sujets pertinents et les prompts associés. Passez en revue les prompts suggérés et validez-les (ou modifiez-les).
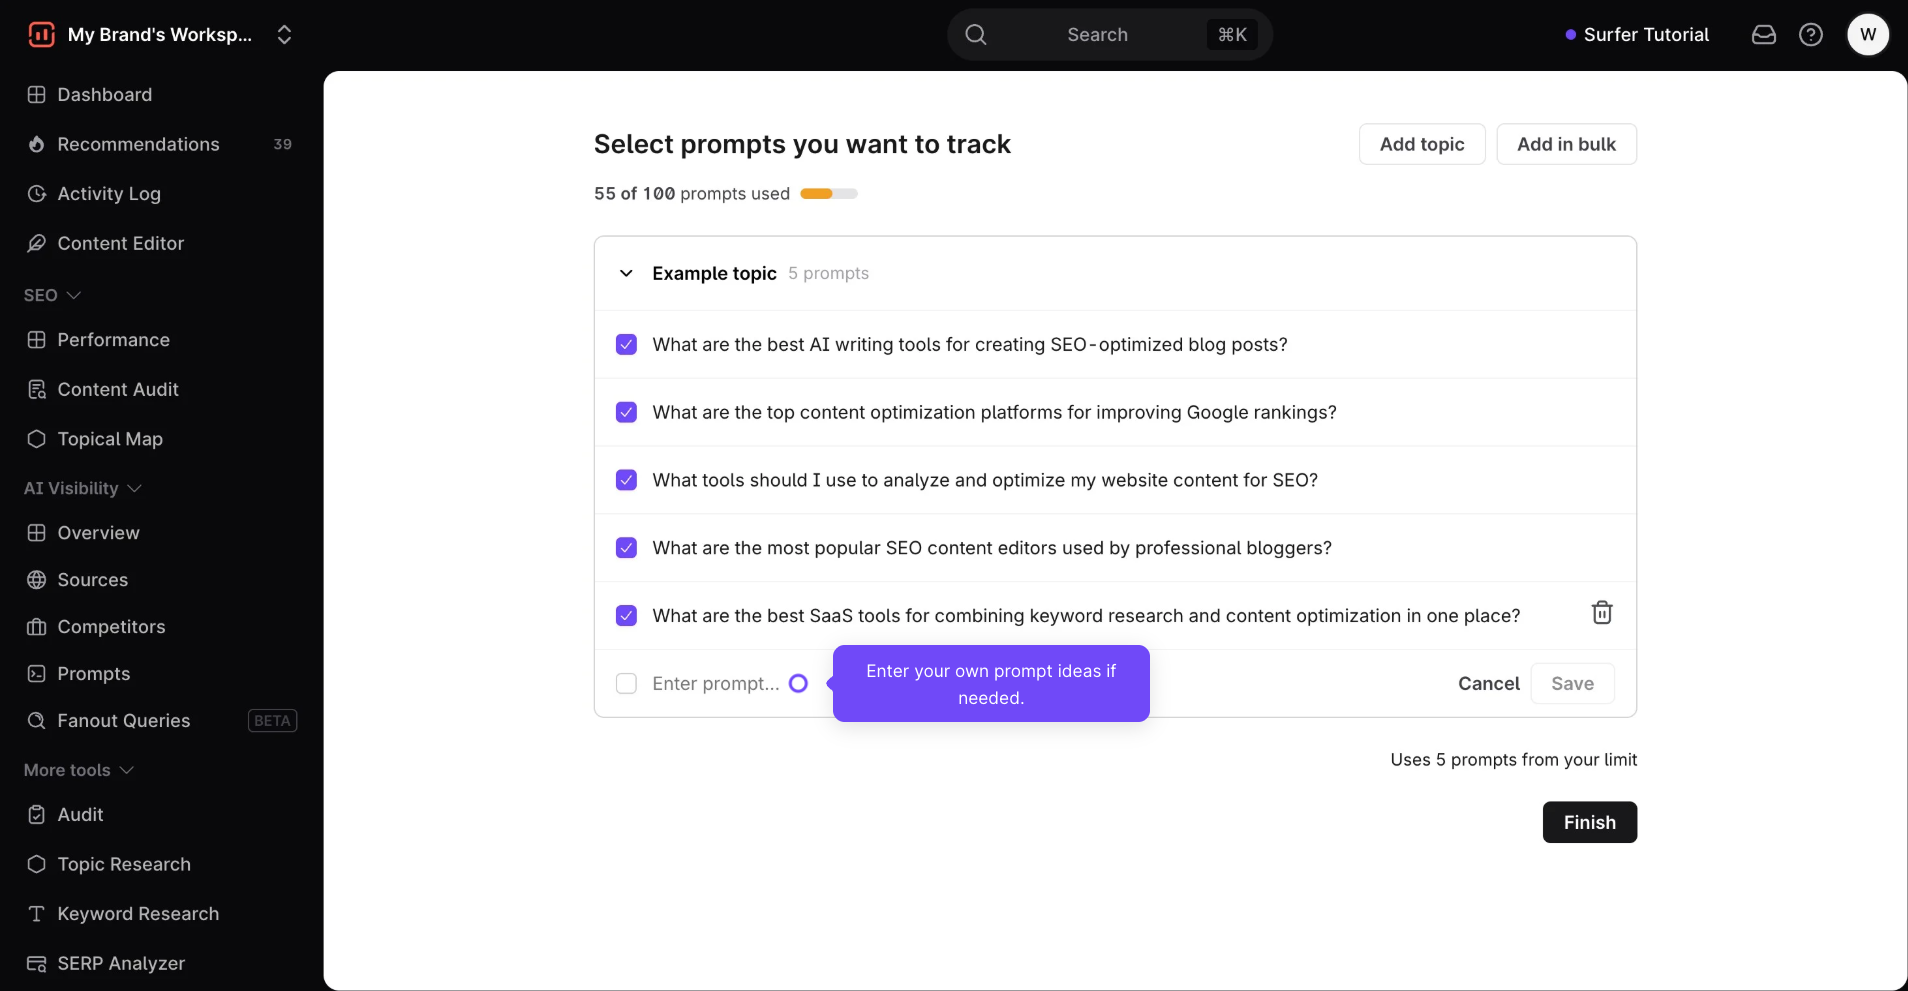
Avant que vous ne demandiez combien de prompts suivre : ce qui compte le plus, ce n’est pas le nombre total de prompts, mais le fait de couvrir chaque sujet et chaque intention utilisateur.
20 prompts valent autant que 10 000 s’ils sont choisis avec soin. Regroupez-les en petits groupes par intention. Mélangez, pour chaque intention, des questions courtes de type comparaison et des questions longues. Les variations de formulation comptent peu. Cinq prompts principaux par sujet, c’est parfait.
C’est tout pour la configuration. L’outil se charge maintenant d’alimenter vos tableaux de bord.
La vue principale affiche votre Score de visibilité, votre taux de mention et votre position moyenne : vous avez ainsi d’un coup d’œil une vue d’ensemble de vos performances dans l’IA.
Tableau de bord Sources
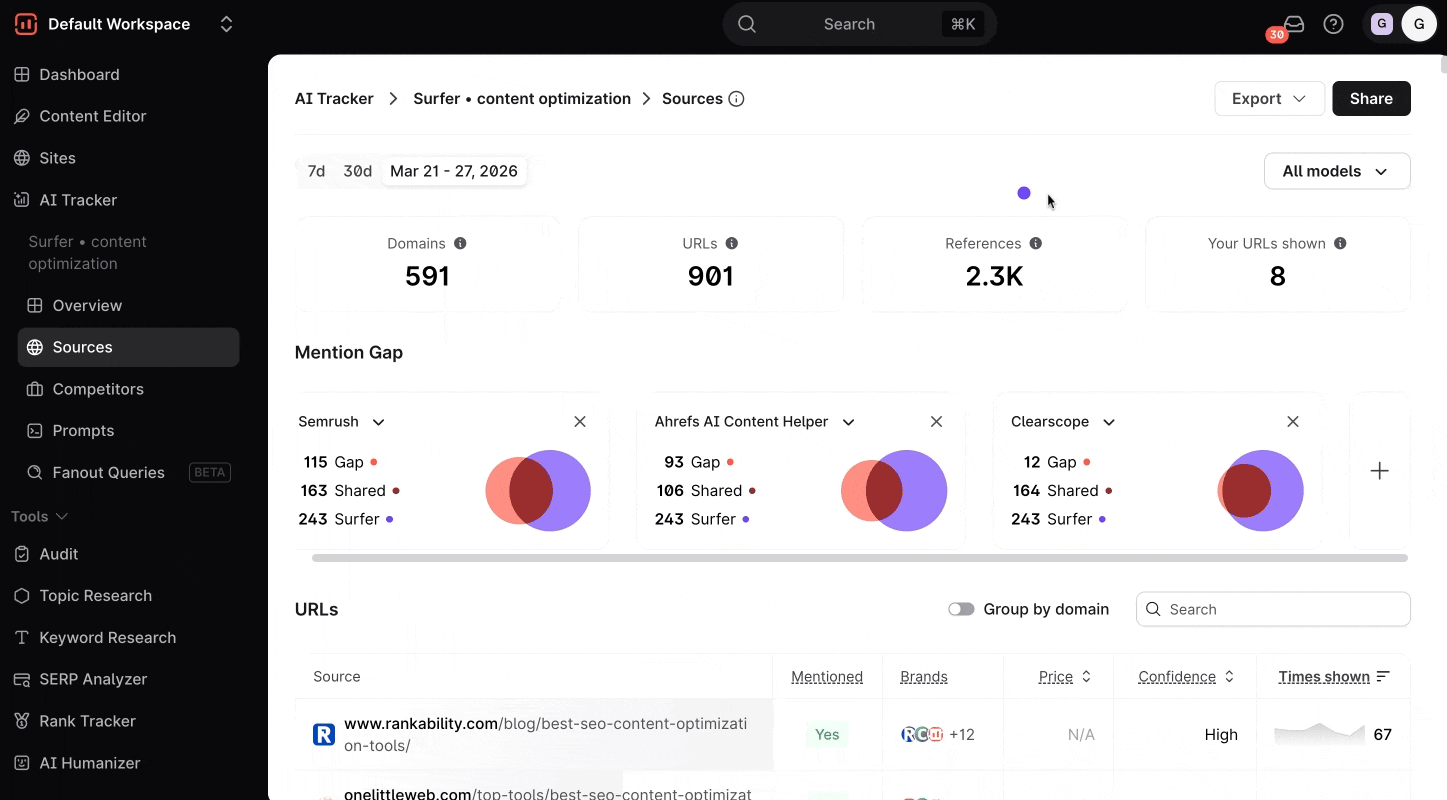
Dans le tableau de bord Sources, vous voyez quelles marques sont citées sur les sujets que vous suivez. Vous voyez quelles sources vous mentionnent déjà, et lesquelles non. Repérez les sources les plus citées dont vous êtes absent et lancez une prospection fondée sur les données.
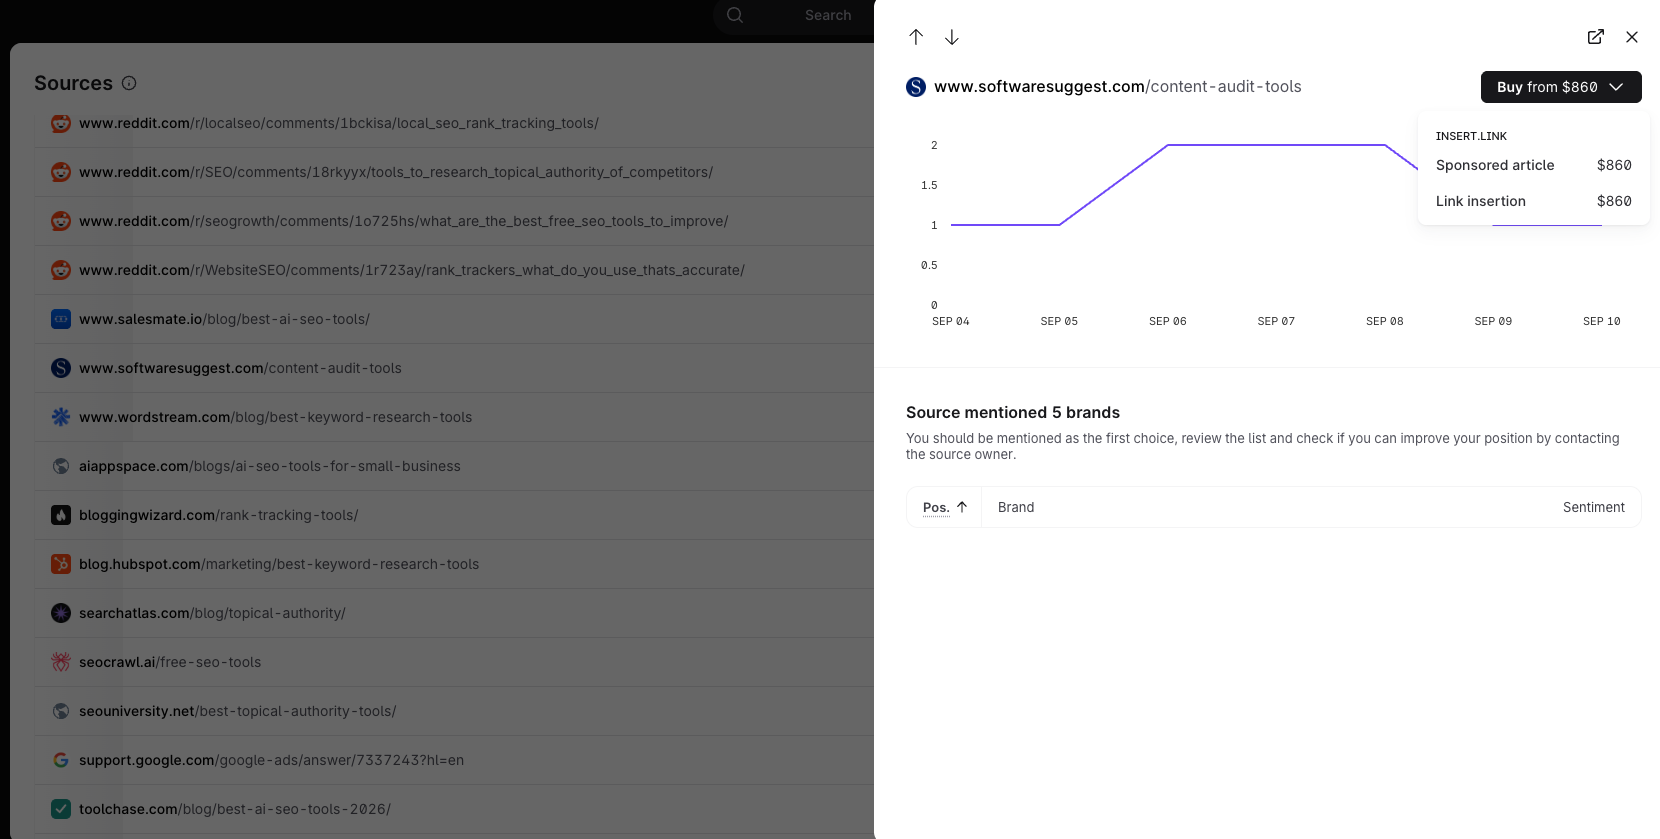
Vous pouvez aussi acheter des mentions directement depuis Surfer.
Vérifiez la perception de votre marque dans les principales sources. L’IA n’a pas d’opinion : les mentions sont façonnées par les sources qu’elle cite. Et contrairement à ce que certains affirment, la mauvaise publicité existe bel et bien. Une mention fausse ou défavorable vous fera plus de tort que pas de mention du tout. Contactez les pages sur lesquelles vous voulez faire corriger votre mention.
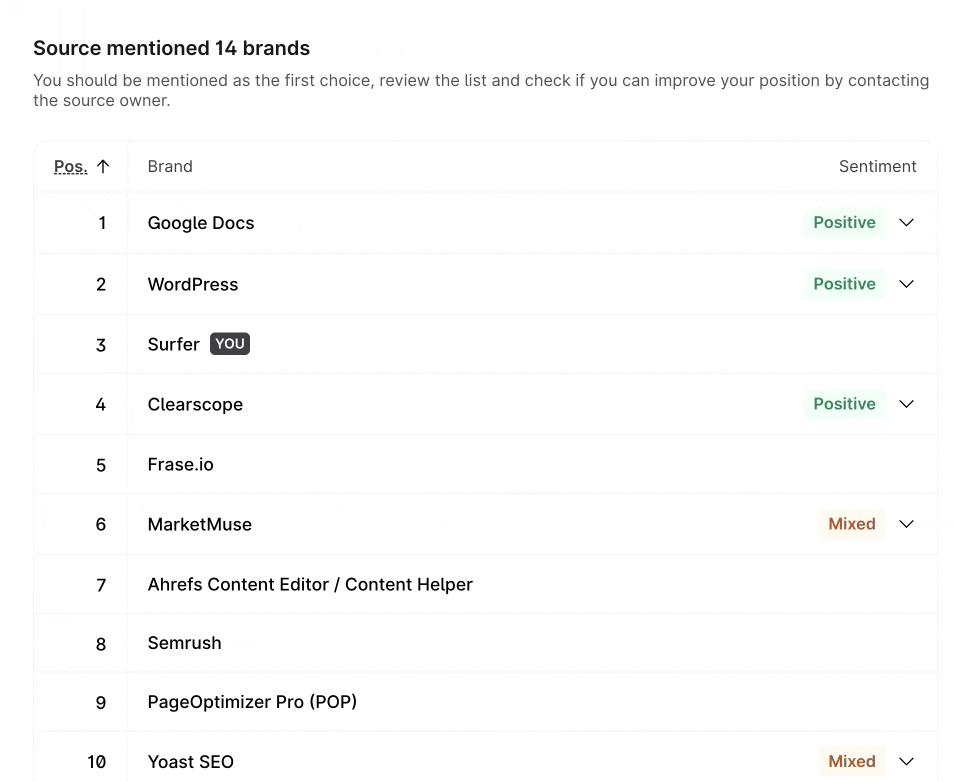
Tableau de bord Prompts
Si vous avez ajouté vos sujets, les prompts sont classés par sujet. Voyez sur quels sujets vous êtes performant et lesquels demandent davantage d’attention.
Vous voyez aussi quelles marques les modèles d’IA grand public reconnaissent le plus souvent, et où vos concurrents vous devancent.
Comparez les modèles entre eux et suivez les tendances dans le temps pour affiner votre stratégie.
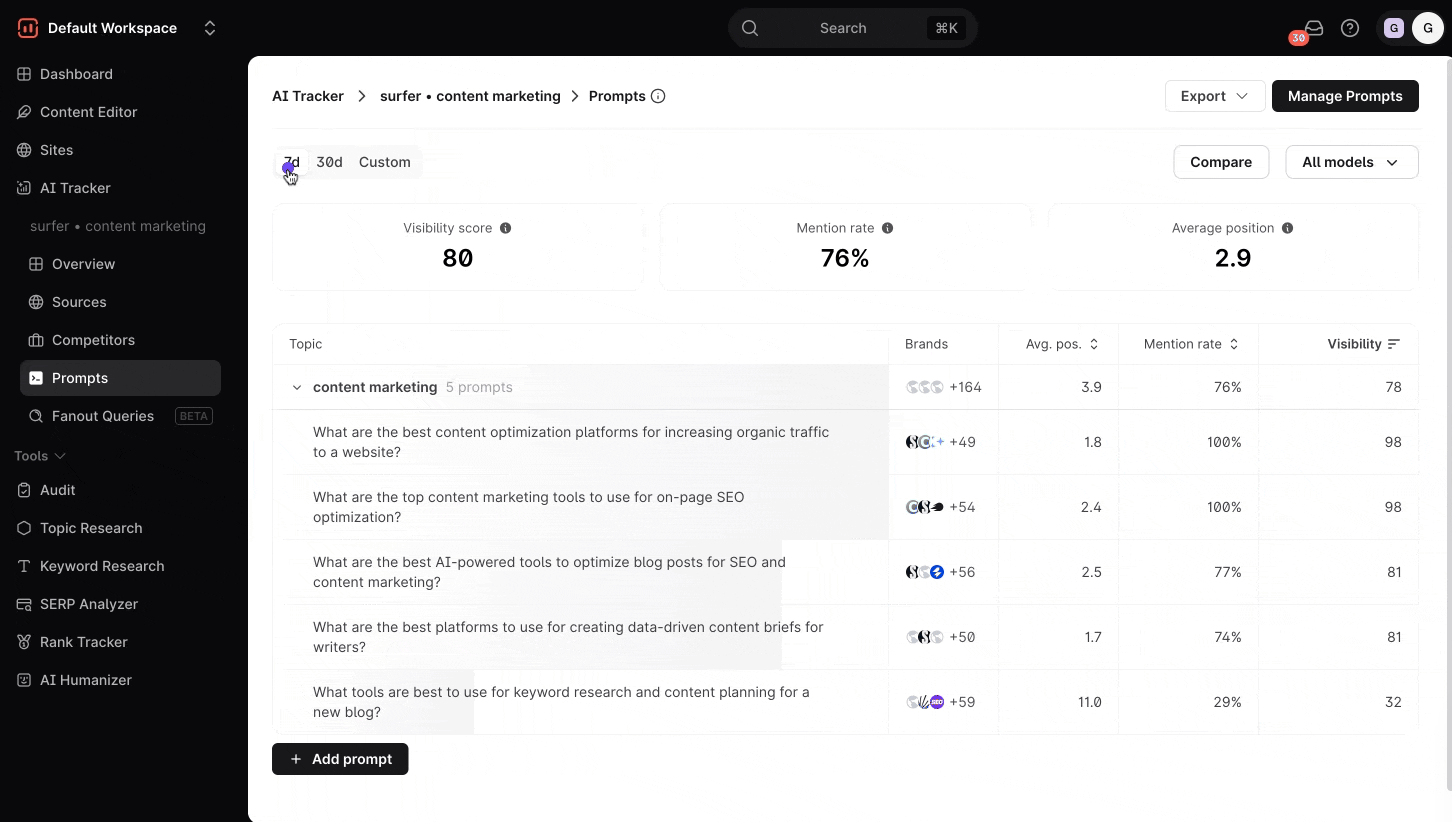
Tableau de bord Concurrents
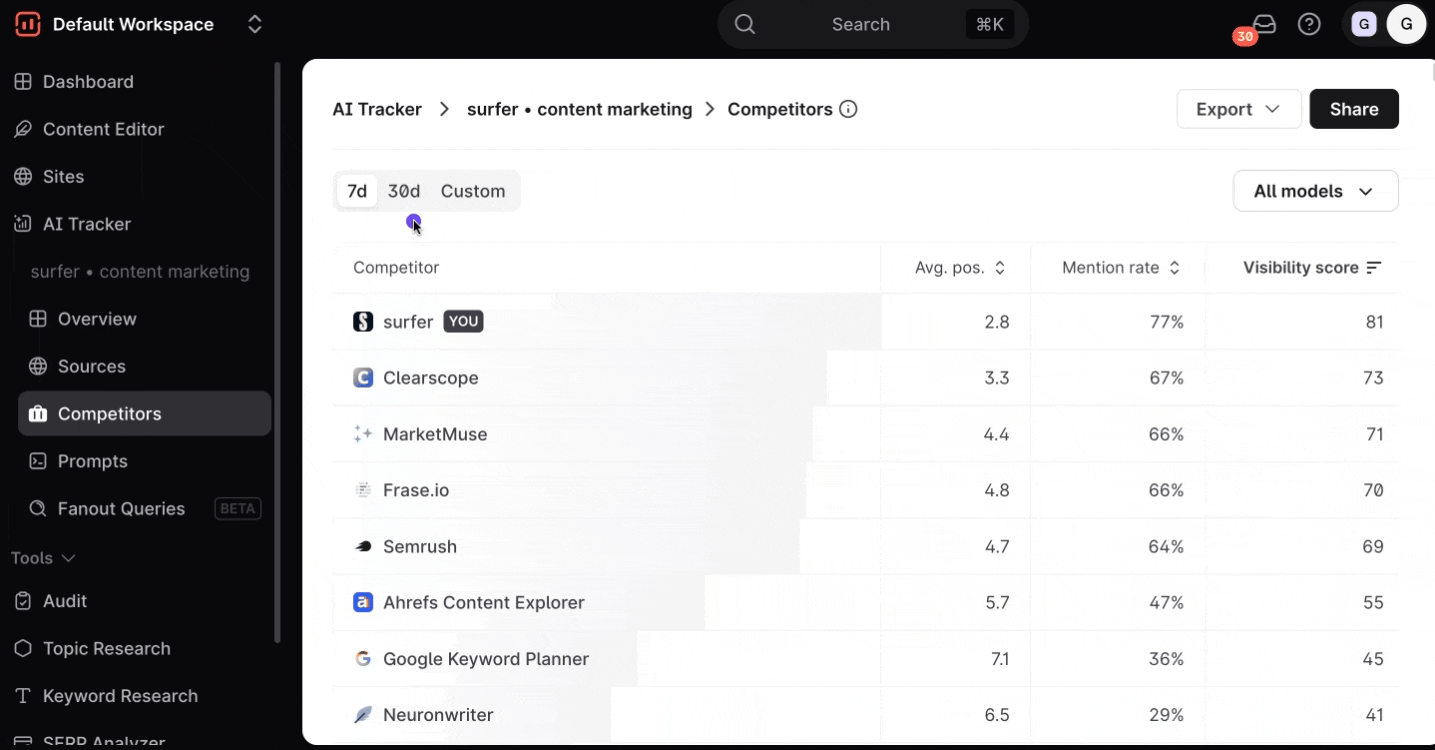
Parcourez les marques qui se positionnent sur vos prompts suivis pour comparer leur présence à celle de votre marque.
Repérez les lacunes thématiques et les sources où vos concurrents apparaissent mais pas vous, et gardez un œil sur les nouveaux concurrents.
La source des données compte : choisissez l’outil dont les recommandations sont justes
Nos données montrent que l’écart entre les API et les données extraites est énorme :
- Environ 75 % de la liste des marques ne se recoupe pas.
- Jusqu’à 95 % des sources citées ne correspondent pas (selon que vous comparez les éditeurs ou les pages).
- Les réponses peuvent être deux fois plus longues que tout ce que lisent vos acheteurs.
Et ce n’est pas tout. La question est donc : utiliser des outils qui s’appuient sur des API pour suivre la visibilité dans la recherche IA a-t-il seulement un sens, si l’on ne peut pas se fier entièrement à leurs données ?
Si vous ne voulez pas jouer votre stratégie de visibilité à pile ou face et que vous n’utilisez pas encore Surfer, pourquoi ne pas l’essayer dès maintenant ? Nous n’utilisons que des données extraites fiables et en temps réel : vous avez la garantie que vos tableaux de bord montrent uniquement ce que voient vos acheteurs.
(Et si vous n’êtes pas encore prêt à adopter toute la plateforme Surfer, nous proposons désormais AI Search Analytics en abonnement séparé. Faites un essai !)
Collecte des données : 4 août 2026, avec l’appui de cloro pour la collecte et l’analyse des données. Analyse : Maciej Gruszczyński, équipe Data de Surfer.
Précisions :
Un échantillon par prompt. Un même prompt posé deux fois ne renvoie pas la même réponse : une partie des divergences ci-dessous tient donc au caractère non déterministe des modèles plutôt qu’à une différence entre les canaux. La parité des modèles est approximative. Aucun fournisseur ne dévoile le modèle exact qui fait tourner son produit. Chaque méthode API utilise l’équivalent le plus proche disponible à l’achat, indiqué plus haut. La méthode API d’AI Overviews est empruntée à AI Mode (le même appel), car Google indique dans sa documentation qu’AI Overviews fonctionne avec Gemini 3 et qu’aucun modèle de ce type n’est commercialisé. La méthode d’AI Mode avec prompt système couvre 813 des 1 000 prompts : un quota de grounding Google a bloqué les autres. Toutes les autres méthodes sont complètes.