Il semble raisonnable de supposer que les domaines les plus forts ont plus de chances d’être cités dans les réponses de l’IA. Mais est-ce vraiment le cas, ou s’agit-il d’un réflexe hérité de l’ère des « dix liens bleus » ?
Pour le savoir, nous avons extrait trois mois de données du Suivi de visibilité IA de Surfer, couvrant 20 000 prompts et environ 5 millions d’URL sources de citations uniques sur AI Mode, AI Overviews, ChatGPT et Perplexity.
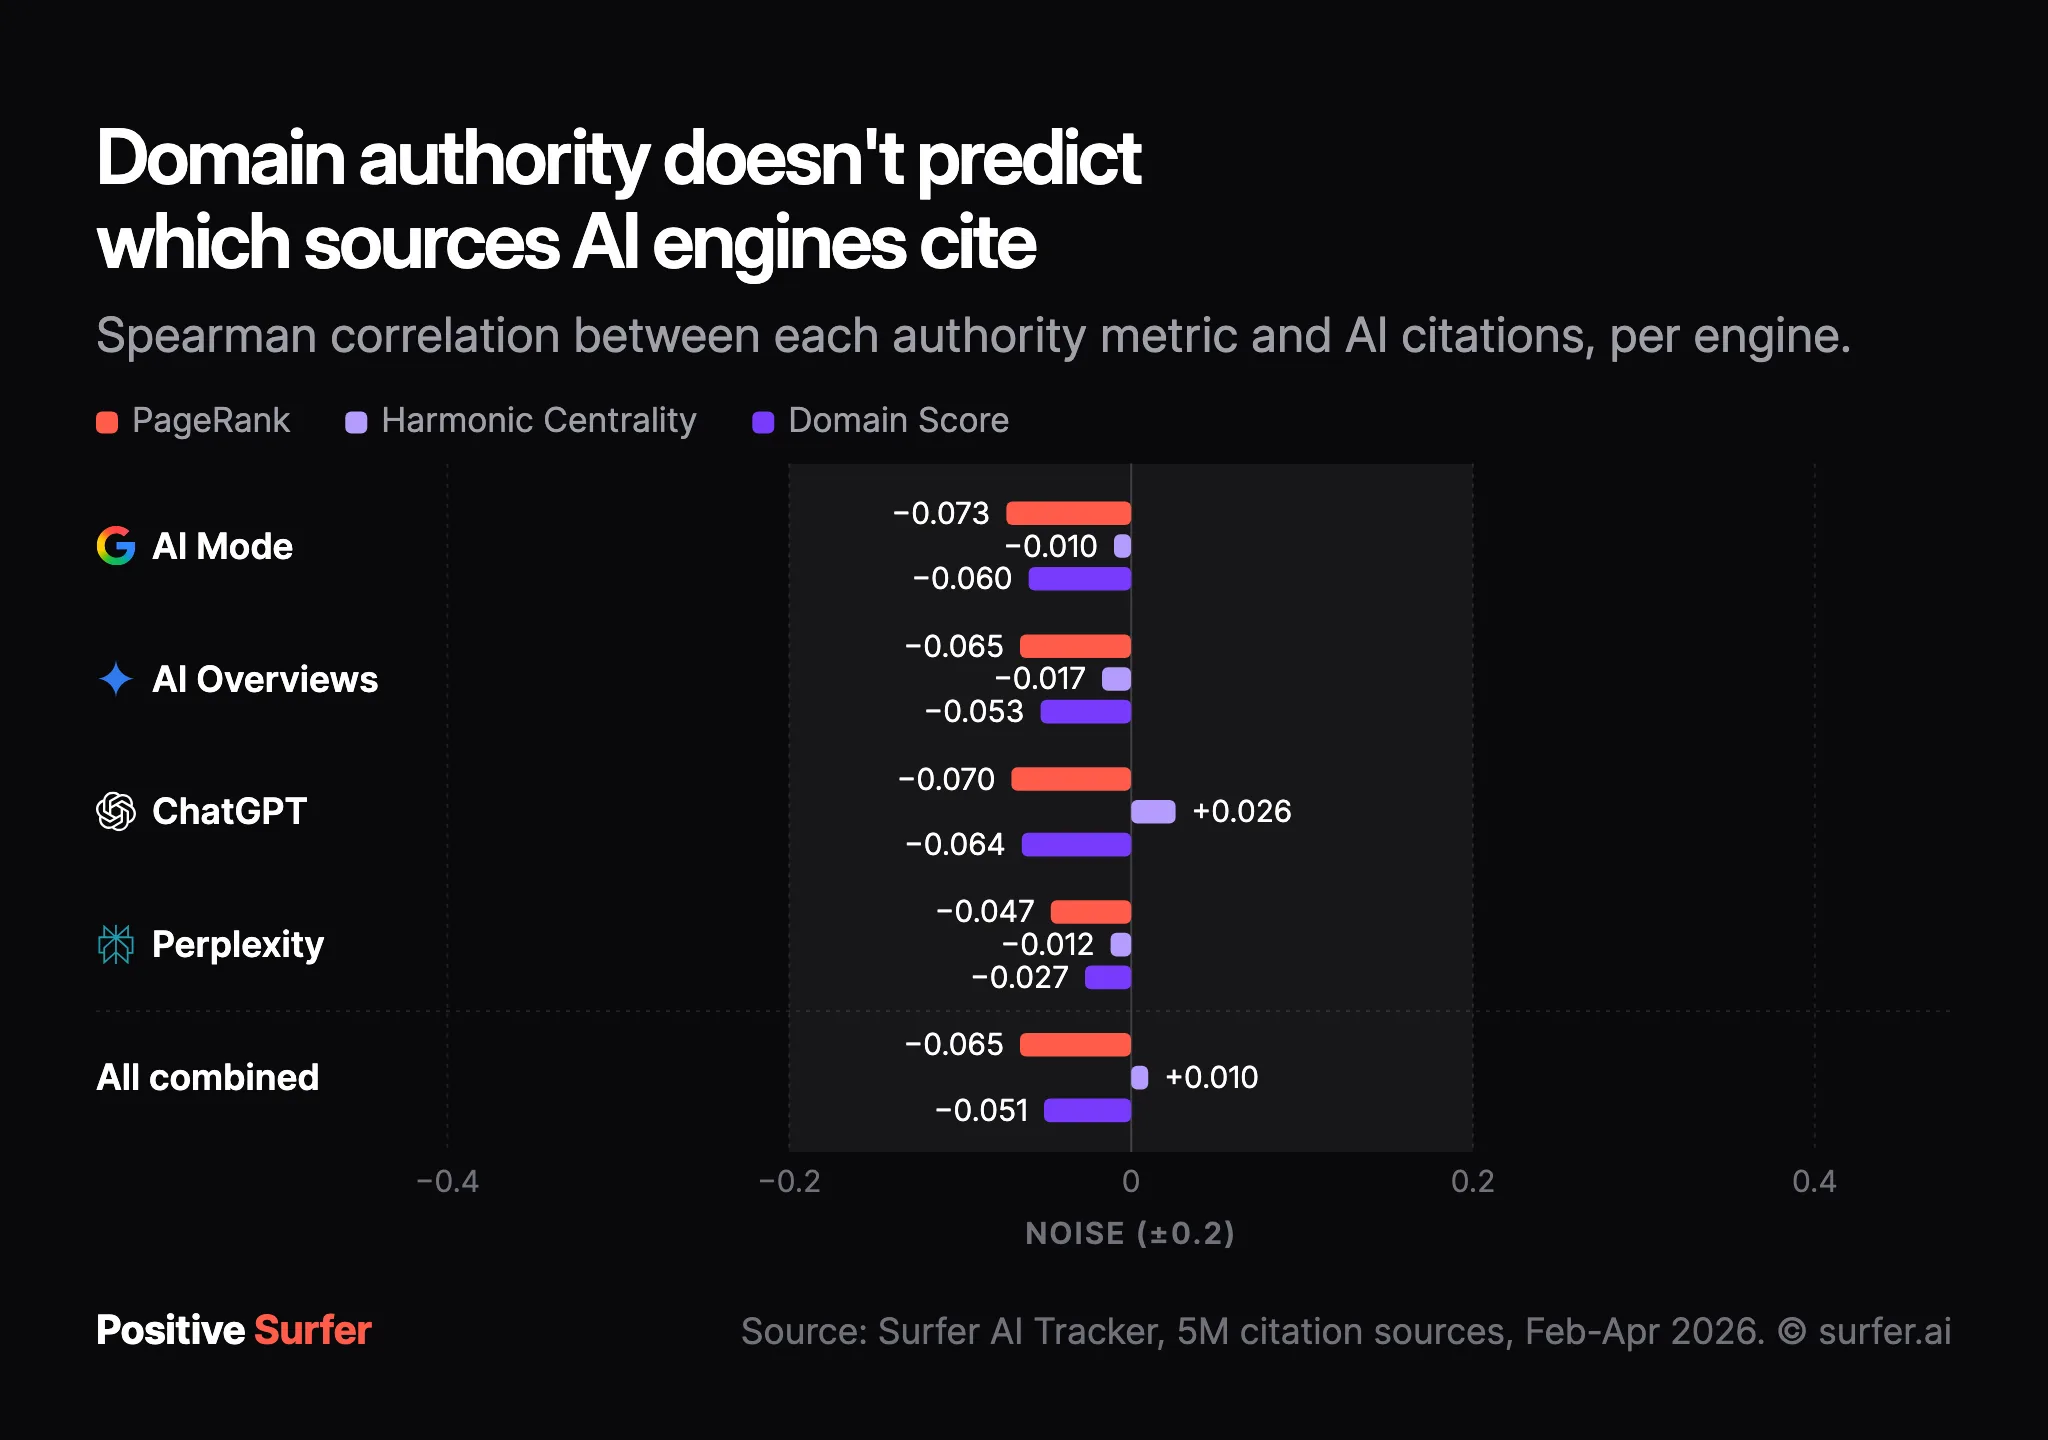
Nous avons ensuite mesuré la corrélation entre la probabilité d’être cité et trois indicateurs d’autorité de domaine différents : le PageRank et la Harmonic Centrality de Common Crawl, et le Domain Score de Surfer via DataForSEO.
Résultat ?
L’autorité de domaine est corrélée négativement à la fréquence des citations par l’IA, mais à peine. La corrélation est si proche de zéro qu’elle relève du bruit.
Quelques définitions rapides, au cas où ces termes seraient nouveaux pour vous :
Le PageRank mesure l’importance d’une page en fonction des sites qui pointent vers elle. C’est l’idée classique de l’ère Google : un lien est un vote, et les votes de pages déjà importantes comptent davantage que ceux de pages obscures. Une page qui reçoit beaucoup de liens de qualité obtient un PageRank élevé.
La Harmonic Centrality (centralité harmonique) mesure à quel point un domaine est bien connecté au sein du « graphe du web » (l’ensemble d’Internet modélisé comme des pages reliées par des liens). Un score élevé signifie que l’on peut atteindre le domaine en très peu de sauts de lien depuis presque n’importe où sur le web : il se situe au centre de tout, comme Wikipedia ou Reddit. Un score faible signifie qu’il est relégué en périphérie.
Le Domain Score est l’indicateur global de puissance de domaine de Surfer (dans le même esprit que les scores d’« autorité de domaine » que vous avez peut-être vus ailleurs) : il combine les signaux de liens en une seule note de 0 à 100.
Ce sont trois façons différentes de répondre à la même question de base : quelle est la force ou l’autorité de ce domaine ? C’est exactement l’hypothèse que nous voulions tester.
Voici les corrélations de Spearman brutes (je sais qu’elles sont un peu difficiles à lire sur le graphique) :
Mais que se passe-t-il quand on découpe les données un peu plus finement ? Est-ce que quelque chose change ? Et qu’est-ce que cela signifie concrètement pour votre stratégie de recherche IA (GEO, AEO, LLMO, EIEIO, quel que soit son nom cette semaine) ?
Creusons un peu.
Avant de continuer : une remarque rapide sur les données
Toutes les données de cet article reposent sur un sous-échantillonnage.
Qu’est-ce que cela signifie ? Nous avons réparti toutes les sources en 20 groupes égaux selon leur fréquence d’apparition dans les réponses, puis tiré une source dans chaque groupe.
Pourquoi avoir procédé ainsi ? Pour écarter une source d’erreur potentielle. Nous avons en effet remarqué qu’une poignée de sources centrales apparaissent sans cesse dans les réponses de l’IA, et qu’une longue traîne de sources n’apparaissent que rarement. Calculer une corrélation directe sur une distribution aussi déséquilibrée revient à laisser les sources les plus citées dominer les résultats et tout fausser. Avec le sous-échantillonnage, chaque niveau de fréquence de citation pèse le même poids dans la corrélation.
Cela dit, les résultats étaient similaires avec et sans sous-échantillonnage.
Quelques domaines forts semblent presque entièrement responsables de la légère corrélation négative
Il paraît plausible que l’autorité de domaine ne prédise pas fortement la fréquence des citations par l’IA. Mais une relation négative ? Voilà qui est étrange.
Notre hypothèse : cela pourrait tenir à la surreprésentation massive, dans le jeu de données, d’éditeurs très connus comme Reddit et Wikipedia. Ces sites atteignent l’étape de sélection des sources de la réponse bien plus souvent que les autres, car ils couvrent presque tous les sujets et sont très bien classés dans l’index. Le LLM les voit donc fréquemment comme des candidats à la citation.
Mais cela ne suffit pas à expliquer la corrélation négative.
Les ingénieurs des moteurs de recherche IA semblent appliquer une forme de régularisation pour déprioriser ces domaines, car leur domination ne s’accompagne pas forcément des meilleures réponses.
Pour le vérifier, nous avons retiré entièrement du jeu de données les 5 % de domaines les plus forts et recalculé la corrélation.
Résultat ? Les légères corrélations négatives ont en grande partie disparu et se sont rapprochées encore davantage de zéro, sur les quatre modèles d’IA et les trois indicateurs d’autorité.
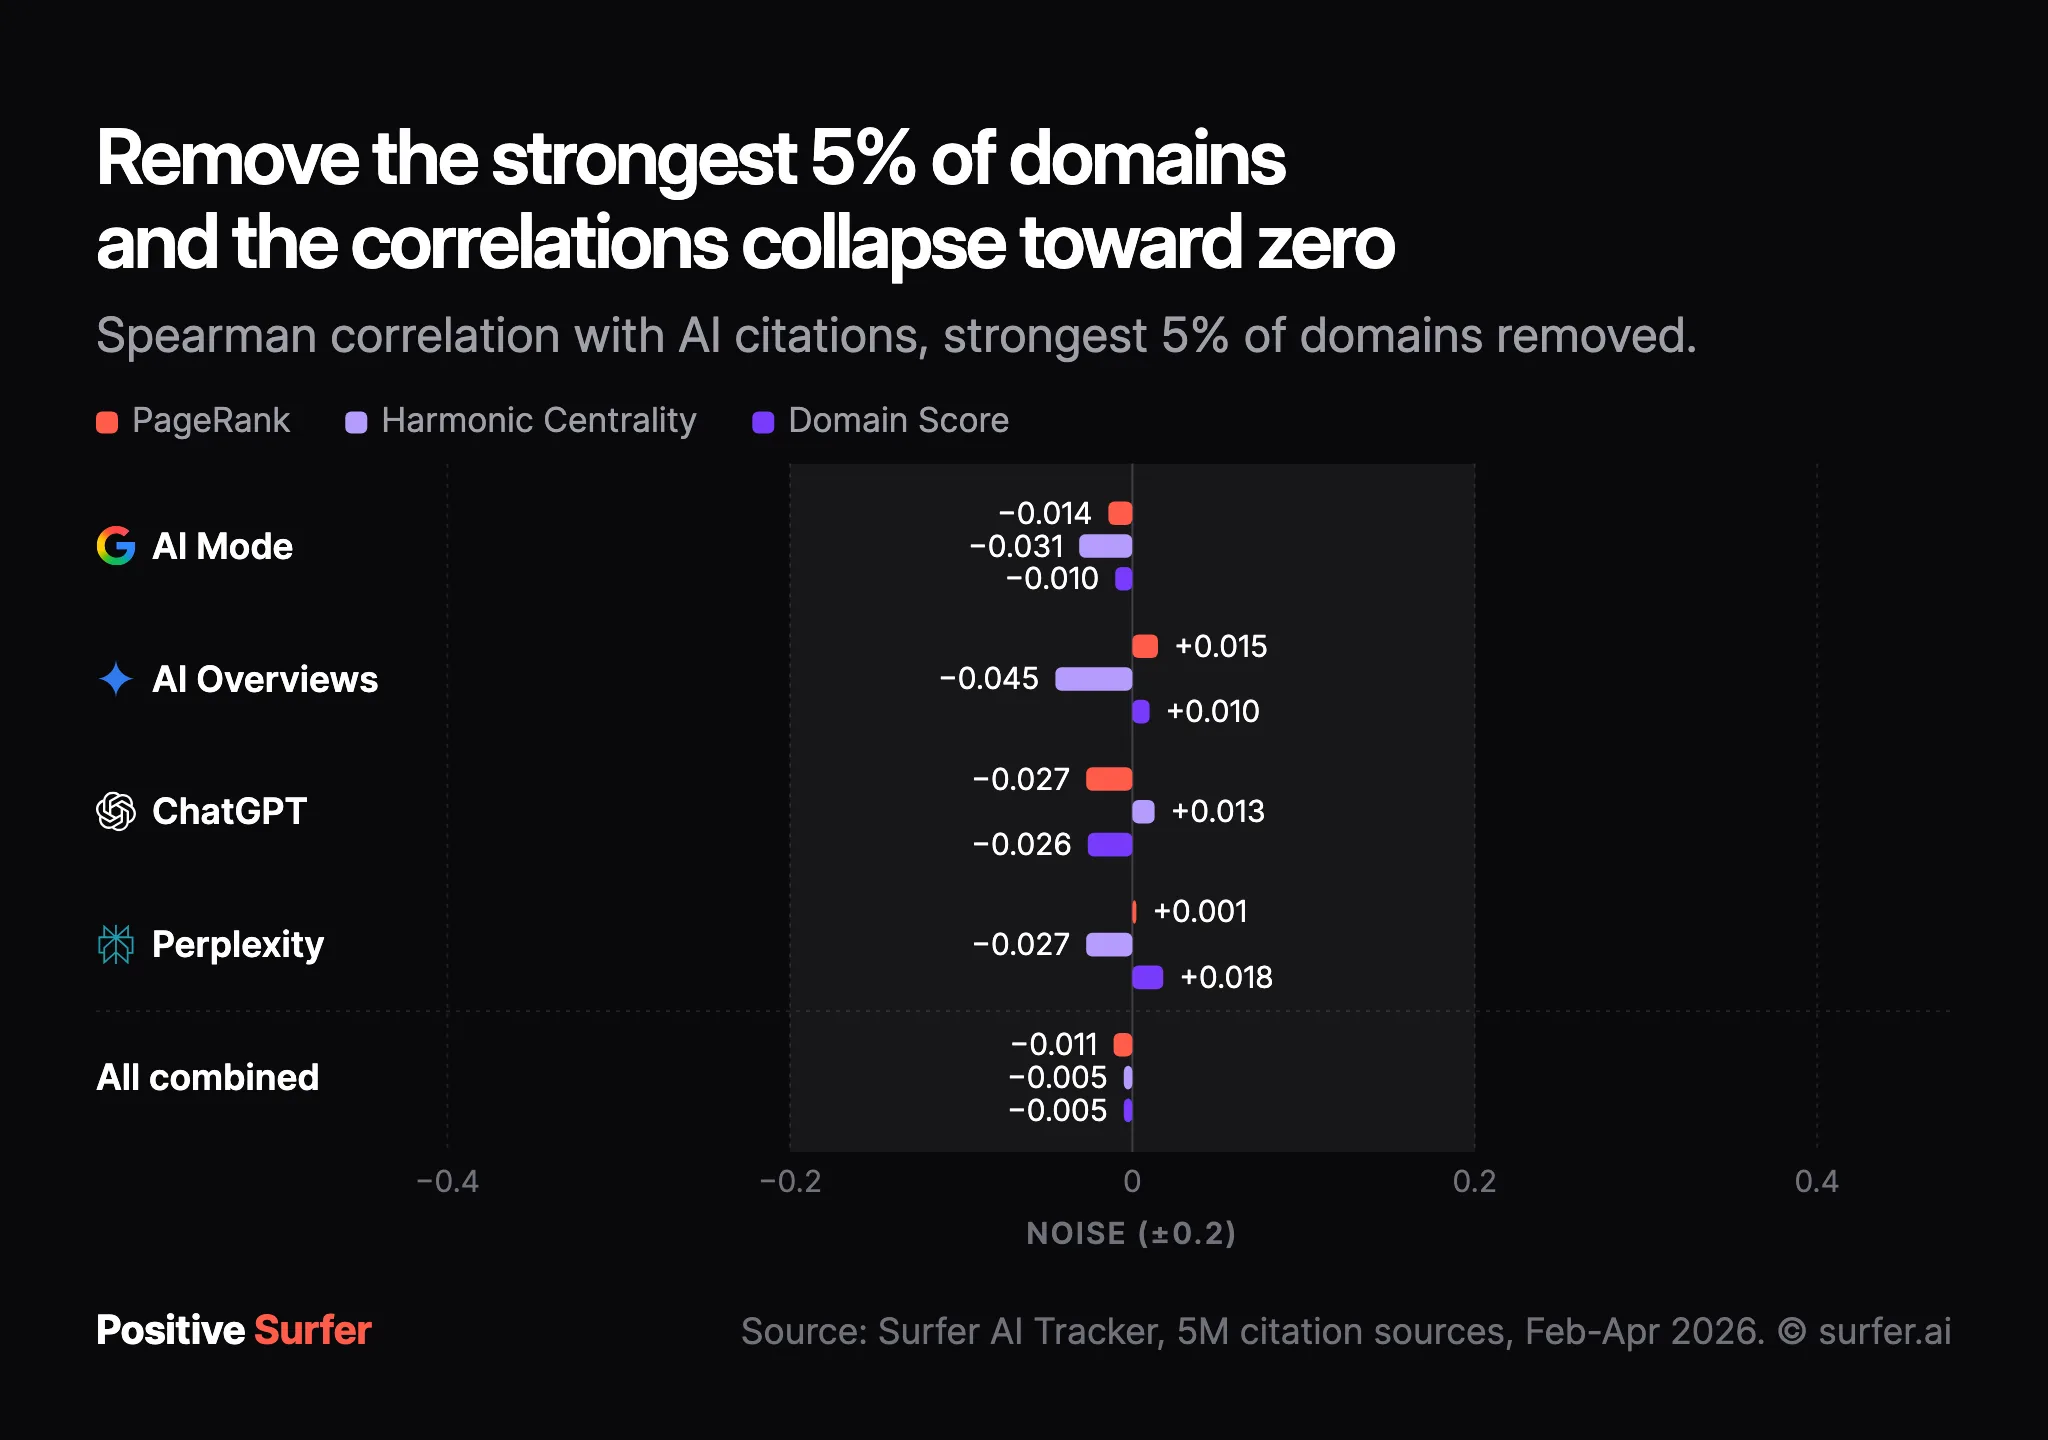
Voici les corrélations de Spearman brutes sans les 5 % de domaines les plus forts :
Comme nous le supposions, cela semble indiquer que les moteurs de réponse IA dépriorisent activement les domaines les plus forts, peut-être pour diversifier leurs sources, éviter de trop dépendre d’une poignée de méga-éditeurs, ou les deux.
Une autre explication serait toutefois que les domaines les plus forts publient beaucoup moins souvent du contenu citable que les plus faibles. Cela ne s’applique évidemment pas à des sites comme Wikipedia, mais on voit bien comment cela pourrait s’appliquer à des plateformes comme X (Twitter), qui semblent de plus en plus abriter des polémiques creuses plutôt que des informations réellement utiles.
Quoi qu’il se passe ici, Perplexity semble un peu moins enclin que les autres modèles à déprioriser les domaines forts. Mais même Perplexity ne semble pas récompenser activement l’autorité.
Ne garder que les articles de blog rend les corrélations très légèrement positives
Nous avons aussi filtré le jeu de données pour ne garder que les articles de blog, plus précisément les URL contenant /blog/. (Ce n’est évidemment pas un indicateur parfait, mais il devrait en couvrir la plupart.)
Résultat ? Les corrélations deviennent très légèrement positives sur la plupart des modèles et des indicateurs, à une exception flagrante près.
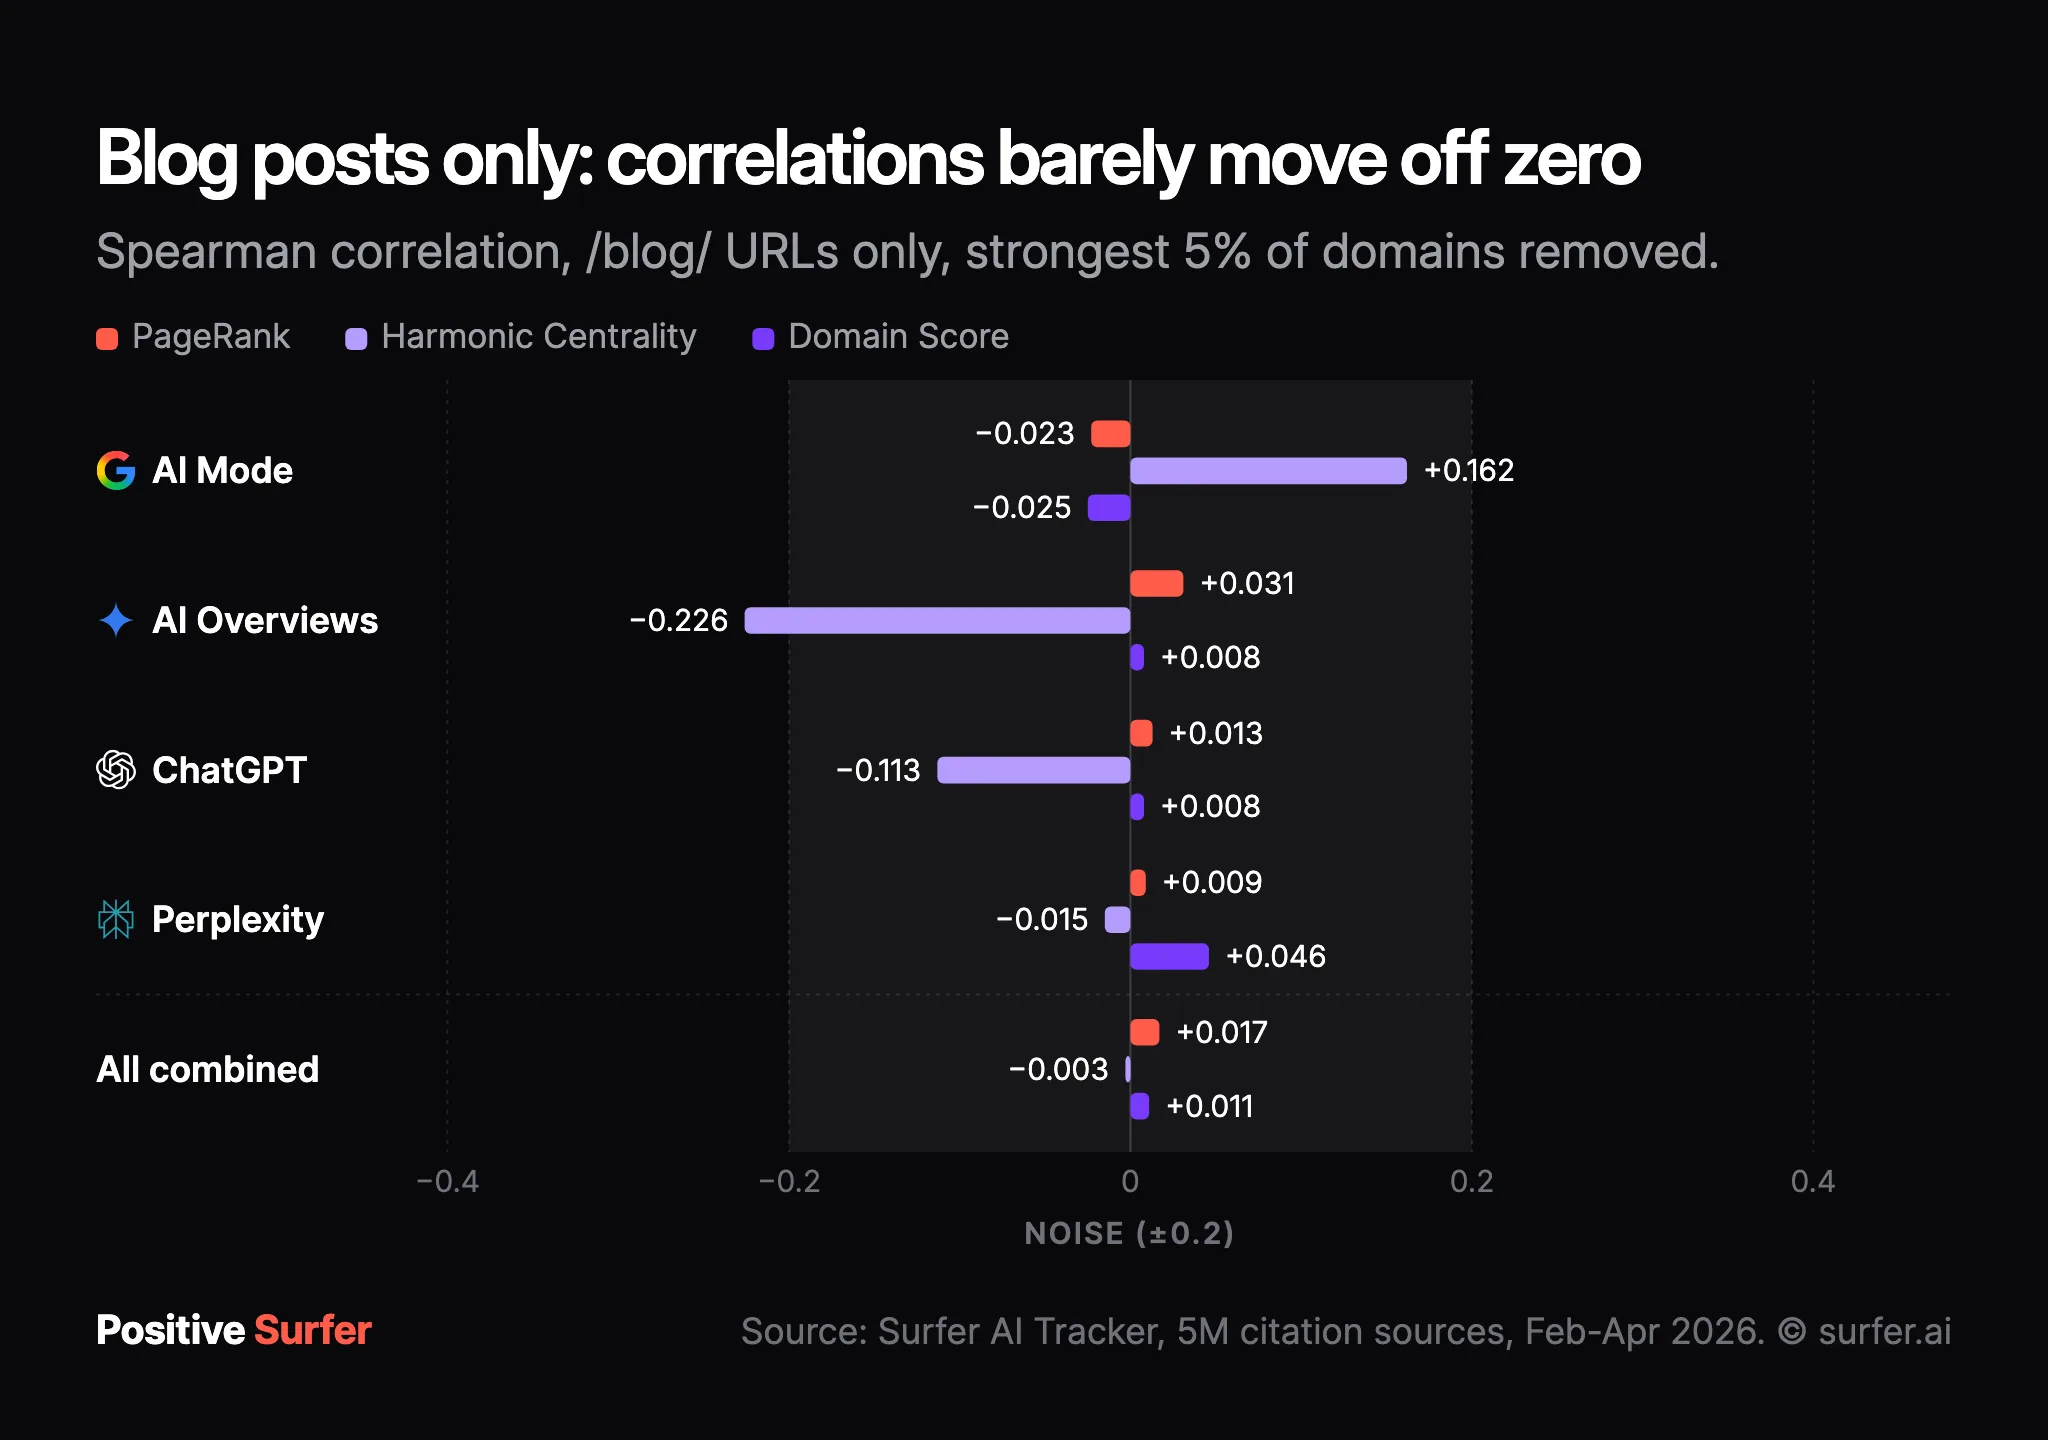
Voici les corrélations brutes :
REMARQUE. Les 5 % de domaines les plus forts sont toujours exclus de ces données.
Alors que le PageRank et le Domain Score tombent au niveau du bruit pur, la Harmonic Centrality (HC) fait les montagnes russes. Elle grimpe à une corrélation légèrement positive (+0,162) dans AI Mode, mais plonge vers une corrélation négative plus marquée (-0,226) pour AI Overviews.
Alors… que se passe-t-il ?
J’ai posé la question à notre data scientist, Maciej Gruszczyński, et il a souligné une nuance importante et fascinante sur la façon dont les LLM sont construits, qui pourrait expliquer ce chaos.
En résumé, il est bien connu dans le milieu de la data science que le robot de Common Crawl priorise son exploration du web selon la Harmonic Centrality. Les domaines à HC élevée sont donc davantage explorés, et par conséquent bien mieux représentés dans les immenses jeux de données qui servent à entraîner ces LLM. Et si vous faites partie des connaissances de base du modèle, vous êtes naturellement un bon candidat pour être mis en avant.
Mais même en retirant les grands sites multithématiques comme Wikipedia ou Reddit et en ne gardant que les URL en /blog/, il reste deux groupes très différents : les blogs de niche et les blogs généralistes.
Les blogs généralistes abordent une immense variété de sujets, ce qui leur donne naturellement un score de Harmonic Centrality plus élevé et une représentation plus large dans les données d’entraînement des LLM. Les blogs de niche, eux, restent concentrés sur un sujet très précis.
Comme le dit Maciej :
Je ne peux pas expliquer pourquoi c’est si positif ou si négatif selon les modèles. Ce serait lire dans le marc de café, mais les deux facteurs que j’ai décrits (la priorisation du robot et la distinction entre blogs de niche et blogs généralistes) peuvent assurément jouer un rôle important.
Mais laissons de côté les détours techniques et les fortes variations de la HC, et regardez ce qui est arrivé au PageRank et au Domain Score. S’ils restent tous deux extrêmement proches de zéro, le filtre sur les articles de blog les a fait passer en territoire légèrement positif sur presque tous les modèles.
Cela signifie-t-il que les articles de blog ont un poids propre dans les moteurs de recherche IA, quelle que soit l’autorité du domaine ?
C’est une hypothèse intéressante, qui rejoindrait les conclusions de notre précédente étude sur la présence des marques et les recommandations de l’IA. Cette étude montrait que les mentions dans des articles de blog sont plus fortement corrélées à la force de recommandation que tout autre type de contenu, alors que les blogs ne représentent que 28,7 % de l’ensemble des sources citées.
Mais vu l’ampleur des variations de la HC entre positif et négatif selon le modèle, je resterais prudent avant de tirer des conclusions définitives. La vue d’ensemble ne change pas : les indicateurs traditionnels ne sont plus un sésame.
Qu’est-ce que tout cela signifie pour la recherche IA, et que devez-vous faire ?
L’autorité de domaine ne semble avoir aucun impact significatif sur la probabilité d’être cité par les moteurs de recherche IA. C’est la conclusion à retenir.
Bien sûr, cela ne veut pas dire que les facteurs off-page sont totalement hors jeu dans la recherche IA. Il existe bien d’autres signaux que nous n’avons pas mesurés, et certains pourraient tout à fait compter.
Mais les études que j’ai vues jusqu’ici, y compris celle-ci, vont toutes dans le même sens : les indicateurs d’autorité traditionnels fondés sur les liens semblent prédire bien moins le succès dans la recherche IA que dans la recherche traditionnelle.
Et si l’autorité compte moins, on en conclut naturellement que le contenu compte probablement davantage.
C’est une bonne nouvelle. Car contrairement à l’autorité, le contenu est un terrain sur lequel tout le monde peut rivaliser.
Mais comment créer un contenu réellement compétitif, qui a toutes les chances d’être cité par l’IA et de se positionner dans la recherche traditionnelle ?
Je trouve que cette citation tirée d’un article récent de Gianluca Fiorelli le résume bien :
La position gagnante, pour le classement traditionnel comme pour les citations de l’IA, est un contenu ancré dans le consensus établi qui apporte en même temps une information réellement nouvelle.
Le nouveau workflow de l’éditeur de contenu de Surfer est construit précisément autour de cette idée.
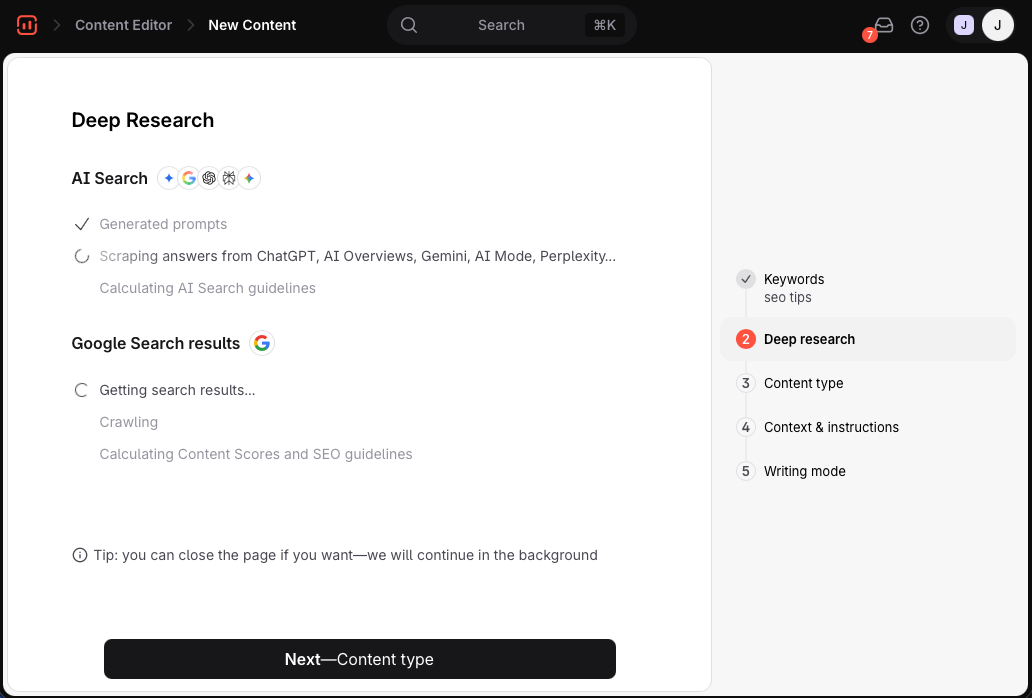
Par exemple, disons que je saisis « link building tips » (conseils de netlinking) comme sujet. Surfer mène d’abord une recherche approfondie sur ChatGPT, AI Overviews, Gemini, AI Mode, Perplexity et la première page de Google pour déterminer ce qui compte vraiment : les entités clés, les sous-thèmes, les faits et les informations à couvrir au minimum pour avoir une vraie chance, dans la recherche traditionnelle comme dans les réponses de l’IA.
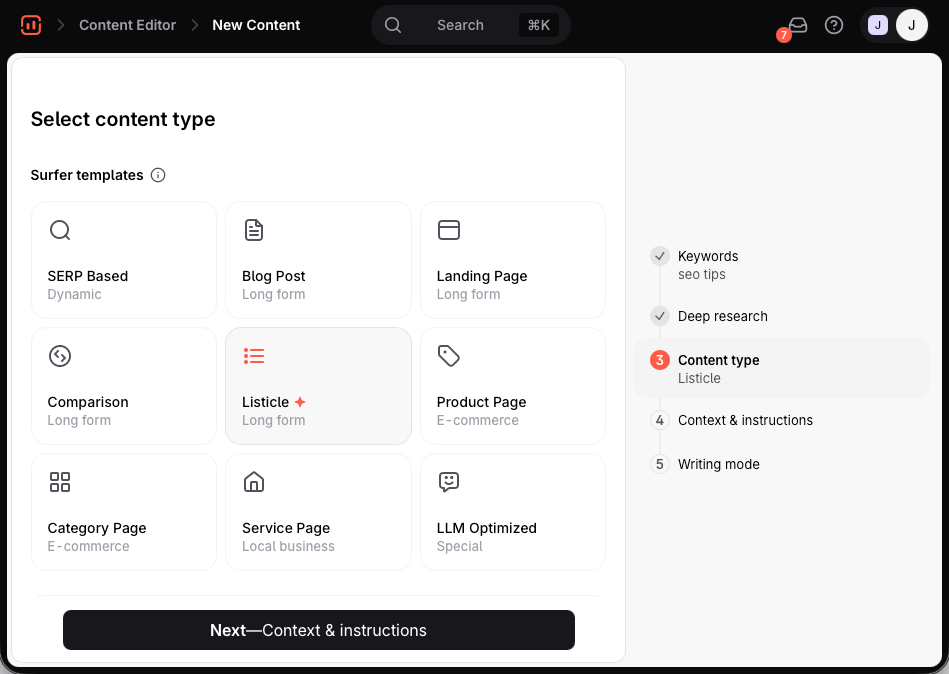
Il recommande ensuite le meilleur format de contenu en fonction de cette recherche.
Puis (et c’est à mon avis l’étape la plus importante), il demande du contexte et des instructions supplémentaires. C’est là que vous ajoutez ce qui distingue vraiment votre contenu : recherche originale, opinions tranchées, données propriétaires, citations d’experts, etc.
Dans mon cas, je lui ai fourni un ensemble de citations recueillies auprès de SEO vraiment brillants et lui ai demandé de les intégrer tout au long du texte.
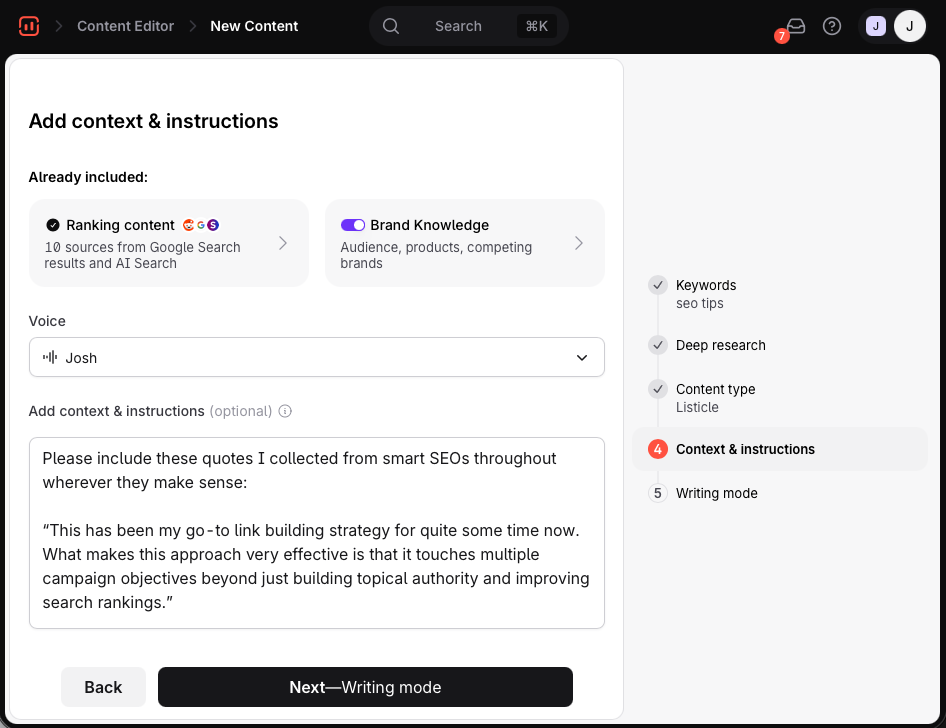
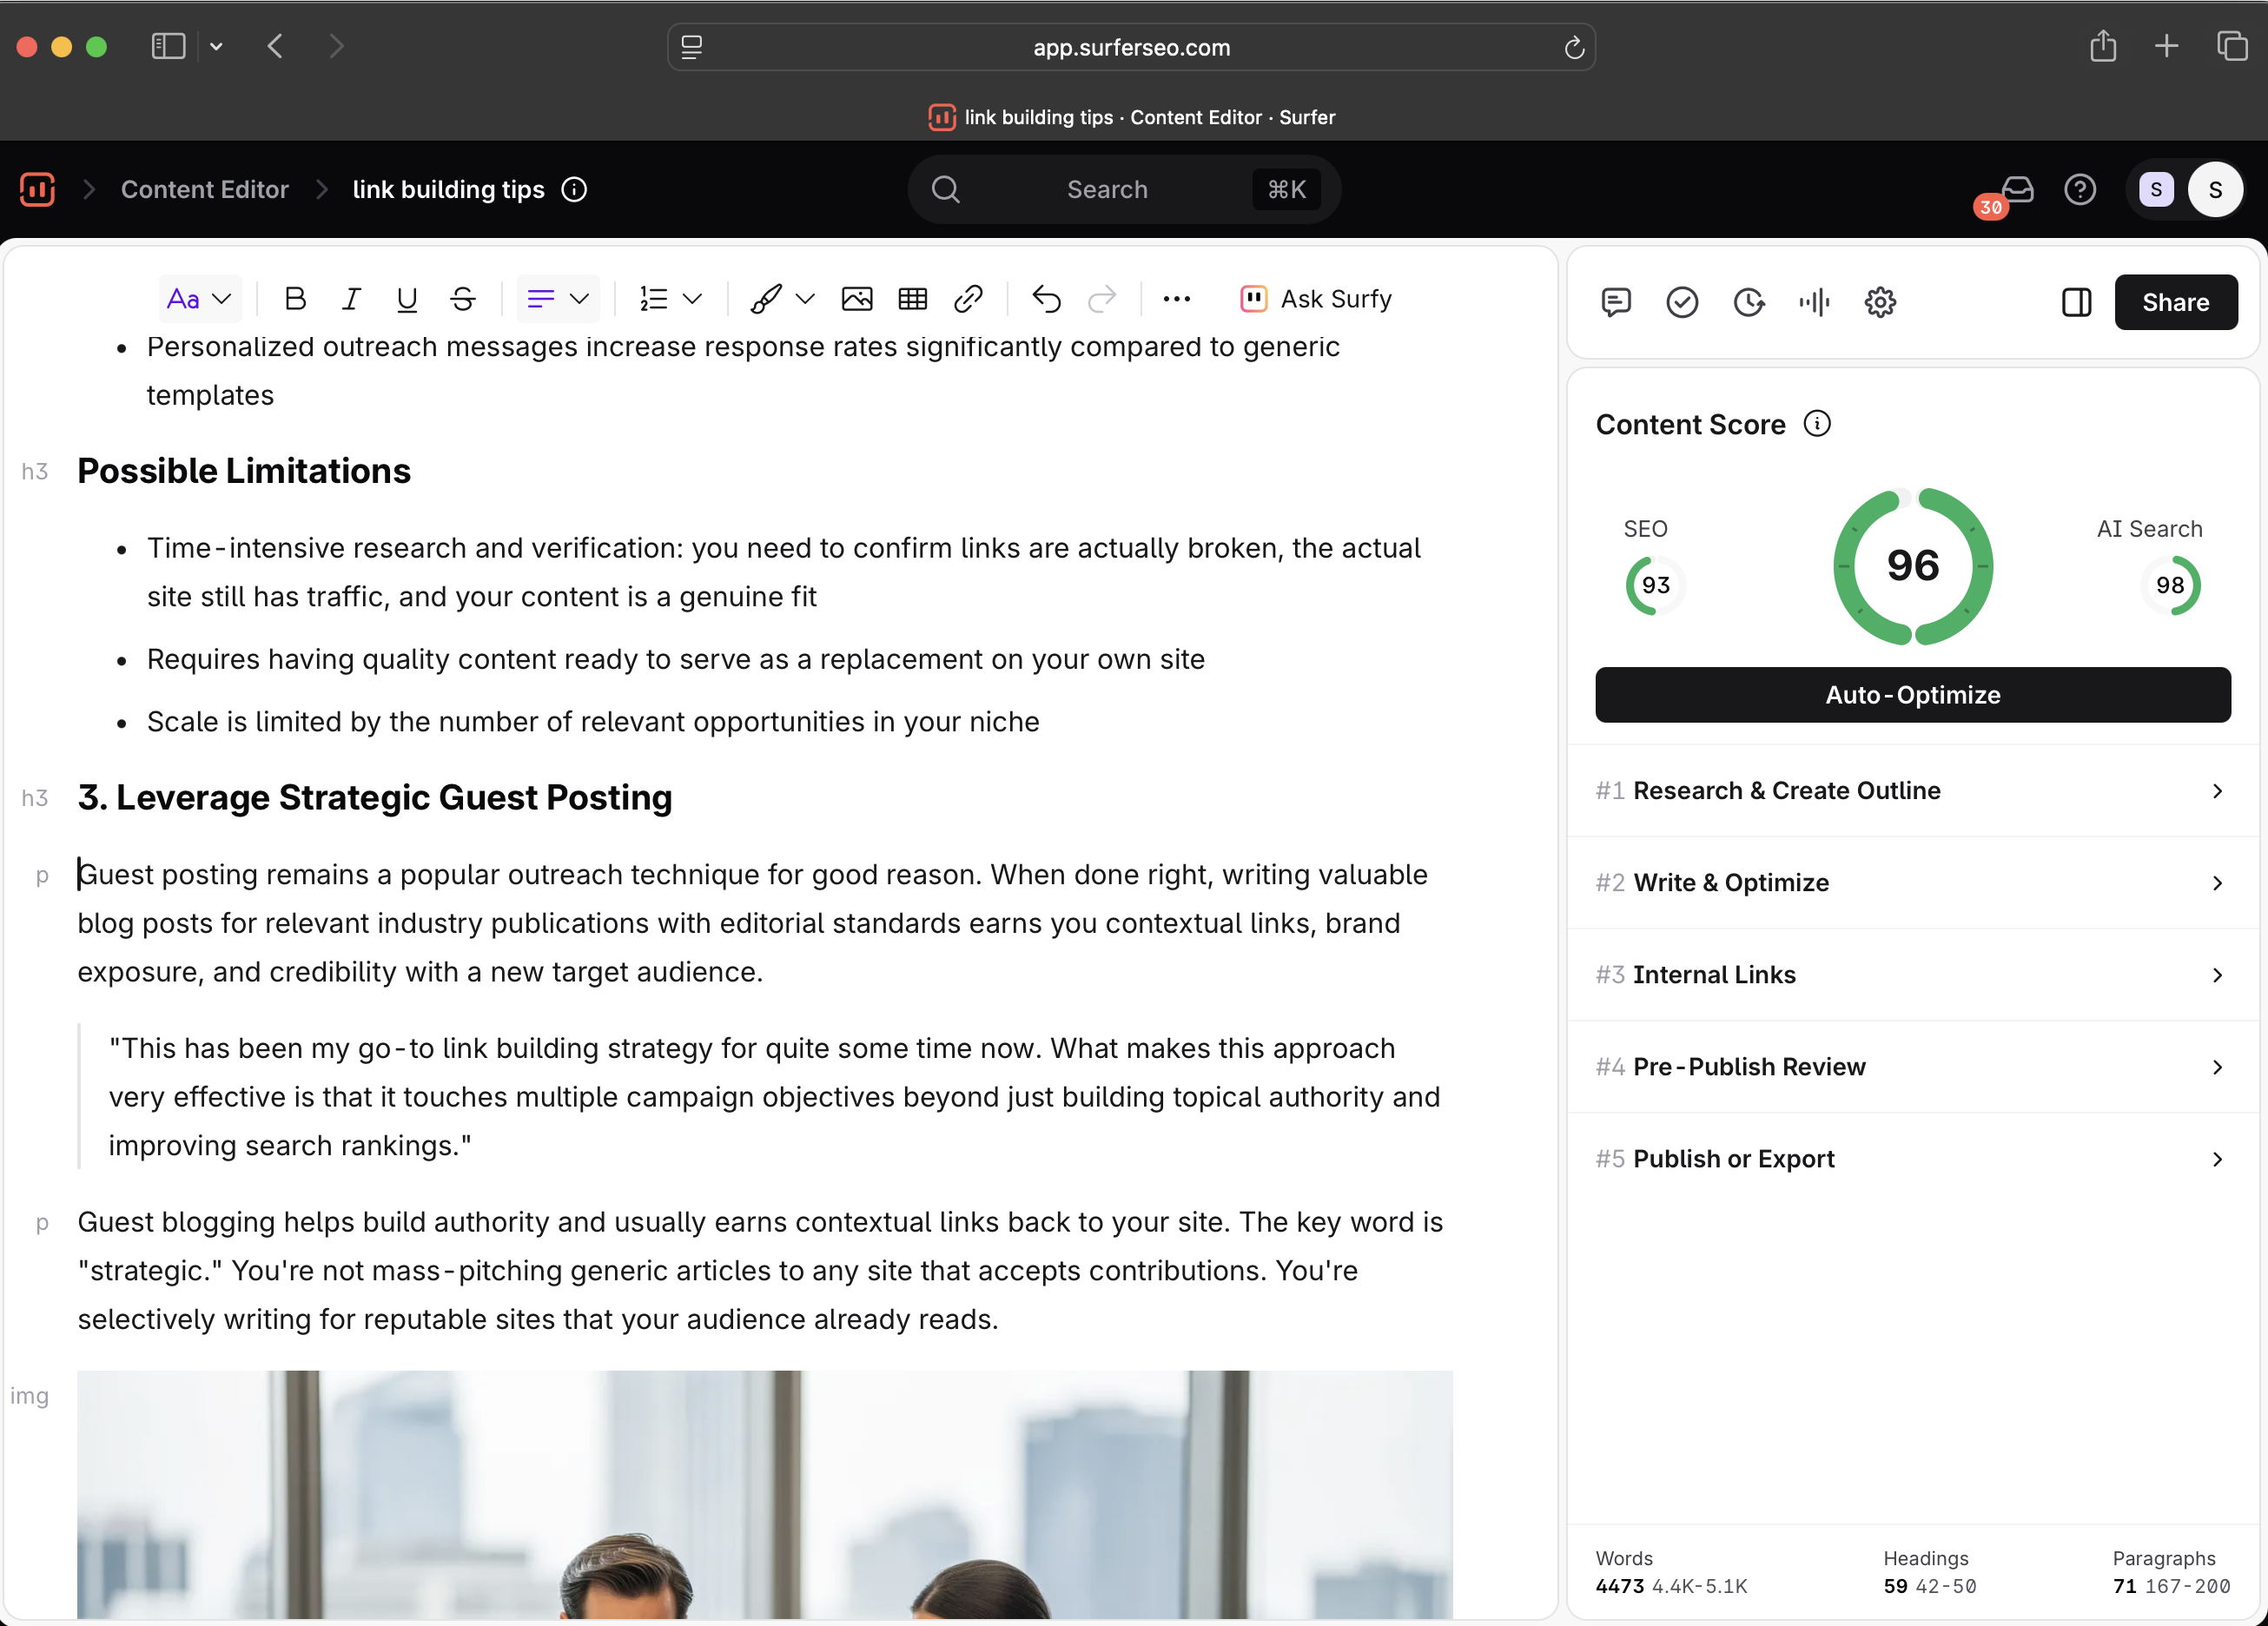
À partir de là, il génère le contenu dans votre style, avec tout ce matériau original intégré. Et le résultat est… ma foi, sacrément bon (voir ci-dessous).
(Vous préférez écrire vous-même et ne recourir à l’IA qu’en cas de besoin ? C’est possible aussi.)
Vous pouvez voir qu’il a intégré les citations que je lui avais fournies, en contexte, dans des conseils qui ont du sens. Il a aussi optimisé mon article pour tous les aspects fastidieux en arrière-plan, comme le montre le Score de contenu de 93/100.
Ce que j’apprécie, c’est que cela me libère du temps pour les parties amusantes de la création de contenu (se forger une opinion originale, mener des recherches, trouver des éclairages inédits), tandis que l’outil se charge de l’optimisation et de l’essentiel de la rédaction.
Faut-il encore un peu de retouches ? Bien sûr. Mais c’est le cas de tout premier jet, surtout si c’est moi qui l’écris !
Vous voulez voir ce qu’il donne sur votre sujet ? Essayez gratuitement l’éditeur de contenu.