Le query fan-out (ramification de la requête) est la technique qu’utilisent les moteurs de recherche IA comme Google AI Mode, ChatGPT et Perplexity pour découper un prompt en plusieurs sous-requêtes associées, lancer une recherche web pour chacune et fusionner les résultats en une seule réponse. C’est lui qui détermine les pages qu’un système d’IA envisage même de citer. Dans l’étude de Surfer portant sur 10 000 mots-clés, les pages positionnées sur la requête principale et sur ses requêtes dérivées avaient 161 % de chances en plus d’être citées dans les AI Overviews de Google que les pages positionnées sur la seule requête principale.
Ce guide explique comment fonctionne le query fan-out, combien de sous-requêtes chaque moteur d’IA lance, ce que les recherches de Surfer ont révélé sur les requêtes dérivées et comment optimiser vos contenus pour elles sans courir après chaque requête. Il s’adresse aux SEO et aux équipes contenu qui veulent gagner en visibilité dans la recherche IA.
Qu’est-ce que le query fan-out ?
Le query fan-out désigne le fait qu’un système d’IA étende une requête d’utilisateur en plusieurs recherches associées, récupère les résultats de chacune et s’en serve pour construire sa réponse finale. Google décrit les requêtes dérivées comme un ensemble de requêtes simultanées et associées que le modèle génère pour obtenir des résultats de recherche pertinents supplémentaires sur la question de l’utilisateur.
L’exemple donné par Google : pour la requête « how to fix a lawn that’s full of weeds » (comment rattraper une pelouse envahie de mauvaises herbes), les requêtes dérivées pourraient inclure « best herbicides for lawns » (meilleurs désherbants pour pelouse), « remove weeds without chemicals » (éliminer les mauvaises herbes sans produits chimiques) et « how to prevent weeds in lawn » (comment empêcher les mauvaises herbes dans la pelouse). Chacune de ces sous-requêtes a ses propres résultats de recherche, et l’IA peut citer des pages issues de n’importe lesquels d’entre eux.
Google a introduit le terme lors de la conférence I/O 2025, quand sa responsable de la recherche, Elizabeth Reid, a expliqué qu’AI Mode reconnaît quand une question exige un raisonnement avancé, utilise une version personnalisée de Gemini pour la découper en sous-thèmes et lance de nombreuses requêtes à la fois pour le compte de l’utilisateur. Mais le fan-out n’est pas propre à Google. ChatGPT, Perplexity, Gemini, Grok et Claude lancent tous leurs propres sous-requêtes quand ils effectuent une recherche sur le web.
Voici à quoi cela ressemble dans ChatGPT. Avec Keyword Surfer, l’extension Chrome gratuite de Surfer, vous pouvez voir les recherches que ChatGPT a lancées derrière une réponse :
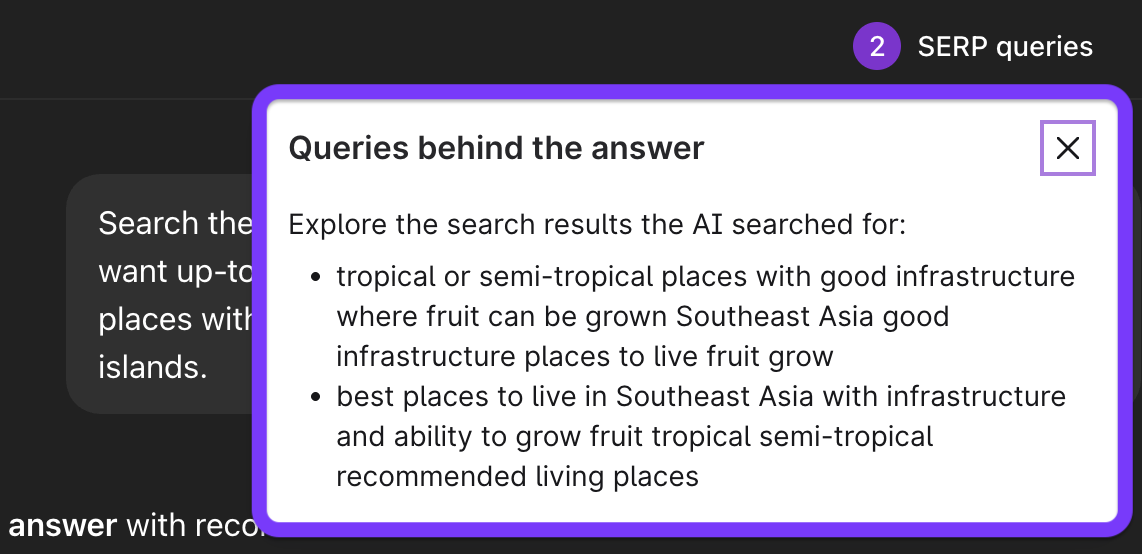
Les requêtes dérivées ressemblent aux recherches qu’une personne ferait de toute façon, simplement condensées en une seule étape. ChatGPT fusionne ensuite ce qu’il a trouvé en une seule réponse générée, avec ses sources citées.
Query fan-out et expansion de requête
L’expansion de requête est une technique de recherche plus ancienne : le moteur ajoute des synonymes et des termes associés à une requête pour récupérer davantage de documents pertinents. Le query fan-out va plus loin. Au lieu d’élargir une recherche, le modèle d’IA rédige plusieurs recherches distinctes (parfois appelées requêtes synthétiques), les lance en parallèle et raisonne sur l’ensemble des résultats avant de rédiger sa réponse finale.
Le query fan-out dans la recherche IA et le fan-out dans les bases de données
Le terme « fan-out » a aussi un sens plus ancien en génie logiciel : une requête à une base de données ou à une API qui déclenche de nombreuses requêtes en aval, au risque d’augmenter la latence et les coûts. Ce guide porte sur le sens qu’il a dans la recherche IA, où le fan-out se produit à l’intérieur d’un moteur de recherche et détermine quelles pages web sont récupérées et citées.
Comment fonctionne le query fan-out
La mise en œuvre exacte varie d’un système de recherche IA à l’autre, mais le processus suit toujours les cinq mêmes étapes :
- Interpréter le prompt. Le modèle d’IA identifie l’intention de l’utilisateur derrière la requête d’origine et décide s’il a besoin d’informations récentes venues du web. Les questions simples reçoivent souvent une réponse tirée des seules connaissances du modèle, sans aucun fan-out.
- Générer des sous-requêtes. Le modèle découpe une requête large en requêtes de recherche précises : définitions, comparaisons, prix, avis, alternatives et questions de suivi que l’utilisateur posera probablement ensuite. Le contexte compte : la ville de l’utilisateur, l’historique de la conversation et ses données personnelles peuvent changer les sous-requêtes générées.
- Récupérer les résultats. Chaque sous-requête est envoyée à un index de recherche, qui renvoie ses propres résultats. C’est pourquoi une page qui ne se positionne pas sur la requête d’origine peut tout de même être récupérée via une requête dérivée.
- Sélectionner des passages. Le système extrait les passages les plus pertinents des pages récupérées, et non des pages entières, et les compare pour leur exactitude et leur couverture.
- Synthétiser la réponse finale. L’IA rédige une réponse directe à partir des passages sélectionnés et cite certaines des sources utilisées.
7 types de requêtes dérivées
L’analyse des demandes de brevet de Google menée par Ahrefs décrit sept types de sous-requêtes générées par les moteurs de recherche IA. Voici à quoi elles ressembleraient pour le prompt « best running shoes for flat feet » (meilleures chaussures de running pour pieds plats) :
Essayez vous-même. Choisissez un exemple ci-dessous ou saisissez un sujet pour voir les angles vers lesquels les moteurs d’IA se ramifient généralement :
Combien de requêtes dérivées les moteurs d’IA lancent-ils ?
Cela dépend beaucoup du moteur d’IA et du prompt. Les produits IA de Google sont ceux qui ramifient le plus, tandis que ChatGPT et Perplexity ne lancent généralement que quelques recherches par prompt.
- Google AI Mode :Ahrefs indique qu’AI Mode génère généralement 5 à 11 sous-requêtes. Citant des données de Seer Interactive et de Nectiv, il ajoute que 59 % des prompts déclenchent 5 à 11 recherches et 24 % en déclenchent 12 à 19.
- Gemini 3 (la famille de modèles derrière AI Mode) :Seer Interactive a mesuré 10,7 requêtes dérivées par prompt sur 501 prompts avec l’API Gemini 3, soit 78 % de plus que les 6,01 de Gemini 2.5. La fourchette allait de 3 à 28 par prompt.
- Gemini avec grounding : lors du test de Surfer portant sur 1 600 exécutions, la plupart des prompts ont déclenché jusqu’à cinq requêtes dérivées, généralement deux à quatre, et certains n’en ont déclenché aucune, car la SERP d’origine ou les connaissances du modèle suffisaient.
- ChatGPT, Perplexity et Grok :Peec AI a analysé 5 millions de requêtes dérivées en avril 2026 et en a relevé 2,1 par prompt pour ChatGPT, 1,4 pour Perplexity et 6,8 pour Grok.
- Modes de recherche approfondie : Google indique que Deep Search, dans AI Mode, peut lancer des centaines de recherches pour un seul rapport, et lors du test d’Ahrefs, ChatGPT Deep Research a lancé 420 recherches pour une seule question d’achat.
Les requêtes de ChatGPT deviennent aussi plus précises. Sur plus de 20 millions de requêtes dérivées de ChatGPT entre octobre 2025 et janvier 2026, leur nombre par prompt est resté stable, mais leur longueur moyenne a environ doublé, passant d’environ 6 mots à environ 12. ChatGPT rédige désormais des requêtes moins nombreuses, plus longues et plus précises, plutôt que d’en multiplier le nombre.
Ce que les recherches de Surfer ont révélé sur les requêtes dérivées
L’équipe data de Surfer a mené deux études sur les requêtes dérivées : l’une sur leur stabilité, l’autre sur leur effet sur les citations dans les AI Overviews de Google.
Les requêtes dérivées sont instables
Les modèles d’IA ne sont pas déterministes : donnez-leur deux fois le même prompt et vous pouvez obtenir des réponses différentes. Les requêtes dérivées ne font pas exception. Sur 1 600 exécutions avec le grounding de Gemini :
- Seules 27 % environ des requêtes dérivées sont restées identiques d’une exécution à l’autre du même prompt. Nous les appelons les mots-clés « core » (centraux).
- 66 % des requêtes dérivées ne sont apparues qu’une seule fois, et 0,6 % seulement sont apparues à chaque exécution.
Une liste de requêtes dérivées extraite aujourd’hui n’est donc qu’un instantané, pas une liste de mots-clés sur laquelle compter la semaine prochaine.
Mais elles restent proches de la requête d’origine
Les requêtes dérivées varient, mais ne s’éloignent pas beaucoup. La plupart avaient une similarité cosinus de 0,75 à 0,95 avec la requête d’origine : l’IA développe généralement la demande de l’utilisateur plutôt que de chercher des angles sans rapport. Pour « how to use hashtags on Instagram » (comment utiliser les hashtags sur Instagram), les requêtes dérivées comprenaient « how many hashtags on Instagram post » (combien de hashtags par publication Instagram), « Instagram story hashtags » (hashtags dans les stories Instagram) et « Instagram reel hashtags » (hashtags dans les reels Instagram). Elles ressemblent en tout point à des requêtes de recherche traditionnelles.
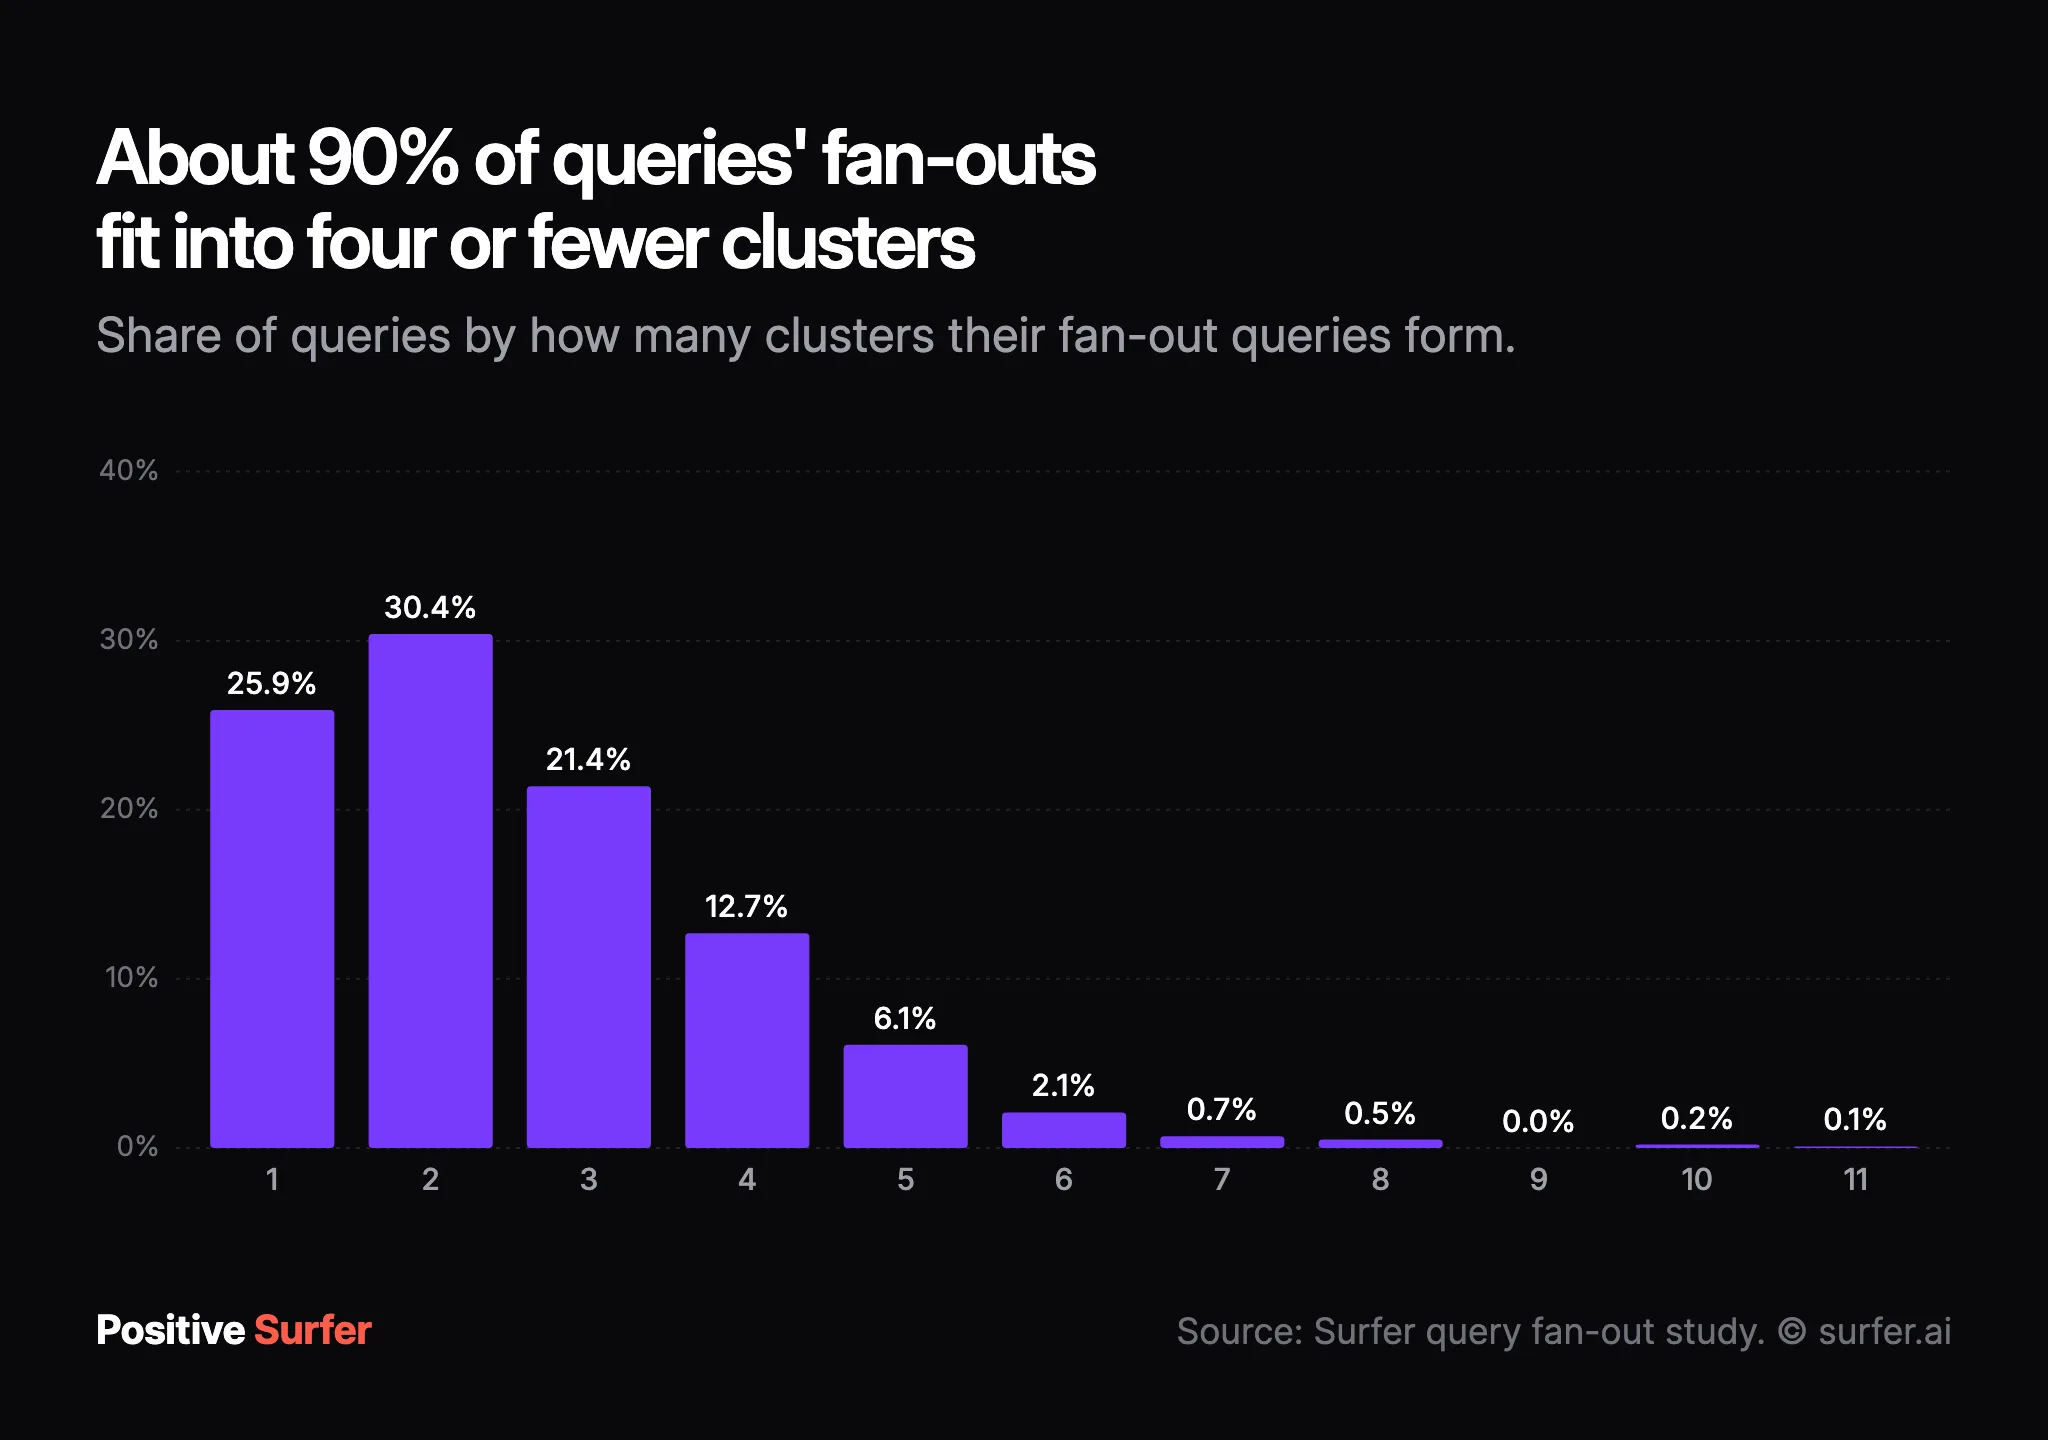
Elles partagent aussi des résultats de recherche. 84 % des requêtes dérivées avaient au moins une URL du top 20 en commun avec la requête d’origine, et 56 % en avaient cinq. Et environ 90 % des requêtes dérivées se répartissent dans quatre clusters au plus. C’est le constat clé pour l’optimisation : prises une à une, les requêtes dérivées sont imprévisibles, mais les clusters dans lesquels elles tombent sont stables.
Se positionner sur les requêtes dérivées vous fait citer
Dans la seconde étude, nous avons récupéré les 10 premières pages pour 10 000 mots-clés. 76 % avaient un AI Overview : nous avons donc utilisé Gemini pour extraire leurs requêtes dérivées (33 000 au total) et récupéré le top 10 de celles-ci aussi. Plus une page se positionnait sur un grand nombre de requêtes dérivées, plus elle avait de chances d’être citée dans l’AI Overview, avec une corrélation de Spearman de 0,77.
- 161 % de chances en plus d’être cité : parmi les pages citées qui se positionnent, 51,2 % se positionnaient sur la requête principale et sur au moins une requête dérivée, contre seulement 19,6 % sur la seule requête principale.
- Les requêtes dérivées l’emportent sur le mot-clé principal : les pages positionnées uniquement sur des requêtes dérivées étaient citées dans 29,2 % des cas, contre 19,6 % pour les pages positionnées uniquement sur la requête principale. C’est 49 % de plus.
- Le positionnement ne fait pas tout : 67,82 % des pages citées ne figuraient pas dans le top 10 pour la requête ni pour aucune requête dérivée. Pour les trois premières citations visibles, ce chiffre tombait à 45,86 % : la plupart des citations que les gens voient réellement sont donc bien positionnées.
Comme toujours avec ce type d’étude, corrélation n’est pas causalité. Les pages les plus fortes ont tendance à se positionner sur davantage de requêtes et à être plus citées. Mais la tendance est constante : couvrir le sujet autour d’une requête compte plus que se positionner sur la requête elle-même.
Pourquoi le query fan-out compte pour le SEO et la visibilité IA
Le query fan-out change le sens du mot « positionnement » dans la recherche IA. Un seul mot-clé ne décide plus de votre visibilité dans la recherche IA, car le moteur d’IA cherche sur de nombreuses requêtes associées à la fois et cite les contenus qui répondent le mieux à chaque partie.
Cela a trois conséquences pratiques :
- Vous pouvez être cité sans vous positionner sur le mot-clé principal. Se positionner sur une requête dérivée moins difficile peut suffire, ce qui ouvre les réponses de l’IA aux petits sites.
- La couverture thématique l’emporte sur les pages à mot-clé unique. La page ou le site qui couvre les sous-thèmes vers lesquels l’IA se ramifie est récupéré plus souvent.
- Le volume de recherche ne dit pas tout. De nombreuses requêtes dérivées n’ont que peu ou pas de volume de recherche, et pourtant elles déterminent les marques qui apparaissent dans les réponses de l’IA.
Comment trouver les requêtes dérivées
Les requêtes dérivées n’apparaissent pas dans Google Search Console, et le suivi de positions traditionnel ne les montre pas non plus. Il existe cependant plusieurs moyens de trouver les requêtes dérivées de vos sujets :
- Keyword Surfer (gratuit) : l’extension Chrome montre les requêtes que ChatGPT a recherchées derrière une réponse, quand le modèle les expose.
- Le Suivi de visibilité IA de Surfer : son rapport sur les requêtes dérivées montre les requêtes et expressions que les moteurs d’IA recherchent derrière chaque prompt suivi, sur ChatGPT, AI Mode, AI Overviews et Perplexity.
- API Gemini avec grounding : si vous avez un profil technique, l’API renvoie les requêtes de recherche utilisées par Gemini. Google utilise Gemini pour AI Mode et AI Overviews : c’est donc un indicateur utile, même si les systèmes en production ajoutent leurs propres instructions.
- Autres outils de visibilité IA : des plateformes comme Ahrefs Brand Radar et l’AI Visibility Toolkit de Semrush indiquent aussi les prompts, les sources ou les requêtes dérivées derrière les réponses de l’IA.
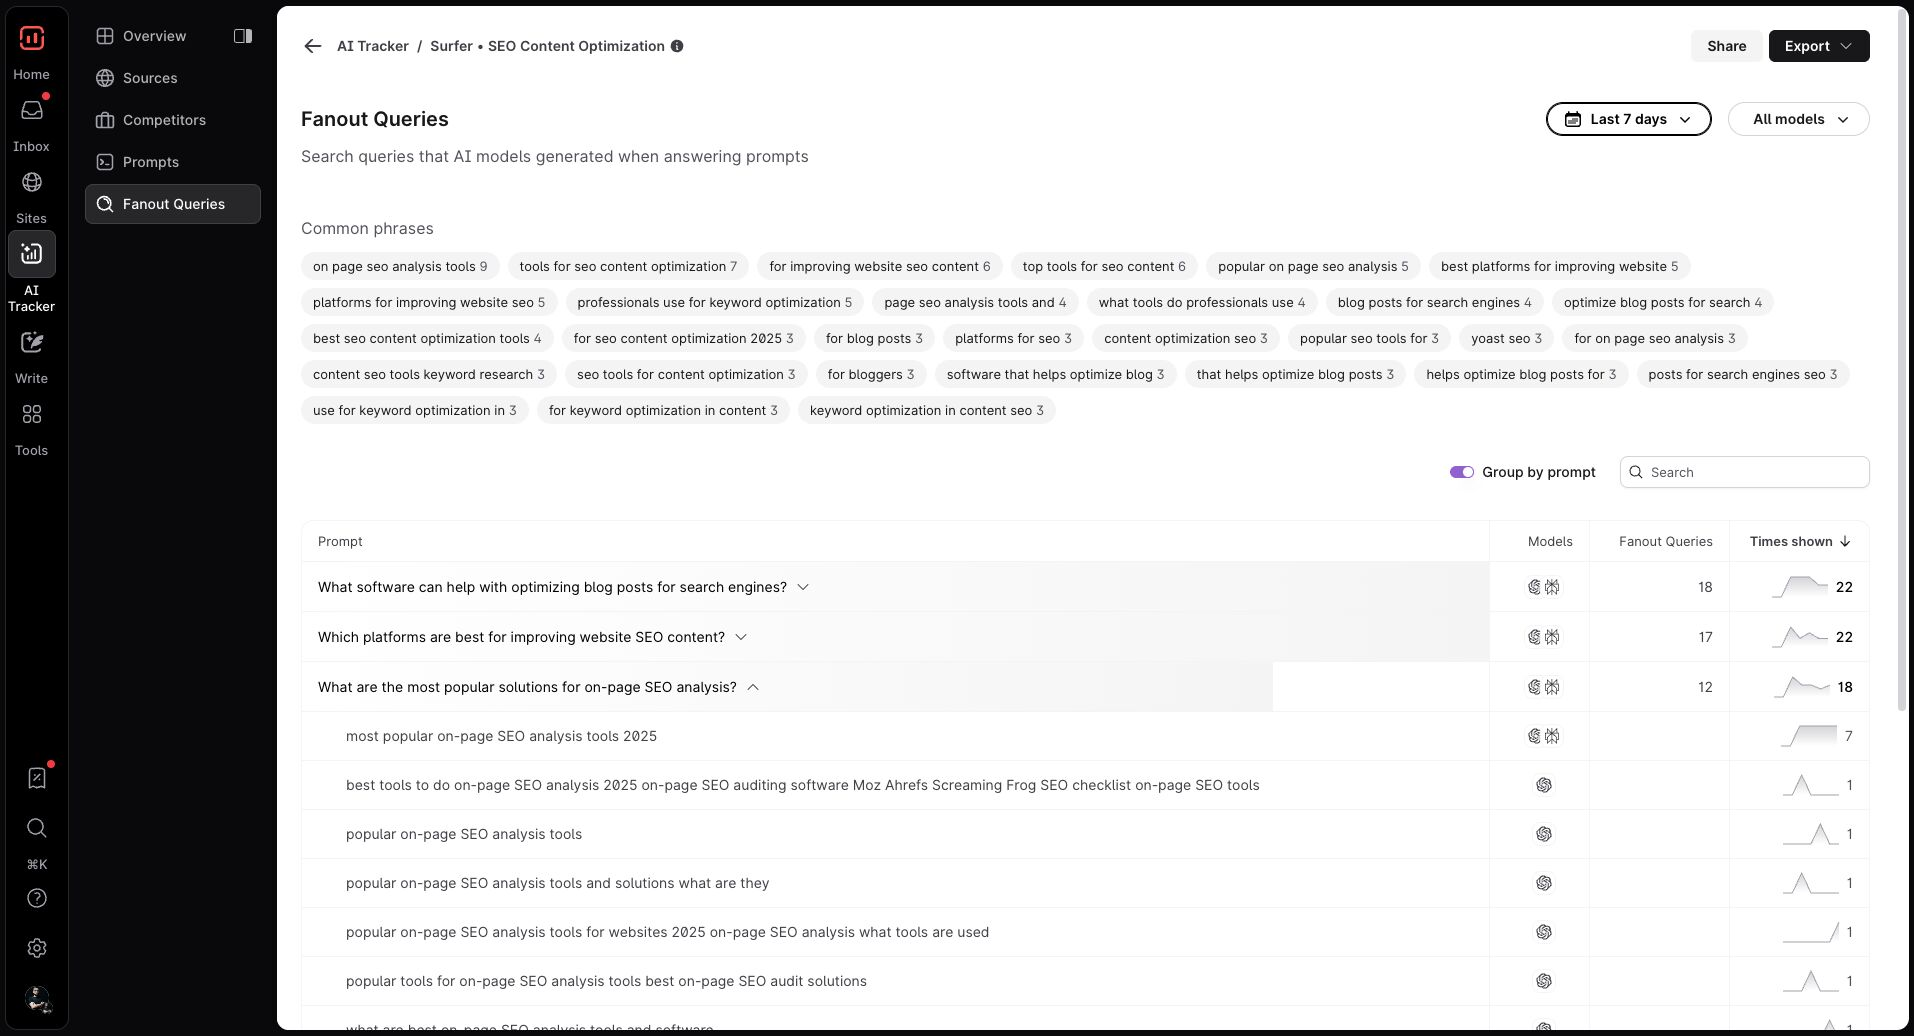
Quel que soit l’outil de query fan-out utilisé, lancez plusieurs fois les prompts importants. Avec seulement 27 % environ de requêtes dérivées stables, une exécution unique vous induira en erreur. Regroupez les résultats en clusters et concentrez-vous sur les thèmes qui reviennent.
Comment optimiser pour le query fan-out : 6 étapes
Votre premier réflexe pourrait être d’extraire toutes les requêtes dérivées et de rédiger une page pour chacune. Ne le faites pas. Les requêtes dérivées changent d’une exécution à l’autre, diffèrent selon les moteurs d’IA et dépendent de l’utilisateur. Et Google est explicite : créer des contenus distincts pour chaque requête dérivée, principalement pour manipuler les classements ou les réponses de l’IA, enfreint sa règle anti-spam contre l’abus de contenu à grande échelle. Voici ce qui fonctionne à la place.
1. Construisez des clusters thématiques, pas des pages par requête dérivée
Si votre site couvre un sujet en profondeur, vous répondez déjà à la plupart des questions vers lesquelles les systèmes d’IA se ramifient, quelles que soient les sous-requêtes déclenchées pour un utilisateur donné. C’est l’autorité thématique, et elle aide aussi dans la recherche traditionnelle, car vous vous positionnez sur davantage de requêtes. Dans l’enquête de Surfer, 90 % des SEO jugeaient l’autorité thématique importante.
Commencez par une carte thématique. La Carte thématique de Surfer part d’un site ou d’un sujet, trouve les mots-clés sémantiquement liés, les regroupe en clusters et montre où se trouvent vos lacunes de contenu. Utilisez une page pilier pour la requête large et des pages de cluster pour les sous-thèmes les plus importants, reliées entre elles. Pour aller plus loin, découvrez les clusters thématiques et l’autorité thématique.
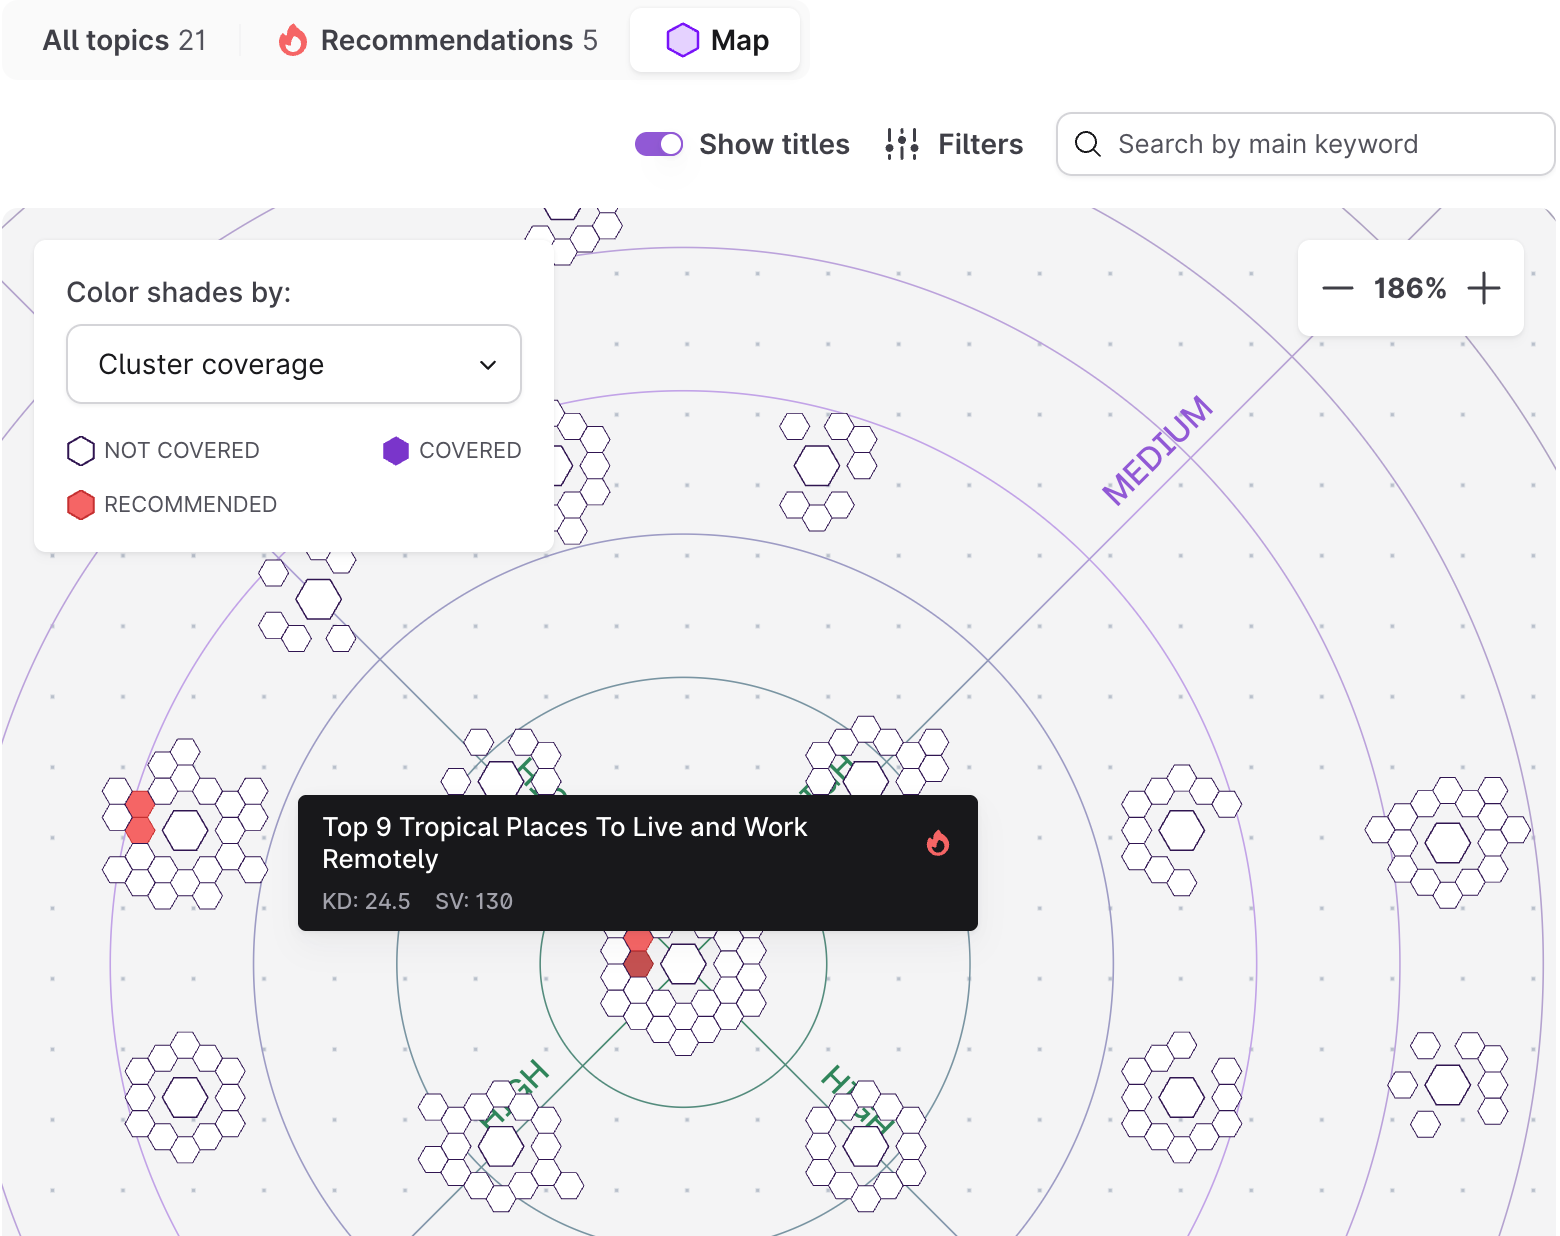
2. Commencez par les sous-thèmes peu difficiles
Puisque les pages positionnées uniquement sur des requêtes dérivées ont été citées 49 % plus souvent que celles positionnées uniquement sur la requête principale, vous n’êtes pas obligé de gagner d’abord le mot-clé le plus difficile. Les sous-thèmes du type requête dérivée sont souvent plus faciles à travailler. Filtrez votre carte thématique sur les sujets peu difficiles, publiez-les d’abord, puis attaquez progressivement les plus difficiles.
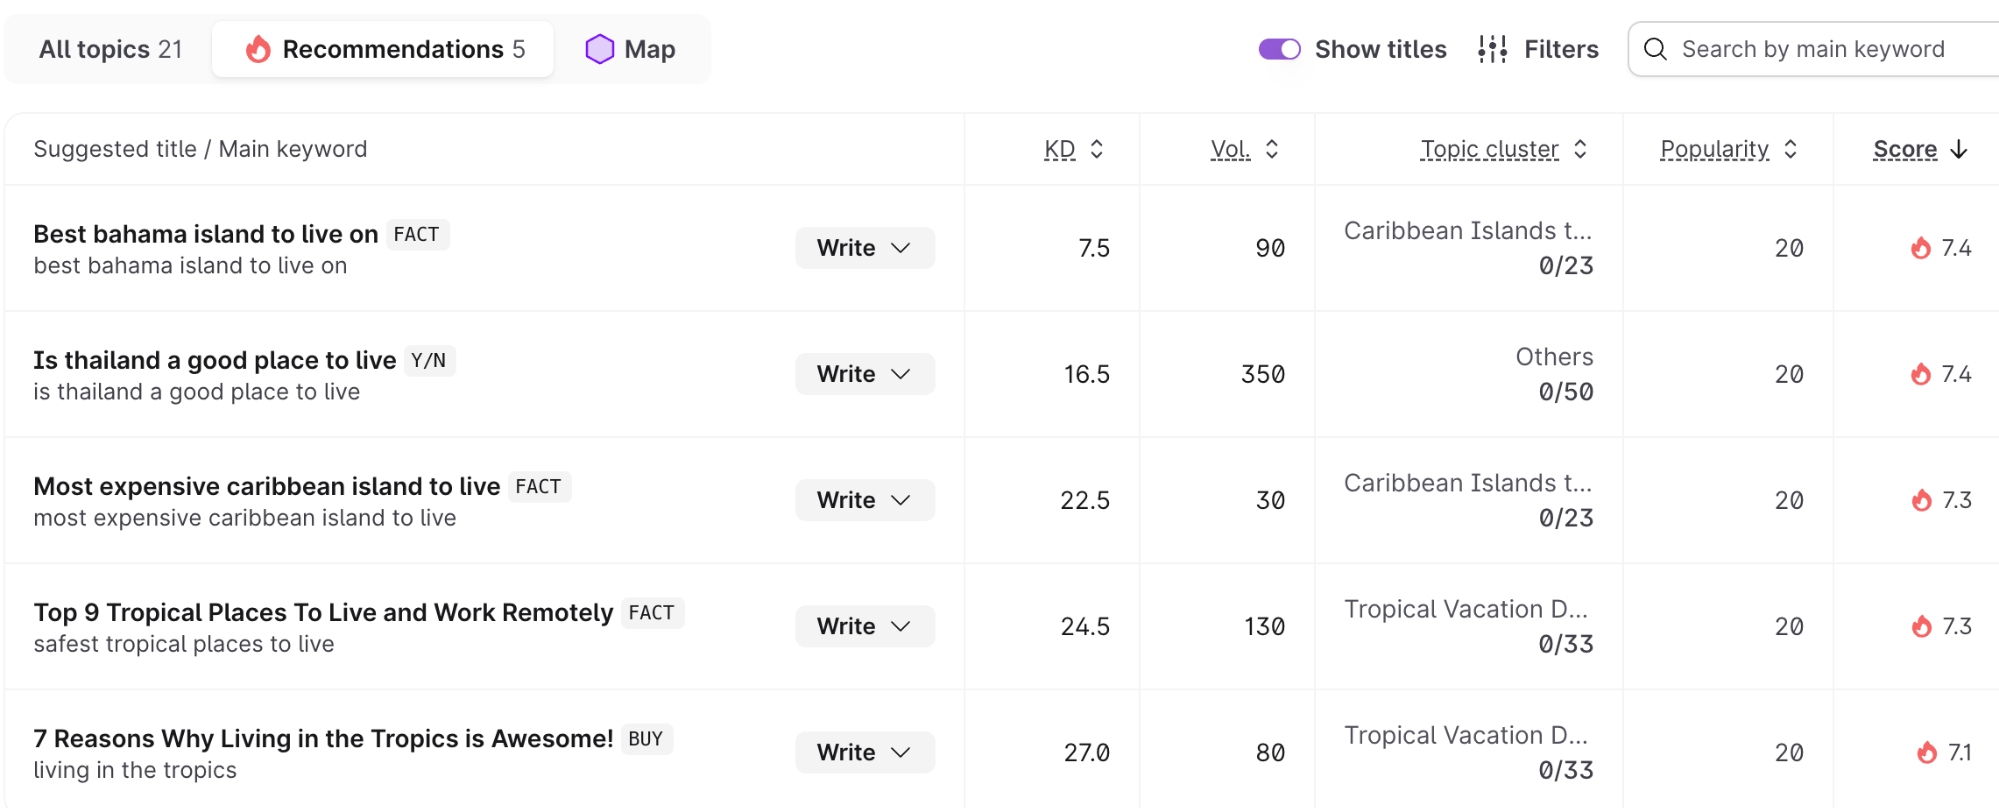
3. Couvrez les sous-thèmes centraux sur chaque page
Aucune page ne peut tout couvrir, mais votre page principale doit traiter les sous-thèmes sur lesquels les pages les mieux positionnées s’accordent. Comparez les intertitres des pages qui se positionnent, ajoutez ceux qui manquent et répondez aux questions associées que les gens posent. Un éditeur de contenu rend cela rapide : il montre les intertitres des concurrents, les sujets et questions à couvrir, et les faits clés que les moteurs d’IA mentionnent pour votre mot-clé. Intégrez ces faits, car les pages citées dans les AI Overviews couvrent davantage les faits clés d’un sujet que les pages non citées.
4. Rédigez des sections autonomes, qui répondent d’emblée
Les systèmes d’IA récupèrent des passages, pas des pages. Chaque requête dérivée peut extraire une section différente de votre article : chaque section doit donc avoir du sens seule. Ouvrez chaque section par une réponse claire, puis ajoutez des données, des exemples ou des tableaux comparatifs. Regroupez toutes les informations sur un sous-thème au même endroit au lieu de les disperser dans la page.
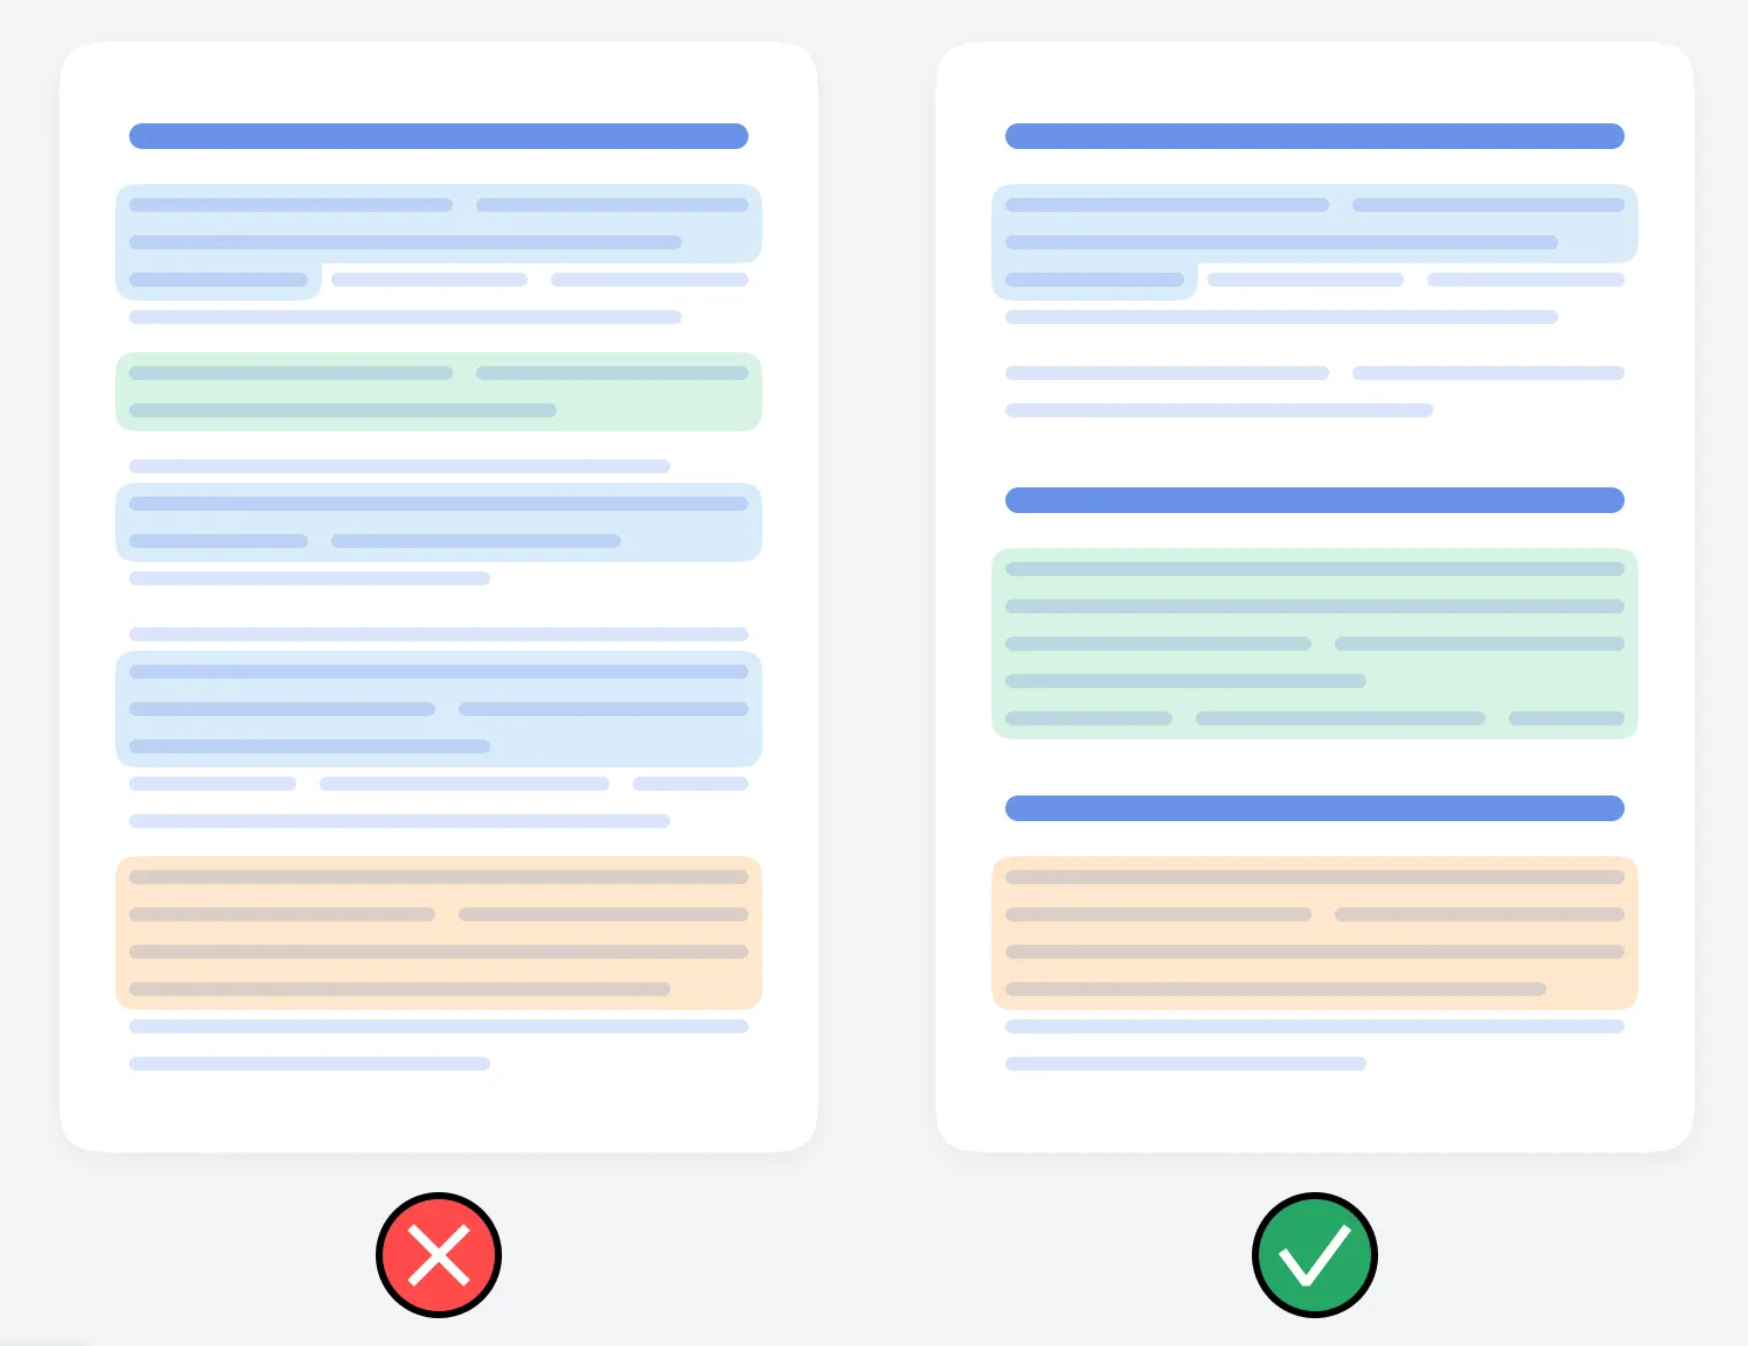
Il en va de même pour le haut de la page : 38 % des citations dans les AI Overviews proviennent des 100 premiers mots.
5. Faites-vous mentionner sur les pages que l’IA cite déjà
Les requêtes dérivées aboutissent souvent sur des pages tierces : avis, classements « best of », comparatifs, forums et sites d’actualité. Si votre marque est mentionnée sur les pages que l’IA récupère déjà, vous êtes couvert pour de nombreuses requêtes dérivées à la fois. Utilisez un outil de visibilité IA pour voir les sources que les moteurs d’IA citent pour vos prompts, puis cherchez des lacunes réelles : une liste à laquelle manque une catégorie d’outils dans laquelle vous entrez, ou un comparatif obsolète. Mettez en avant la façon dont vous amélioreriez leur page, pas un argumentaire commercial appuyé.
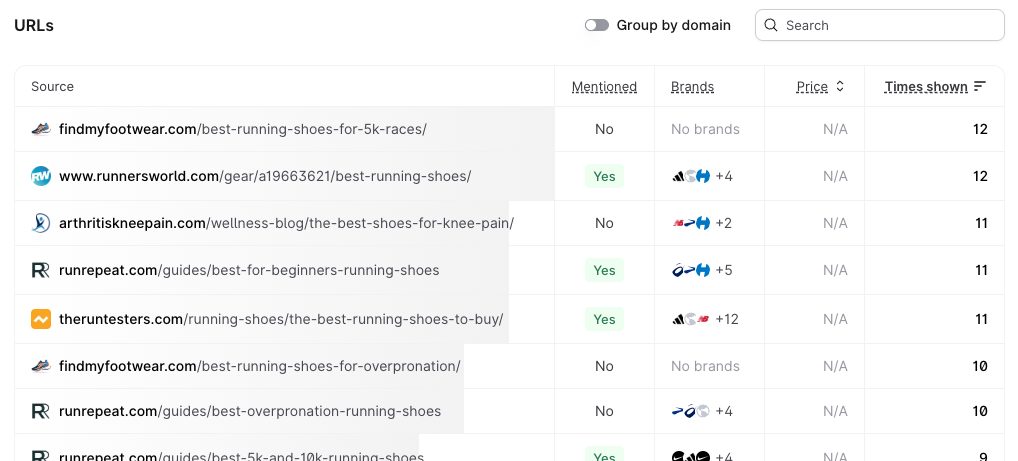
6. Évitez la cannibalisation et continuez à suivre
À mesure que vous développez vos clusters, veillez à ce que deux pages ne ciblent pas la même intention. Des pages en concurrence sur les mêmes requêtes brouillent les moteurs de recherche et divisent votre autorité. Vérifiez régulièrement la cannibalisation de mots-clés, suivez vos prompts dans un outil de visibilité IA et mettez vos pages à jour quand les thèmes des requêtes dérivées de votre sujet évoluent.
Questions fréquentes
Que signifie query fan-out ?
Le query fan-out signifie qu’un moteur de recherche IA découpe une requête d’utilisateur en plusieurs sous-requêtes associées, lance une recherche pour chacune et combine les résultats en une seule réponse. Google l’utilise dans AI Mode et AI Overviews, et ChatGPT, Perplexity, Gemini et Grok utilisent des processus similaires.
Le query fan-out est-il utilisé uniquement par Google AI Mode ?
Non. Google a donné son nom à la technique lors du lancement d’AI Mode, mais tout système d’IA qui cherche sur le web pour répondre à un prompt se ramifie d’une manière ou d’une autre. Selon des études récentes, ChatGPT lance en moyenne environ deux recherches par prompt, Grok près de sept et Gemini 3 plus de dix.
Combien de requêtes Google AI Mode génère-t-il ?
Google ne publie pas de chiffre. Gemini 3, la famille de modèles derrière AI Mode (Gemini 3.5 Flash est son modèle par défaut depuis mai 2026), a généré en moyenne 10,7 requêtes dérivées par prompt lors du test de Seer Interactive sur 501 prompts, avec une fourchette de 3 à 28. Deep Search peut en lancer des centaines.
Puis-je voir les requêtes dérivées qu’utilise ChatGPT ?
Oui. L’extension Chrome gratuite Keyword Surfer montre les requêtes que ChatGPT a recherchées derrière une réponse quand le modèle les expose, et le Suivi de visibilité IA de Surfer indique les requêtes dérivées des prompts suivis sur plusieurs moteurs d’IA.
Dois-je créer une page pour chaque requête dérivée ?
Non. Les requêtes dérivées sont instables (seules 27 % environ se répètent d’une exécution à l’autre), et Google indique que créer des contenus distincts pour chaque requête dérivée afin de manipuler les résultats enfreint sa règle contre l’abus de contenu à grande échelle. Construisez plutôt des clusters thématiques et couvrez les sous-thèmes au sein de pages solides.
Quelle différence entre query fan-out et expansion de requête ?
L’expansion de requête ajoute des termes associés à une seule recherche. Le query fan-out crée plusieurs recherches distinctes, les lance en parallèle et raisonne sur l’ensemble de leurs résultats pour rédiger une seule réponse.