Le débat autour des dernières tendances SEO de 2026 a évolué très vite.
Nouvelles fonctionnalités de recherche IA, nouvelles tactiques, et l’idée sans cesse répétée que le référencement naturel doit repartir de zéro.
Pourtant, quand on regarde comment fonctionnent réellement les moteurs de recherche, les fondamentaux ne se sont pas effondrés. Ce sont toujours les mêmes pages web qui alimentent les résultats de recherche. Elles sont simplement sélectionnées autrement.
Ce changement vient de la génération augmentée par récupération (RAG), le système qui se cache derrière les AI Overviews, les citations des LLM et la plupart des moteurs de recherche IA modernes.
Dans cet article, je passe en revue tout ce qui a réellement changé en SEO, ce qui est exagéré et ce que nous ne comprenons pas encore complètement, pour que vous gardiez une longueur d’avance.
Comment la recherche évolue en 2026
En 2026, les tendances SEO tournent toutes autour de la recherche IA. Mais il existe aujourd’hui un net décalage entre la façon dont on parle de la recherche IA et ce que montrent réellement les données.
L’IA est désormais intégrée partout dans les résultats de recherche, mais cela ne veut pas dire que l’écosystème lui-même ne s’est pas scindé en quelque chose de nouveau.
Une étude de Surfer portant sur plus de 400 000 recherches montre que si les AI Overviews apparaissent sur 47 % des requêtes, 52 % des sources qu’ils citent se classent aussi dans le top 10 des résultats organiques.
Cela nous indique que les résultats de la recherche IA reposent toujours sur les classements de la recherche traditionnelle, et n’en sont pas séparés. De bonnes performances en recherche organique continuent de se traduire par de la visibilité dans les systèmes d’IA.
Mais la manière d’obtenir cette visibilité commence à changer.
Le mécanisme qui permet de conserver cet avantage a profondément changé, et tout commence par la compréhension du fonctionnement réel de la récupération par l’IA.
1. Le RAG redéfinit discrètement ce que signifie « être bien classé »
La plupart des moteurs de recherche IA ne génèrent pas leurs réponses uniquement de mémoire. Ils suivent un processus en deux étapes :
- Récupérer les pages web pertinentes
- Générer une réponse à partir de ces sources
C’est ce qu’on appelle la génération augmentée par récupération (RAG), et c’est elle qui alimente la plupart des résultats modernes de recherche IA.
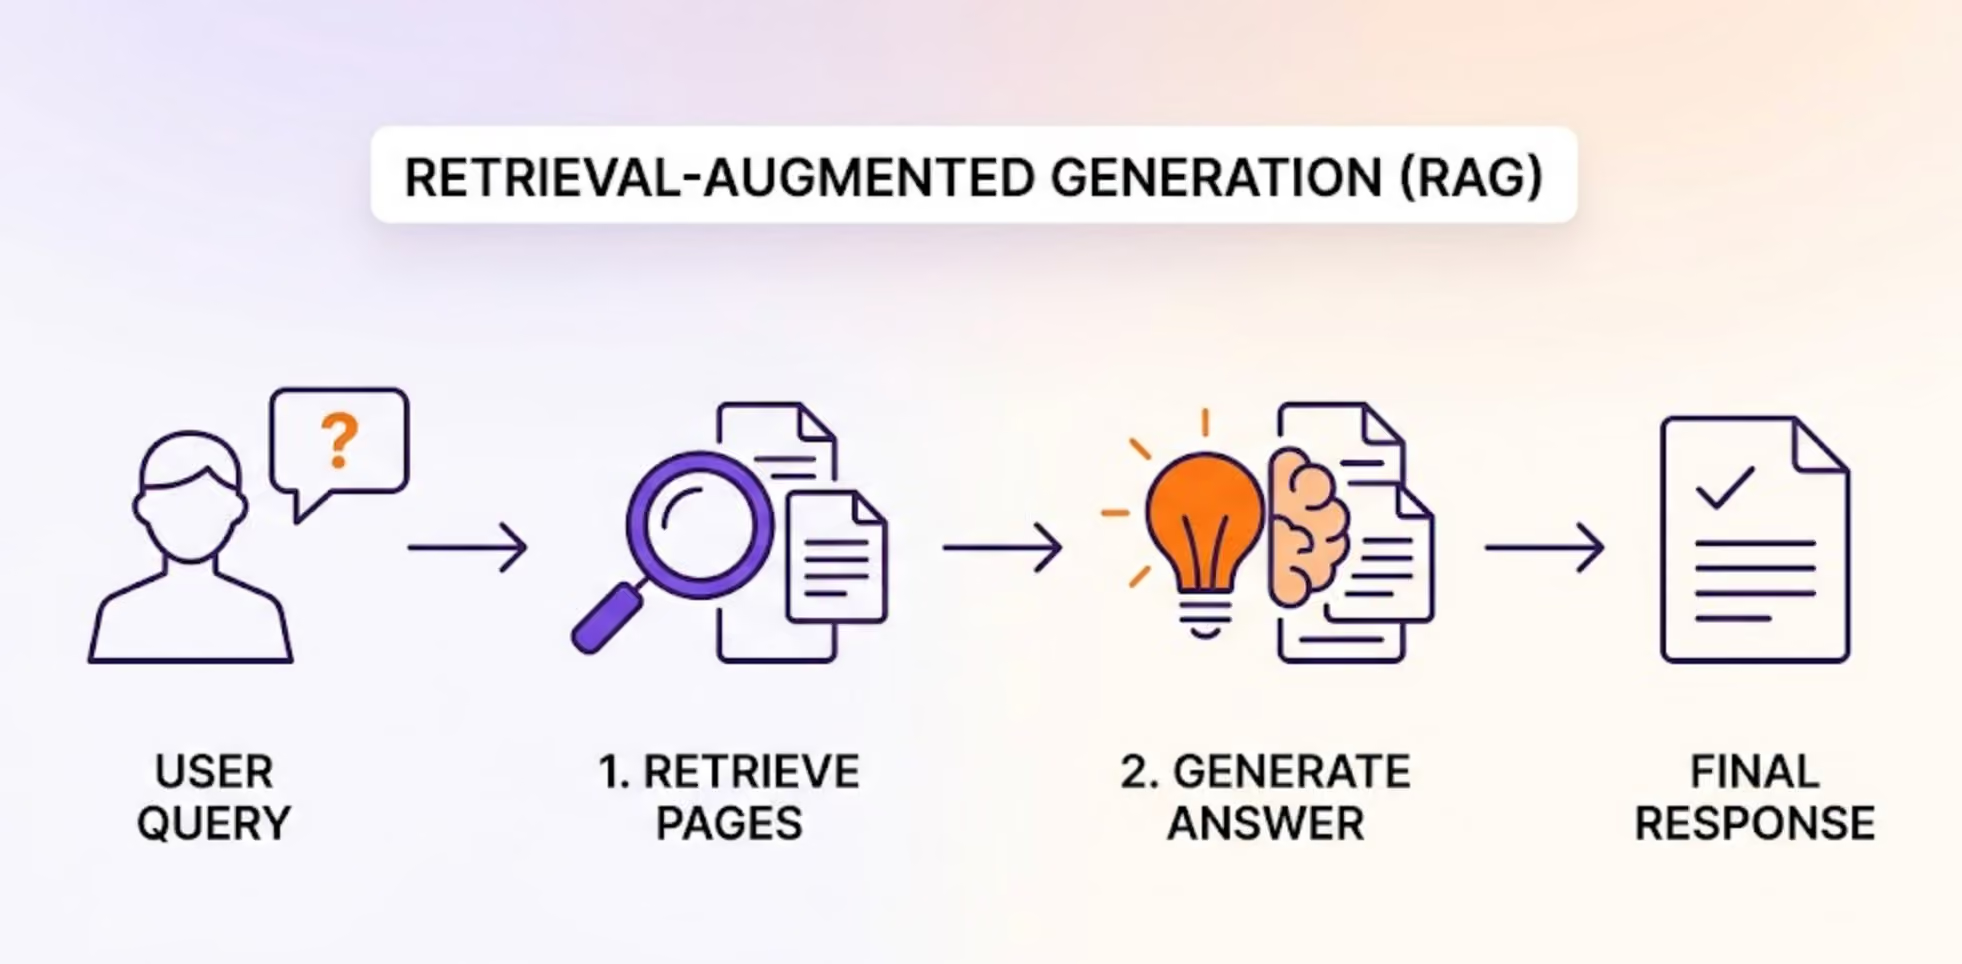
C’est la première étape (la récupération) qui change le fonctionnement de la visibilité. Si votre page n’est pas récupérée, elle ne sera pas utilisée dans les réponses générées par l’IA, quel que soit son classement dans les résultats de recherche traditionnels.
Cela déplace la base de la visibilité dans les moteurs de recherche. En SEO traditionnel, vous êtes en concurrence pour les positions. Mais en recherche IA, vous êtes d’abord en concurrence pour être récupéré par les grands modèles de langage.
Et la récupération ne repose pas sur les mots-clés de la même manière que le SEO traditionnel. Elle dépend davantage de :
- La pertinence sémantique (à quel point votre contenu correspond au sujet)
- La clarté des entités (à quel point les concepts sont clairement reliés)
- La couverture thématique (à quel point vous traitez le sujet de façon complète)
Et des données vont dans le même sens, comme le montre une étude de Surfer portant sur plus de 57 000 URL :
- Les pages citées avaient une couverture des faits de 31 %, contre 24 % pour les pages non citées
- Les pages contenant au moins 10 faits clés étaient citées plus de deux fois plus souvent que celles qui en contenaient moins de 5
Les sources les plus souvent réutilisées (les pages citées dans plusieurs réponses) présentent une couverture des faits près de 2 fois supérieure à celle des pages jamais citées.
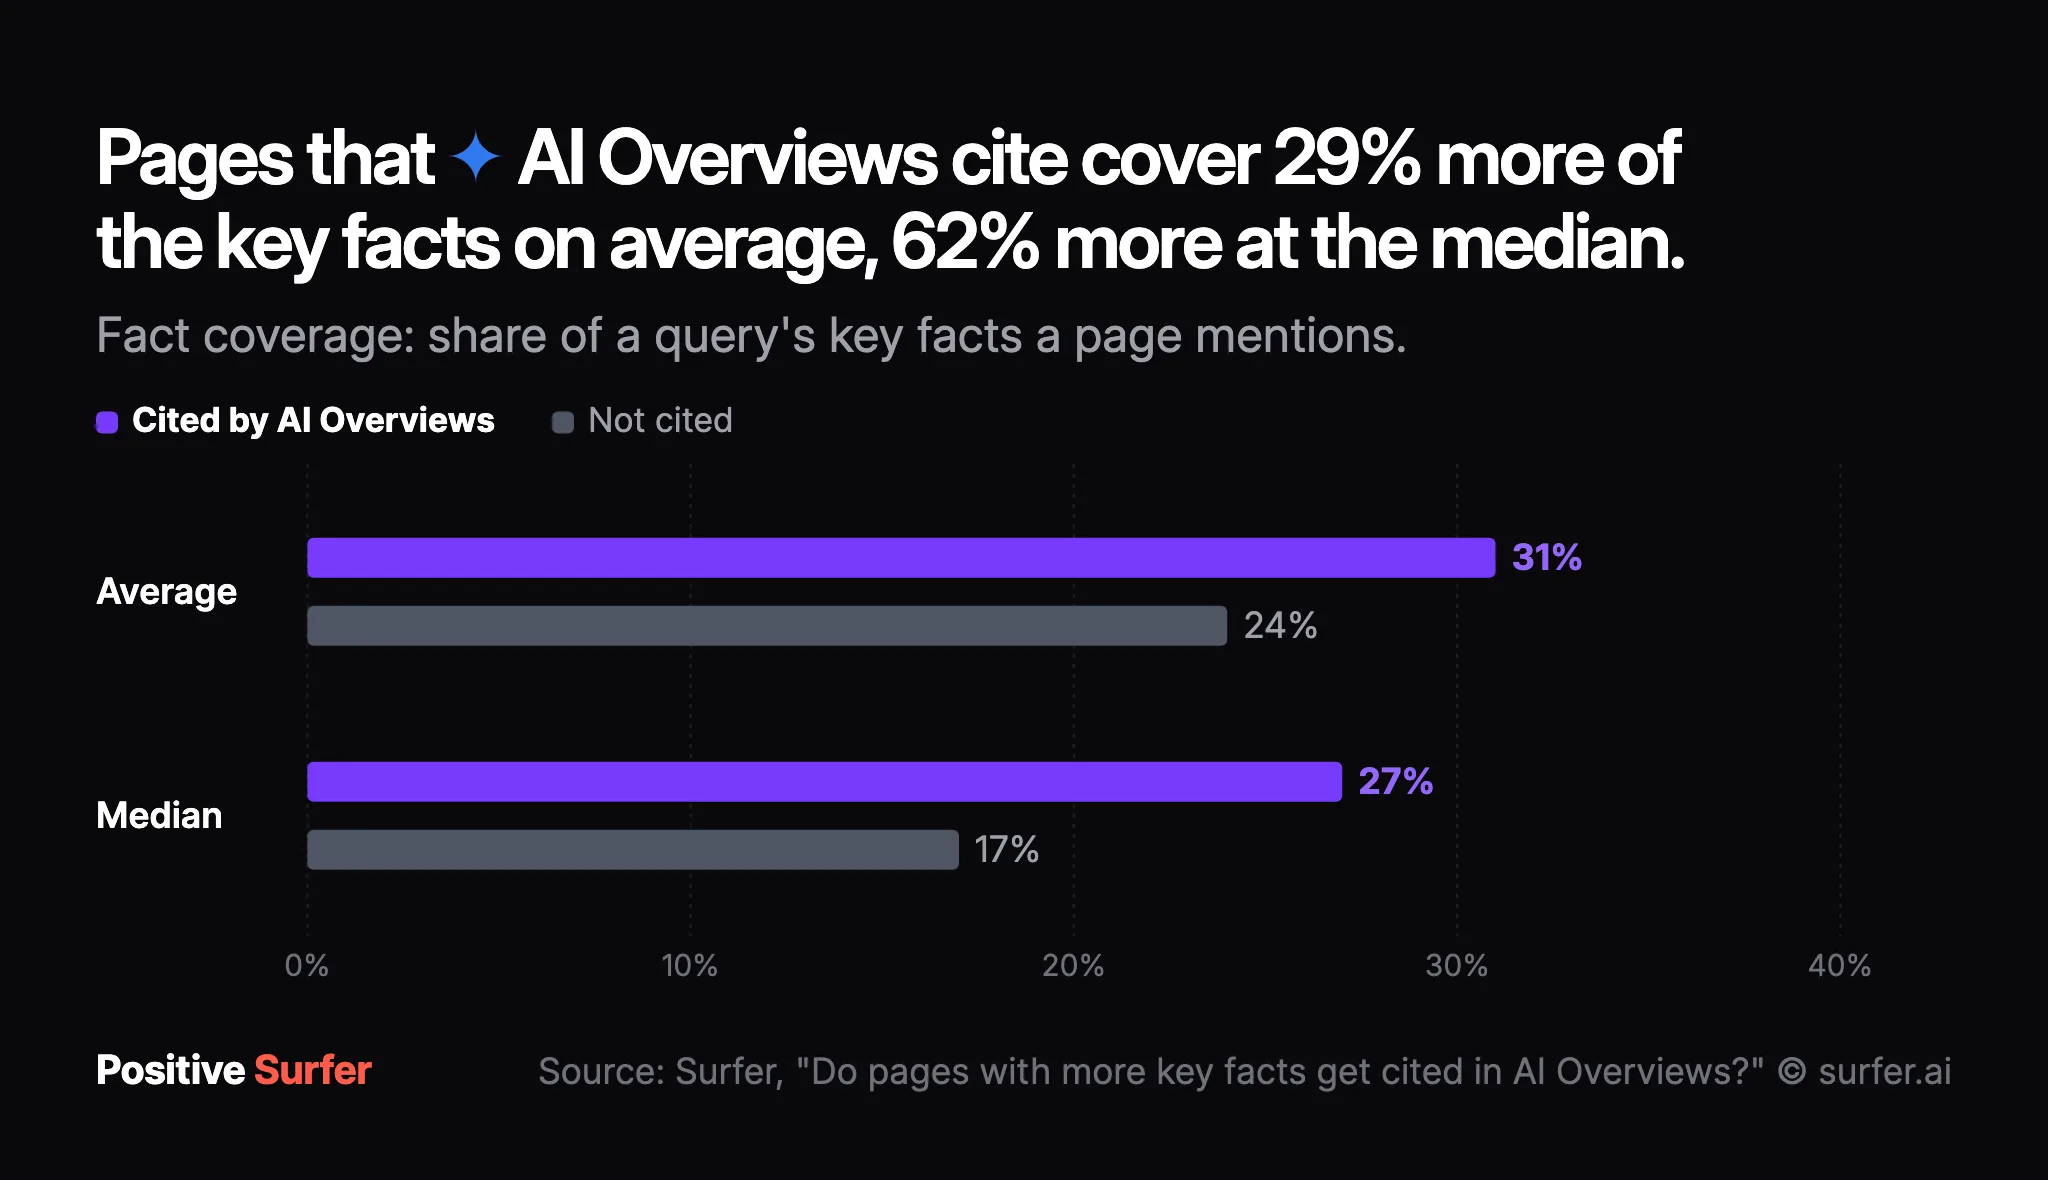
Le signal n’est donc pas la densité de mots-clés. C’est la présence, dans votre contenu, de suffisamment d’informations structurées et extractibles pour que les systèmes d’IA puissent les réutiliser.
Dans le même temps, nous avons constaté que la récupération n’est pas homogène d’une plateforme à l’autre.
Chaque système d’IA privilégie des signaux différents. Une page récupérée par ChatGPT peut ne pas apparaître dans Gemini ou dans d’autres moteurs de recherche IA pour la même requête.
Il n’existe pas encore de méthode unifiée, mais la direction est claire : la visibilité dépend désormais de la capacité de votre contenu à être récupéré, découpé et réutilisé, et pas seulement classé.
2. Les AI Overviews, c’est le RAG en action, et nous apprenons encore comment ils fonctionnent
Si le RAG est le système derrière la recherche IA moderne, c’est dans les AI Overviews que vous le verrez réellement à l’œuvre. Ils sont l’exemple le plus visible de la façon dont les systèmes d’IA récupèrent et assemblent des informations issues de plusieurs sources pour générer des réponses.
Et les AI Overviews sont déjà très répandus : ils apparaissent sur 47 % des recherches, chaque réponse comptant en moyenne environ 157 mots et citant environ 5 sources. La plupart d’entre eux (environ 78 %) utilisent des listes, ce qui les rend plus faciles à parcourir et à extraire, aussi bien pour les utilisateurs que pour l’IA.
Ils apparaissent aussi de façon inégale selon l’intention de recherche :
- Les requêtes informationnelles ont un taux de déclenchement de plus de 70 %
- Les requêtes commerciales ont un taux de déclenchement inférieur à 20 %
Jusqu’ici, tout cela semble prévisible. Mais ce qui rend les AI Overviews déroutants, c’est la façon dont les sources sont sélectionnées.
L’analyse de Surfer révèle que 67 % des pages citées dans les AI Overviews ne se classent pas dans le top 10 pour la requête principale, et que les featured snippets ne les recoupent que dans moins de 25 % des cas.
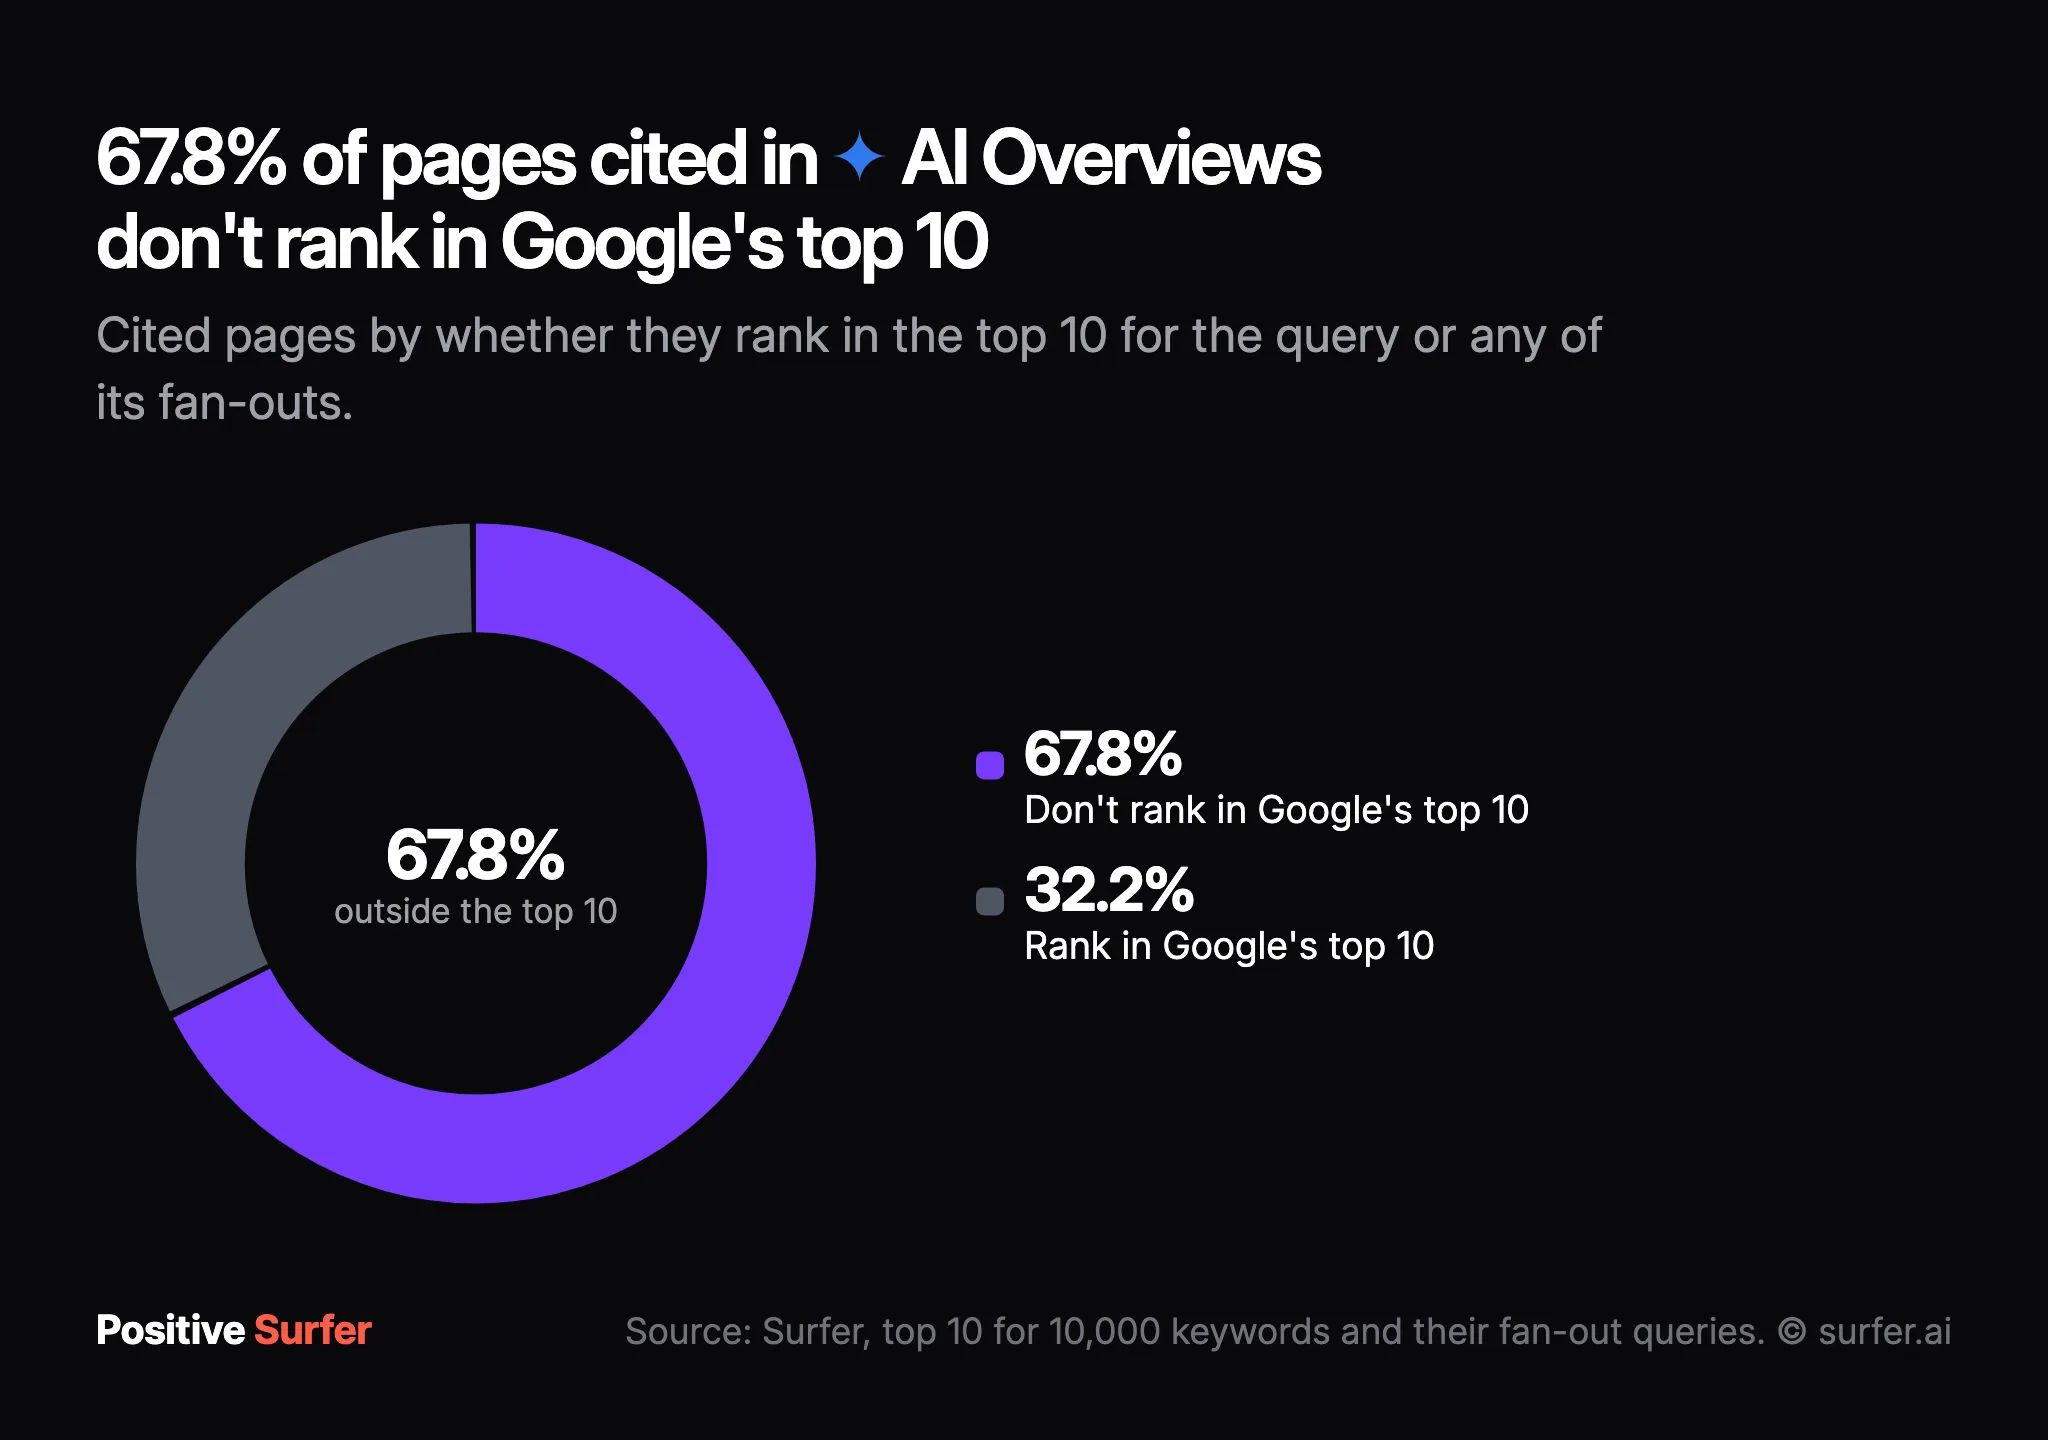
Cela remet en cause un principe fondamental du SEO traditionnel, selon lequel un bon classement était la clé pour être mis en avant. Bien positionner votre page sur Google aide toujours, mais ce n’est plus un moyen fiable d’être cité dans les réponses de la recherche IA.
C’est encore plus contre-intuitif quand on regarde les signaux de pertinence. Une de nos analyses Surfer portant sur 30 000 pages et 1 000 requêtes a montré que :
- La pertinence par rapport à la requête en début de page arrivait 14e sur 15 facteurs de citation
- Les pages correspondant fortement à la requête dès le début étaient citées moins de 30 % du temps
- Le placement des mots-clés en début de page n’avait quasiment aucune corrélation avec la probabilité d’être cité
À l’inverse, les pages citées avaient 2 fois plus de chances de répondre à l’intention plus loin dans le contenu, et non au début. Cela va à l’encontre de la façon dont la plupart des contenus sont structurés aujourd’hui.
Cela montre aussi que nous n’avons toujours pas d’explication claire sur les raisons pour lesquelles certaines pages sont citées.
Ce que nous avons, ce sont des signaux indicatifs, pas des règles.
Les AI Overviews reposent sur le RAG, mais la logique de récupération qui les sous-tend évolue encore. Autrement dit, beaucoup de stratégies SEO actuelles se fondent sur des tendances que nous observons, et non sur des systèmes que nous comprenons pleinement.
3. Ce que les logs serveur révèlent sur le rôle réel de llms.txt
llms.txt a été présenté comme une solution simple pour gagner en visibilité dans la recherche IA.
L’idée était d’ajouter à la racine de votre site un fichier texte brut (/llms.txt) servant de sitemap sélectif pour les robots d’IA, qui les oriente vers vos pages web les plus importantes pour qu’elles soient plus faciles à récupérer et à citer.
Mais d’après plusieurs études de logs serveur, les principaux robots d’IA ne demandent tout simplement pas les fichiers llms.txt. En théorie, l’idée tenait la route, mais les données ne la confirment pas.
Une analyse au niveau du CDN portant sur environ 2 millions de requêtes d’agents IA, menée par Soniclinker, n’a relevé aucune requête vers /llms.txt de la part de GPTBot, ClaudeBot, PerplexityBot ou de systèmes similaires
On retrouve la même tendance quand on regarde les résultats. Une étude de Search Engine Land a suivi 10 sites web pendant 90 jours après la mise en place de llms.txt :
- 8 sites n’ont constaté aucun changement mesurable
- 1 site a enregistré une baisse de 19,7 %
- 2 sites ont progressé, mais grâce à de nouveaux contenus, à des relations presse et à des corrections techniques, pas au fichier lui-même
Même Google a été clair sur ce point.
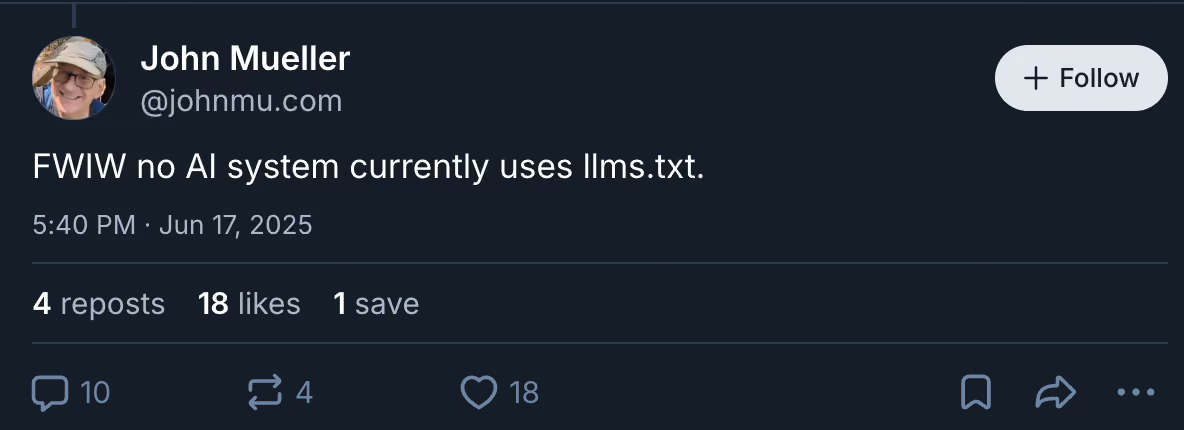
John Mueller a confirmé que Google n’utilise pas llms.txt pour l’exploration ni pour le classement. Et aucune grande entreprise d’IA (Google, OpenAI, Anthropic, Meta ou Mistral) ne l’a officiellement adopté ni imposé.
[Source]
Mais il semble aussi y avoir une certaine visibilité au niveau de l’indexation.
L’analyste SEO Crystal Carter a également souligné sur LinkedIn que, si des milliers de fichiers llms.txt sont indexés, rien ne prouve qu’ils soient réellement utilisés dans les résultats de la recherche IA.
Et c’est là que llms.txt devient moins une question de tactique qu’un symptôme.
Le secteur du SEO a une longue tradition d’optimisations adoptées « au cas où » : des idées qui semblent aller dans le bon sens, sont reprises rapidement et deviennent des bonnes pratiques avant qu’aucune preuve réelle ne vienne les étayer.
llms.txt correspond presque parfaitement à ce schéma.
4. Le Markdown n’est pas toujours nécessaire pour les moteurs de recherche
Le Markdown est plus efficace à traiter que le HTML pour les systèmes d’IA. Il supprime l’essentiel de la mise en forme et du style, si bien que moins de tokens sont consacrés au code et davantage au contenu lui-même. Les modèles ont ainsi plus de marge pour récupérer et utiliser l’information.
Le benchmark de Cloudflare montre l’ampleur de cette différence :
- Les articles de blog passent de 16 180 tokens en HTML à 3 150 tokens en Markdown (environ 80 % de réduction)
- Les pages e-commerce comptent jusqu’à 95 % de tokens en moins
- Même un intertitre utilise environ 3 tokens en Markdown, contre 12 à 15 en HTML
L’idée de départ est donc valable. Moins de mise en forme = plus de contenu exploitable pour la récupération par l’IA.
Cloudflare l’a déjà intégré à son infrastructure.
Sa fonctionnalité « Markdown for Agents » (lancée en 2026) permet aux robots d’IA de demander du Markdown via des en-têtes HTTP standard (Accept : text/markdown).
La page est alors convertie de HTML en Markdown en périphérie du réseau (edge) avant d’être servie.
Il ne s’agit pas d’une tactique SEO, mais plutôt d’un changement d’infrastructure dans la façon dont le contenu peut être fourni aux systèmes d’IA.
La confusion vient de la façon dont on l’applique.
Il y a un grand pas entre « le Markdown est plus efficace » et « vous devriez convertir votre site en Markdown pour mieux vous classer dans la recherche IA ».
Aucune preuve ne permet de franchir ce pas.
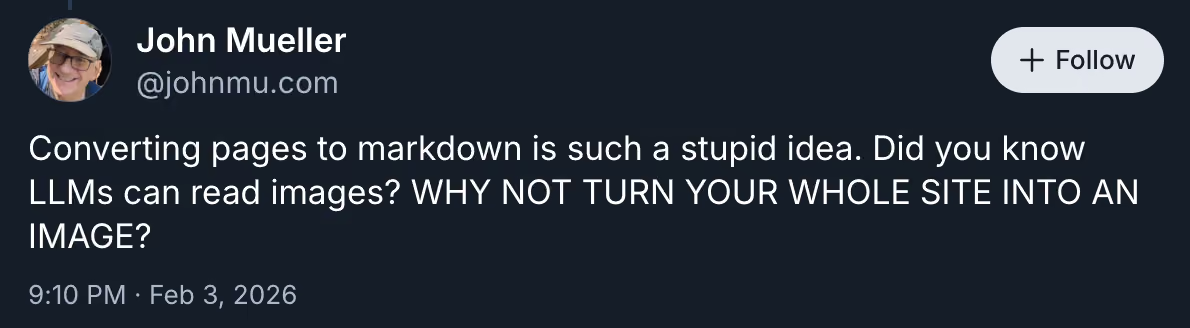
John Mueller a abordé directement le sujet sur Bluesky, qualifiant l’idée d’approche « stupide » et soulignant qu’aplatir les pages supprime un contexte utile (navigation, mise en page, HTML sémantique) qui aide aussi bien les utilisateurs que les moteurs de recherche à comprendre le contenu.
Et surtout, aucune donnée publique ne montre que servir du Markdown améliore les résultats de la recherche IA, augmente les citations ou influe sur les classements.
La situation est donc assez simple :
- L’argument technique est solide (le Markdown est plus efficace)
- L’impact SEO n’est pas démontré
Pour l’instant, c’est un choix d’infrastructure, pas une stratégie de contenu.
Cela pourrait, à terme, influencer la façon dont les moteurs de recherche IA traitent le contenu, mais en faire une tactique de classement, c’est aller plus vite que les preuves.
5. GEO, AEO et la course pour nommer de nouvelles catégories d’optimisation
Ces 12 à 18 derniers mois, une nouvelle série d’acronymes a fait son entrée dans le secteur du SEO :
- GEO (Generative engine optimization) : vise à faire citer et réutiliser votre contenu dans les réponses générées par l’IA
- AEO (Answer engine optimization) : vise à structurer le contenu pour qu’il puisse être extrait directement dans les réponses
- SRO (Semantic retrieval optimization) : vise à améliorer la façon dont le contenu est récupéré en fonction du sens, des entités et du contexte
Chacun de ces concepts tente de définir comment optimiser pour les moteurs de recherche IA, mais aucun n’a de définition partagée, de périmètre convenu ni de consensus sur la manière de mesurer les performances.
La plupart de ces termes sont façonnés par les outils et les éditeurs qui les promeuvent.
Dans le même temps, presque tous les outils vendent désormais une version d’un « score de visibilité IA ». Un nombre croissant d’outils de visibilité IA (ainsi que d’outils existants rebaptisés) promettent désormais :
- Suivi de visibilité IA
- Le suivi des prompts sur plusieurs plateformes (ChatGPT, Gemini, Perplexity, Claude)
- La fréquence des citations, la perception de la marque et le positionnement face aux concurrents
On retrouve là un schéma déjà bien connu.
Quand les outils d’optimisation de contenu ont décollé entre 2019 et 2021, le marché est passé par la même phase : de nouvelles catégories sont apparues rapidement, la différenciation était floue et les promesses allaient plus vite que les capacités réelles.
Mais une partie de cette taxonomie est réellement utile.
Un cadre très répandu décrit la visibilité IA comme une progression en 3 étapes :
- Le SEO permet la récupération
- L’AEO permet l’extraction
- Le GEO permet la confiance et la réutilisation répétée
Cette séquence reflète un vrai changement dans le fonctionnement des systèmes d’IA par rapport aux moteurs de recherche traditionnels.
Mais la terminologie qui l’entoure reste instable, car on ne sait toujours pas clairement comment ces données sont mesurées par les outils GEO et IA actuels. Quand chaque éditeur définit la « visibilité IA » à sa façon, les métriques deviennent impossibles à comparer, à étalonner ou à considérer comme fiables.
Ce que ces outils mesurent réellement, et ce qu’ils promettent
La plupart des outils GEO et AEO affirment :
- Suivre les mentions de marque sur des plateformes comme ChatGPT, Gemini et Perplexity
- Mesurer la fréquence des citations
- Surveiller la perception de la marque et le positionnement face aux concurrents
- Fournir des recommandations d’optimisation
La plupart s’appuient sur une méthode appelée échantillonnage de prompts.
Ils soumettent un ensemble fixe de requêtes aux moteurs de recherche IA et notent si votre marque apparaît dans la réponse. Le problème, c’est que les LLM ne produisent pas des résultats constants.
Car la plupart des réponses varient en fonction :
- Du contexte de l’utilisateur
- De l’historique de la session
- Des mises à jour du modèle
- Et même du moment et des conditions de charge
La même requête peut donc renvoyer des résultats différents à quelques heures d’intervalle, ce qui rend les « scores de visibilité IA » intrinsèquement bruités.
Une étude de Resoneo met en évidence une baisse du nombre de sources de ChatGPT, ce qui fait mécaniquement baisser les scores de couverture de chaque marque et fausse les comparaisons entre plateformes.
Concrètement, cela signifie que :
- Exécuter les mêmes prompts à des jours différents peut produire des scores différents
- Des outils différents peuvent donner des résultats complètement différents pour la même marque
Cela ne rend pas ces outils inutiles pour autant. Des outils comme le Suivi de visibilité IA de Surfer restent extrêmement utiles pour :
- Vérifier si votre marque apparaît tout simplement dans les résultats de la recherche IA
- Suivre les grandes tendances dans le temps
- Comprendre comment vos concurrents sont positionnés dans les réponses
Mais les résultats doivent être interprétés avec prudence. Abordez avec scepticisme les tendances affichées par ces outils de visibilité IA, car il n’existe pas encore d’équivalent de Google Analytics pour la recherche IA.
De nouvelles catégories se définissent, des outils se construisent autour d’elles et des métriques se transforment en produits, avant même que le système lui-même soit pleinement compris.
6. WebMCP et le web agentique ne relèvent plus de la théorie
Pendant longtemps, l’idée d’agents IA interagissant directement avec les sites web semblait théorique.
Avec WebMCP, elle commence à devenir réalité.
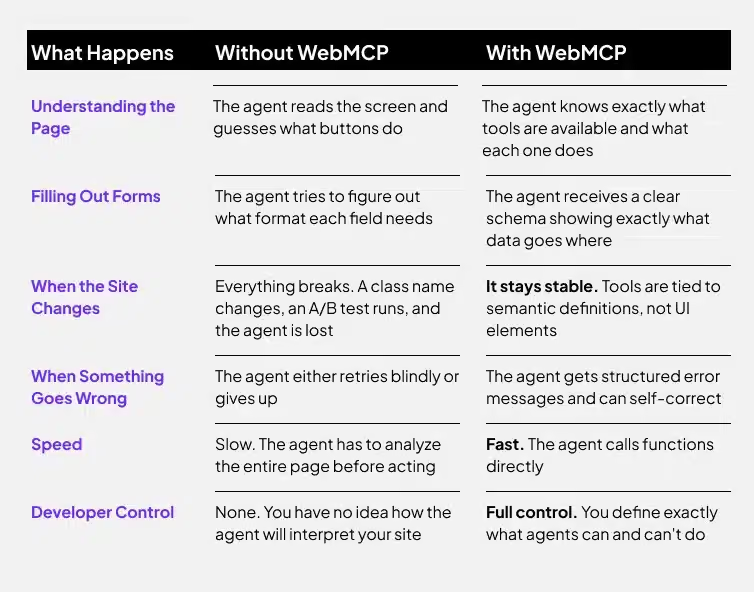
WebMCP (Web Model Context Protocol) permet aux sites web d’exposer leurs fonctionnalités sous forme d’outils lisibles par les systèmes d’IA. Au lieu de prendre des captures d’écran et de simuler des clics, les agents peuvent interagir avec une page via des actions définies, grâce à l’API navigator.modelContext.
Au lieu de simplement lire le contenu, les agents peuvent donc réellement utiliser votre site.
WebMCP est développé avec le soutien de Google et de Microsoft, et Chrome 146 en a livré une première préversion en février 2026 : les développeurs peuvent donc déjà le tester.
Son principal avantage est l’efficacité.
Les workflows d’agents actuels reposent sur des captures d’écran, dont le traitement peut nécessiter plus de 2 000 tokens. WebMCP les remplace par des appels structurés qui utilisent environ 20 à 100 tokens, soit une réduction d’environ 89 %.
Cette différence compte, car les interactions des agents sont limitées en tokens.
Et c’est là que le lien avec le SEO apparaît.
Si les agents peuvent réserver, comparer ou effectuer des actions directement sur les sites compatibles WebMCP, ce sont ces sites qui seront utilisés. Les autres ne seront pas seulement moins bien classés : ils seront ignorés.
Cela ajoute une nouvelle couche au SEO technique, qui ne concerne ni le contenu ni les liens, mais la capacité même de votre site à être consulté et utilisé par des agents IA.
7. Ce qu’un web piloté par les agents change pour le SEO technique
WebMCP annonce un changement plus large dans le fonctionnement de la recherche.
Le SEO technique traditionnel consiste à aider les robots d’exploration à découvrir et indexer des pages destinées aux humains. Un web piloté par les agents change ce modèle.
L’objectif est désormais d’aider les agents IA à accomplir des tâches pour le compte des utilisateurs : prendre des rendez-vous, acheter des produits, comparer des options ou remplir des formulaires.
La cible de l’optimisation passe d’une page qu’on peut découvrir à un service qu’on peut utiliser. Cela change ce à quoi ressemble « l’optimisation » en pratique.
Être lisible par les agents signifie que votre site peut exposer clairement :
- Quelles actions sont disponibles
- Quelles données ces actions requièrent
- Quels résultats elles produisent
Cela dépend moins du contenu que de la structure.
Par exemple :
- Des API propres et bien documentées
- Des données structurées et des schémas
- Des systèmes back-end organisés
- Une cartographie claire des actions (par exemple les parcours de réservation, de paiement ou de comparaison)
[Source]
Autrement dit, il ne s’agit pas seulement d’être indexé, mais de rendre votre site réellement utilisable.
Ce changement ne se limite pas à WebMCP. D’autres protocoles émergent déjà :
- Agentic Commerce Protocol (ACP) : pour les transactions comme le paiement et la comparaison de produits
- Les protocoles de contrôle des médias : pour les abonnements et l’accès aux contenus
- L’écosystème plus large du Model Context Protocol : pour définir la façon dont les agents interagissent avec différents types de services
Tous vont dans le même sens : chaque secteur aura un jour besoin d’une infrastructure qui fonctionne avec les agents IA, et pas seulement avec des utilisateurs humains.
Cela dit, tout cela n’en est qu’à ses débuts.
La spécification WebMCP est actuellement un Draft Community Group Report, et non une norme W3C finalisée, et une prise en charge plus large par les navigateurs n’est pas attendue avant le milieu ou la fin de 2026.
La plupart des sites n’ont pas encore besoin de le mettre en place, mais cela mérite qu’on y prête attention.
Une analyse de Semrush de mars 2026 compare l’impact potentiel de WebMCP à celui des Core Web Vitals : un sujet qui semblait d’abord facultatif, mais qui est vite devenu un facteur de différenciation concurrentielle une fois son adoption lancée.
Le même scénario pourrait se reproduire ici.
Dès que les agents commenceront à accomplir de vraies tâches sur le web, les sites qui prennent en charge ces interactions ne seront pas seulement bien classés : ils seront réellement utilisés. Au final, cela devrait aussi aider à relancer les visites et les clics sur les sites web.
8. Pour la recherche IA, les mentions tierces et l’autorité de marque pèsent plus que les tactiques on-page
L’optimisation on-page permet toujours à votre contenu d’entrer dans le système, mais ce n’est plus elle qui détermine si votre marque apparaît dans les résultats de l’IA.
Plusieurs études montrent désormais que les systèmes d’IA se fient davantage à ce que le web dit de vous qu’à ce que vous dites de vous-même.
Une analyse de Surfer portant sur 289 105 URL a relevé une corrélation d’environ 0,41 (coefficient de rang de Spearman) entre la fréquence à laquelle une marque est mentionnée dans les sources citées par l’IA et la force avec laquelle cette marque est recommandée.
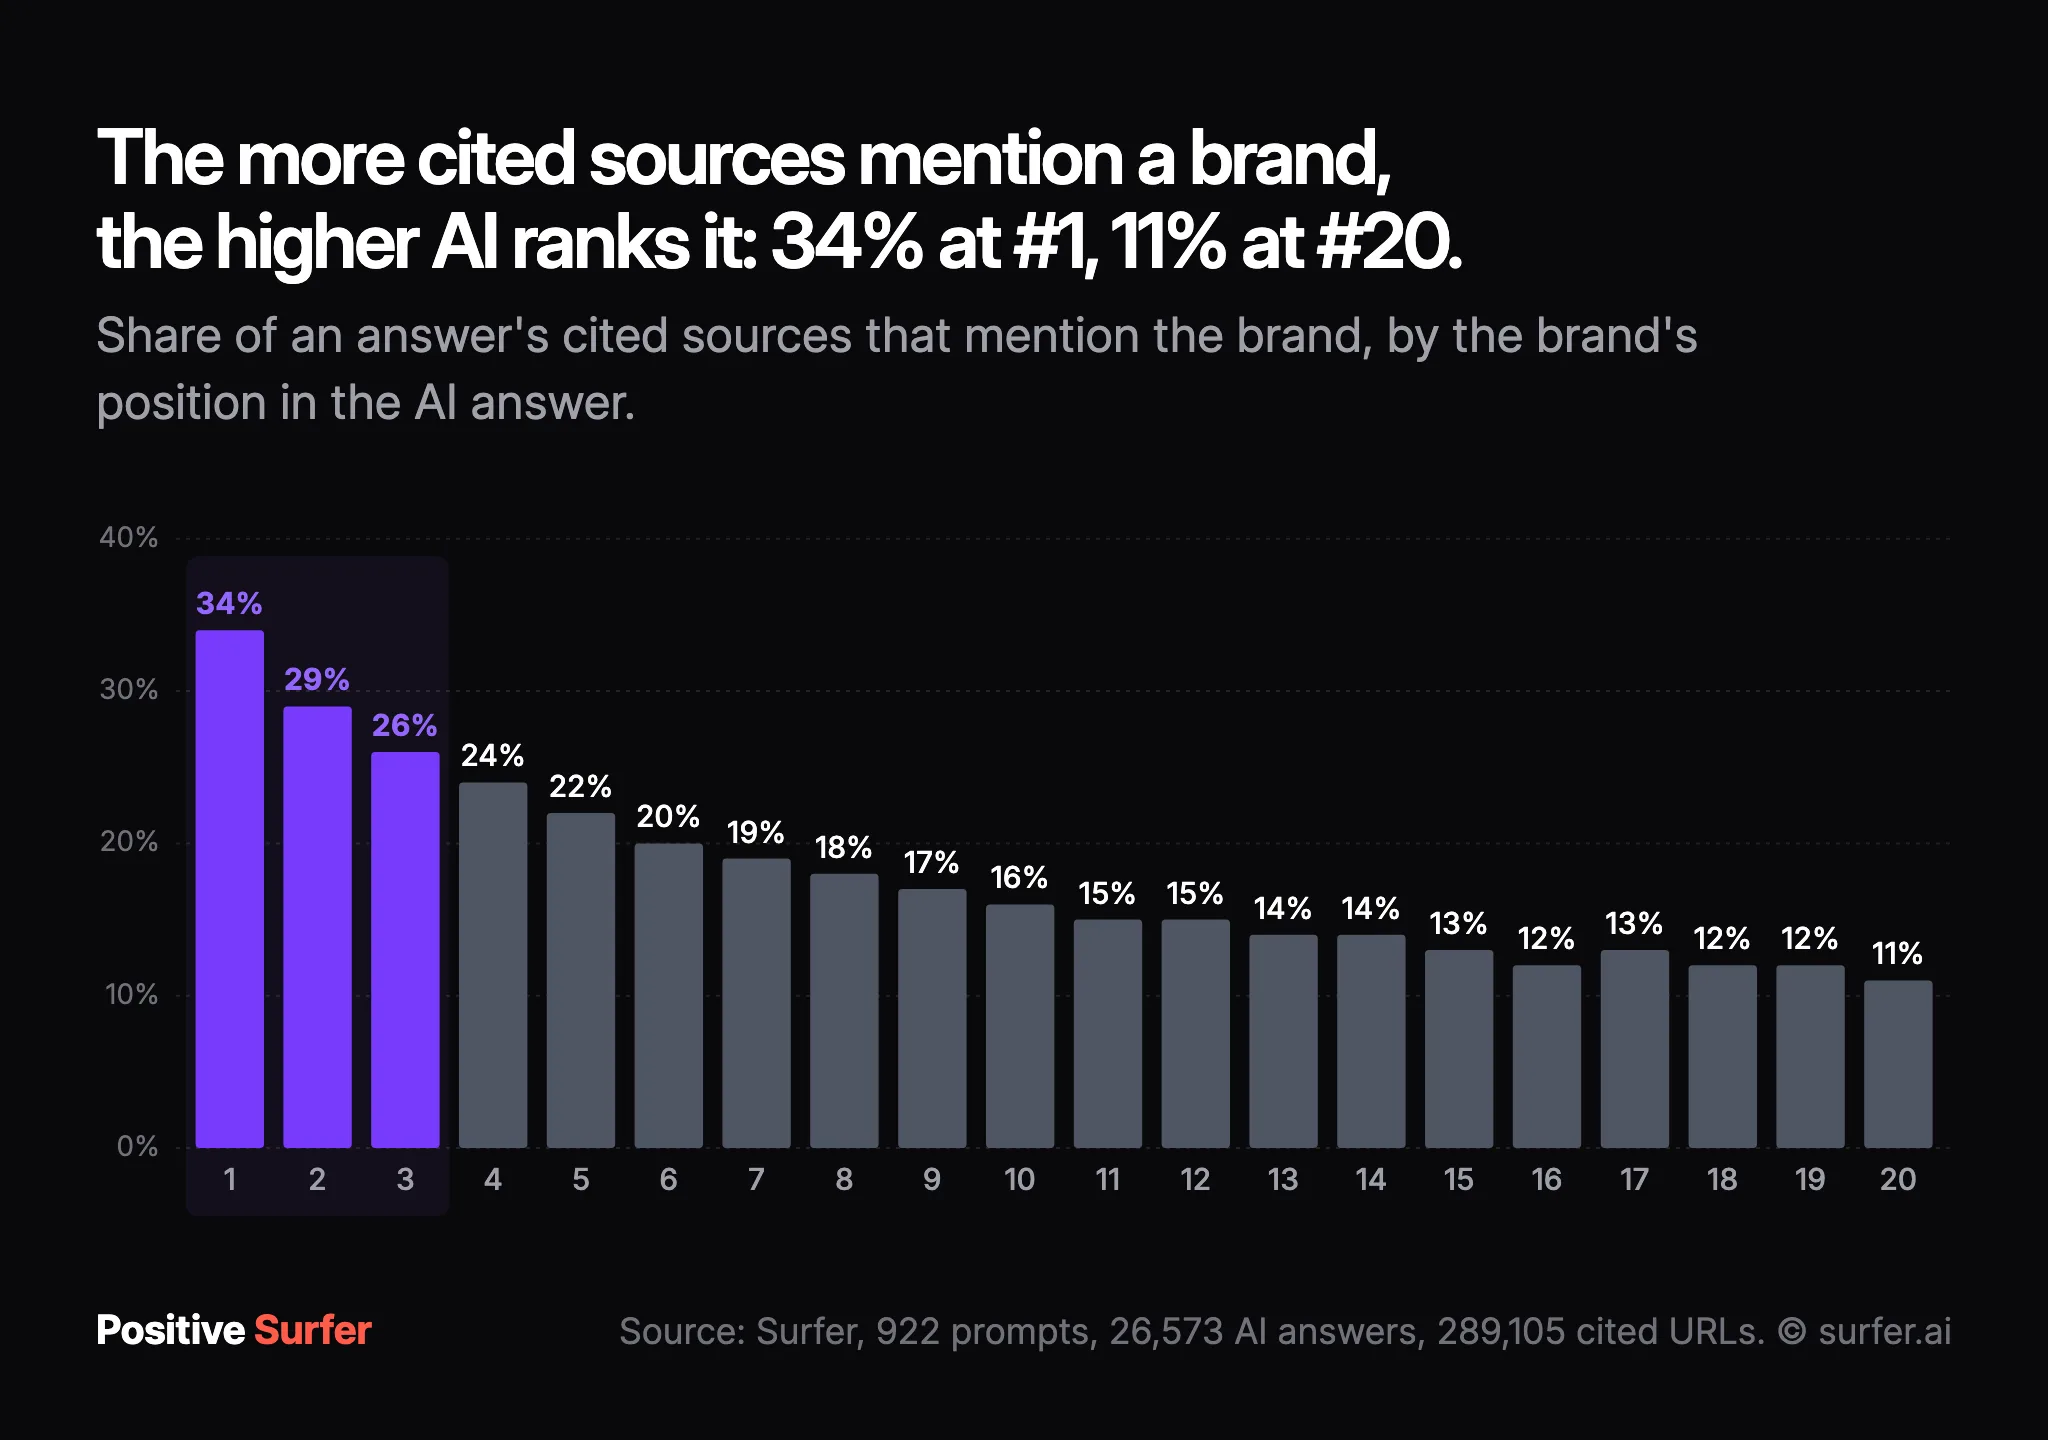
Cela laisse penser que les modèles d’IA ne se contentent pas de récupérer du contenu : ils le valident au regard de signaux plus larges issus du web. Quand une marque apparaît régulièrement dans des sources de confiance, il devient plus facile pour le système de la faire ressortir et de la recommander.
Cette tendance est encore plus marquée quand on regarde les données par plateforme.
Une étude d’Ahrefs portant sur 75 000 marques dans ChatGPT, AI Mode et les AI Overviews a montré que le facteur le plus corrélé à la visibilité IA n’était ni les backlinks ni le contenu on-page. C’était YouTube :
- Les mentions dans des vidéos YouTube présentent une corrélation d’environ 0,737 (le signal le plus fort)
- Les mentions de la marque sur le web présentent une corrélation d’environ 0,66 à 0,71
- La couverture médiatique, Reddit et les avis ressortent aussi comme des signaux forts de visibilité IA
À première vue, cela peut surprendre. La plupart des systèmes d’IA sont basés sur le texte, mais ils s’appuient tout de même sur des signaux issus de plateformes comme YouTube, via les transcriptions des vidéos, leurs descriptions et les données d’engagement associées aux entités de marque.
Et vous pouvez le constater par vous-même. De nombreux résultats AI Overview de Google citent en effet des vidéos YouTube comme source :
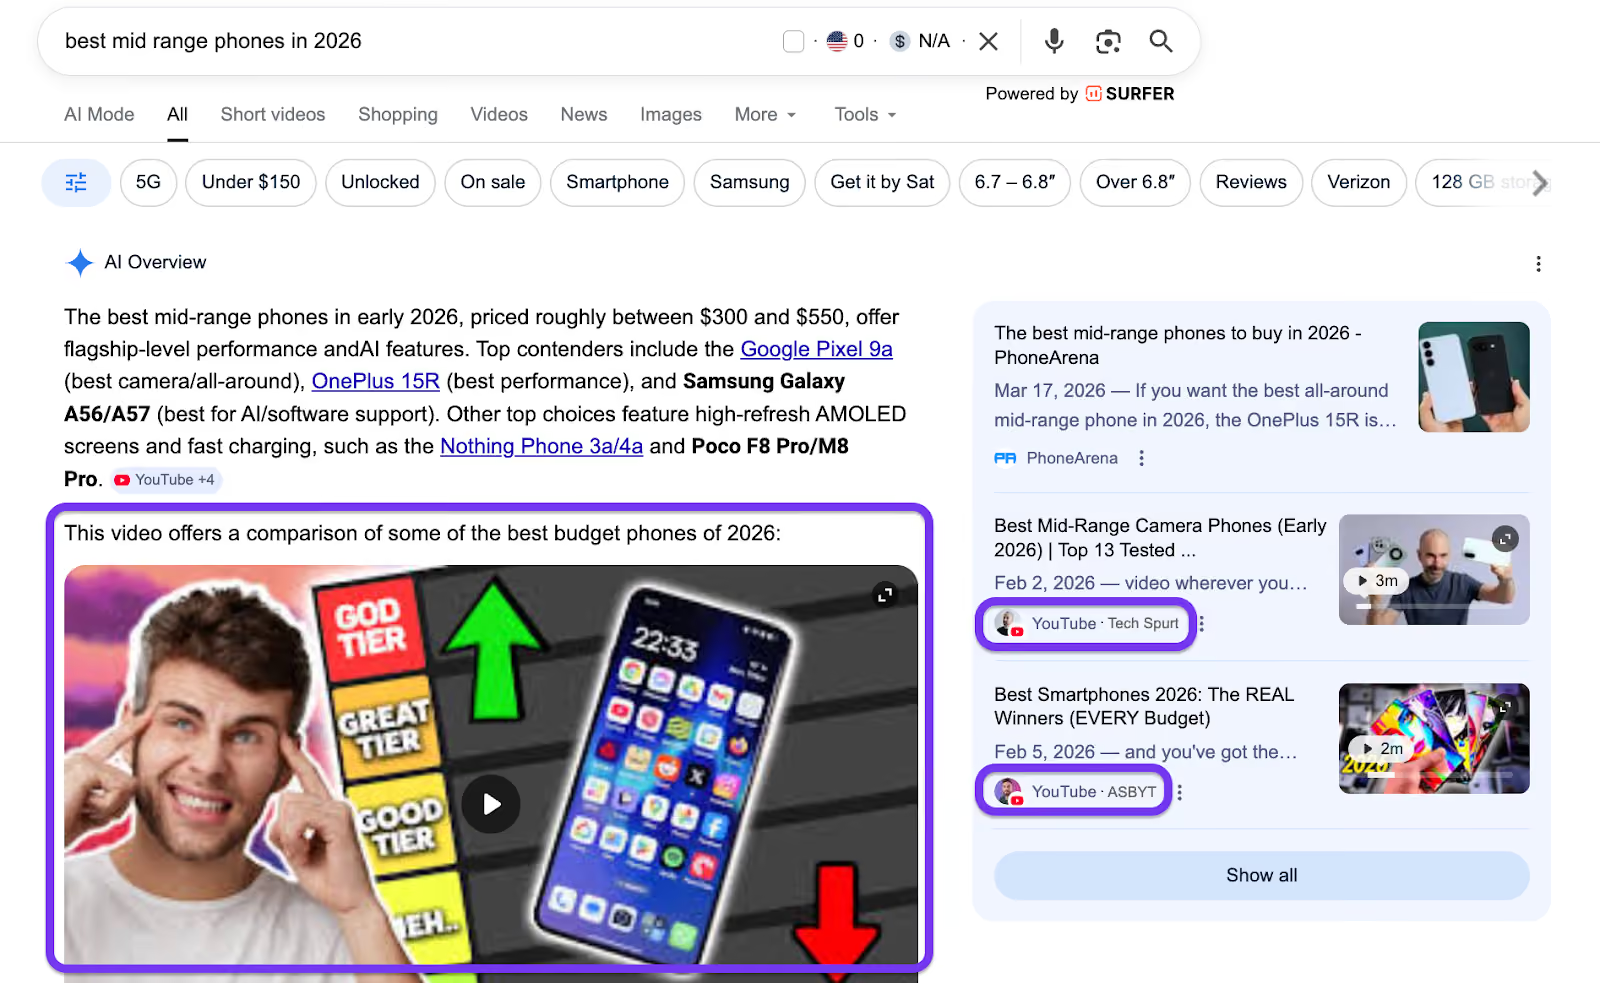
Ce que cela reflète, ce n’est pas le format du contenu, mais la présence de la marque dans les conversations du monde réel.
Cette présence a un impact mesurable.
Dans le même temps, chaque système pondère ces signaux différemment.
Il n’existe donc pas d’approche unique qui fonctionne sur tous les moteurs de recherche IA, mais la direction générale est claire.
Si les systèmes d’IA ne trouvent pas de sources tierces crédibles qui parlent de votre marque, ils sont moins enclins à faire confiance à votre contenu et à le réutiliser, quel que soit son niveau d’optimisation.
Cela change la manière d’aborder les stratégies SEO.
Les relations presse digitales, la présence sur YouTube, les podcasts du secteur, les avis, les mentions dans des annuaires de confiance et les discussions communautaires ne sont plus de simples activités de construction de marque. Elles déterminent directement si votre marque apparaît, ou non, dans les résultats de la recherche IA.
9. Google domine toujours, mais les utilisateurs passent par plusieurs plateformes pour leurs recherches
Malgré tout le bruit autour de la recherche IA, Google domine toujours.
En mars 2026, Google détenait environ 90 % des parts de marché mondiales de la recherche : environ 82 % sur ordinateur et 95 % sur mobile. L’idée selon laquelle « Google est en train de mourir » n’est donc pas étayée par les données.
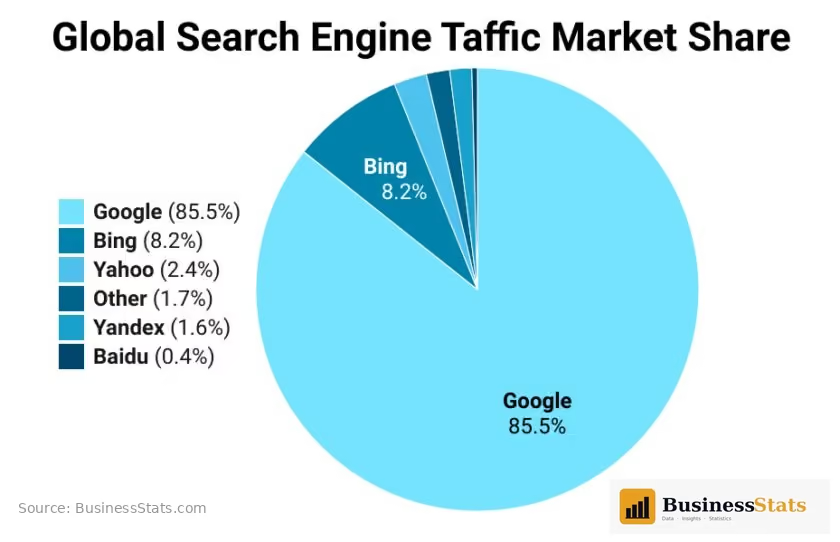
[Source]
Ce qui a changé, en revanche, c’est la façon dont les gens recherchent en parallèle. Selon Apptopia, l’usage des plateformes d’IA se répartit de plus en plus :
- La part de ChatGPT est passée d’environ 69 à 86 % début 2025 à environ 45 à 64 % début 2026
- Google Gemini a progressé rapidement, quadruplant à peu près sa part sur la même période
- Environ 20 % des utilisateurs utilisent désormais plusieurs applications d’IA, au lieu de s’en tenir à une seule
Certains signes montrent aussi que les utilisateurs prennent des habitudes durables sur plusieurs plateformes.
Les données d’Apptopia montrent également que le taux d’attrition de Claude est passé de 55 % à 36 % entre août 2025 et février 2026, la plus forte amélioration parmi les grandes applications d’IA, ce qui laisse penser que les utilisateurs restent fidèles à plusieurs outils plutôt que de se rabattre sur un seul.
Cela ne signifie pas que les utilisateurs quittent Google. Cela signifie que le parcours de recherche d’information s’élargit.
Aujourd’hui, un parcours de recherche ressemble plutôt à ceci :
- Commencer par ChatGPT ou d’autres outils d’IA pour explorer
- Valider via les pages de résultats de Google et plusieurs sites web
- Consulter des contenus générés par les utilisateurs comme Reddit, YouTube et les avis pour obtenir une preuve sociale
Être visible sur une seule plateforme ne suffit donc plus. Les marques doivent apparaître dans plusieurs environnements de recherche, chacun doté de ses propres systèmes de récupération et de classement.
Cela dit, il est important de ne pas surcorriger.
ChatGPT comptait environ 810 millions d’utilisateurs actifs mensuels début 2026, ce qui est considérable, mais Google traite toujours des milliards de recherches chaque jour. Pour la plupart des sites, l’essentiel du trafic organique provient encore des moteurs de recherche traditionnels.
Le changement n’est donc pas un remplacement, mais plutôt un élargissement.
10. L’autorité de marque compte plus que jamais
Google met l’accent sur l’E-E-A-T (Experience, Expertise, Authoritativeness, Trustworthiness : expérience, expertise, autorité et fiabilité) depuis des années. En pratique, Google utilise les signaux E-E-A-T comme une preuve sociale pour comprendre ce que d’autres personnes et d’autres sources disent de vous, et pas seulement ce que vous affirmez sur votre propre site.
Il ne suffit pas de publier de bons contenus sur votre propre domaine. Votre marque doit apparaître régulièrement sur d’autres sites : articles de presse, avis, forums, vidéos et contenus du secteur.
Une analyse d’Omniscient Digital portant sur plus de 23 000 citations IA a montré que l’étendue et la qualité de la couverture par des tiers prédisaient mieux la visibilité IA que l’autorité de domaine ou le profil de backlinks.
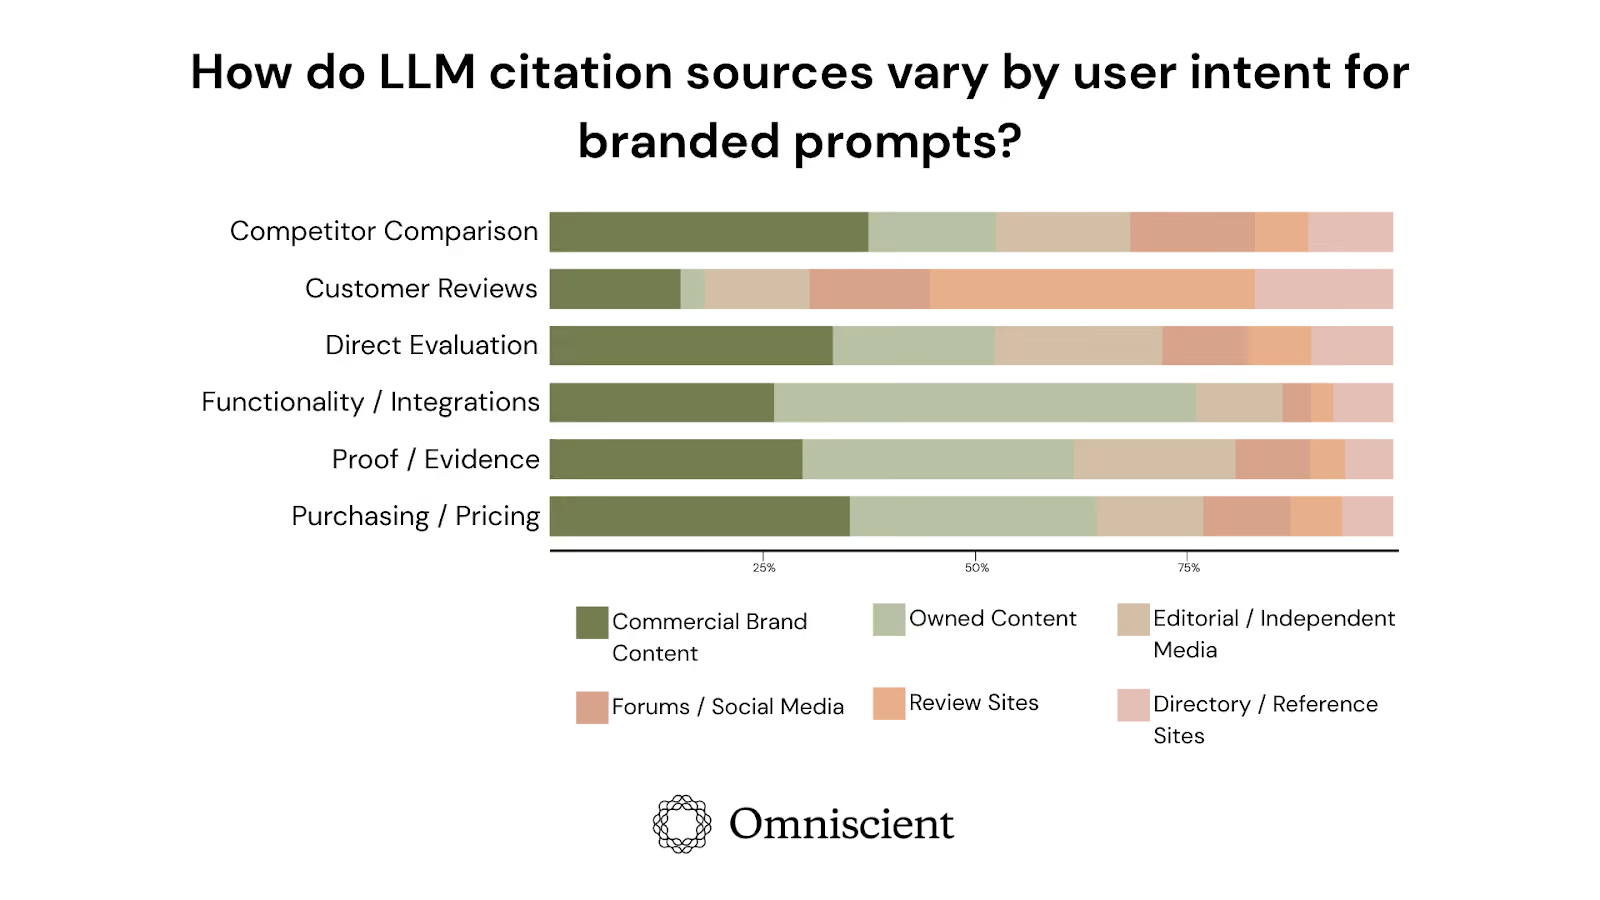
[Source]
Autrement dit, avoir un site solide ne suffit pas. Votre marque doit être présente dans plusieurs sources de confiance.
On retrouve la même tendance dans l’évolution des classements Google. Par le passé, Google a toujours récompensé :
- Les sites dotés d’une expertise claire sur leur sujet
- Les contenus fondés sur une expérience réelle
- Les marques citées partout sur le web
Dans le même temps, les systèmes de recherche IA utilisent des signaux similaires pour décider de ce qu’ils incluent dans leurs réponses.
Ils ne s’appuient pas sur une seule page. Ils puisent dans plusieurs sources et recoupent les informations. Si votre marque apparaît dans ces sources, elle a plus de chances d’être incluse. Sinon, votre propre contenu pèse moins à lui seul.
Cela a un impact direct sur le fonctionnement du SEO.
Les relations presse, les podcasts, YouTube, les avis et les discussions communautaires ne sont plus séparés du SEO. Ils déterminent directement si votre marque est récupérée, jugée fiable et réutilisée dans les réponses générées par l’IA.
Car, aussi bien dans la recherche traditionnelle que dans les systèmes d’IA, la visibilité dépend de plus en plus de l’existence de votre marque au-delà de votre propre site.
11. Un bon contenu IA peut se classer dans les résultats de Google
Le débat autour des contenus générés par l’IA est devenu trop simpliste, car il est souvent posé en ces termes : « le contenu IA, c’est du spam » ou « le contenu IA, c’est l’avenir ». En réalité, la vérité se situe quelque part entre les deux.
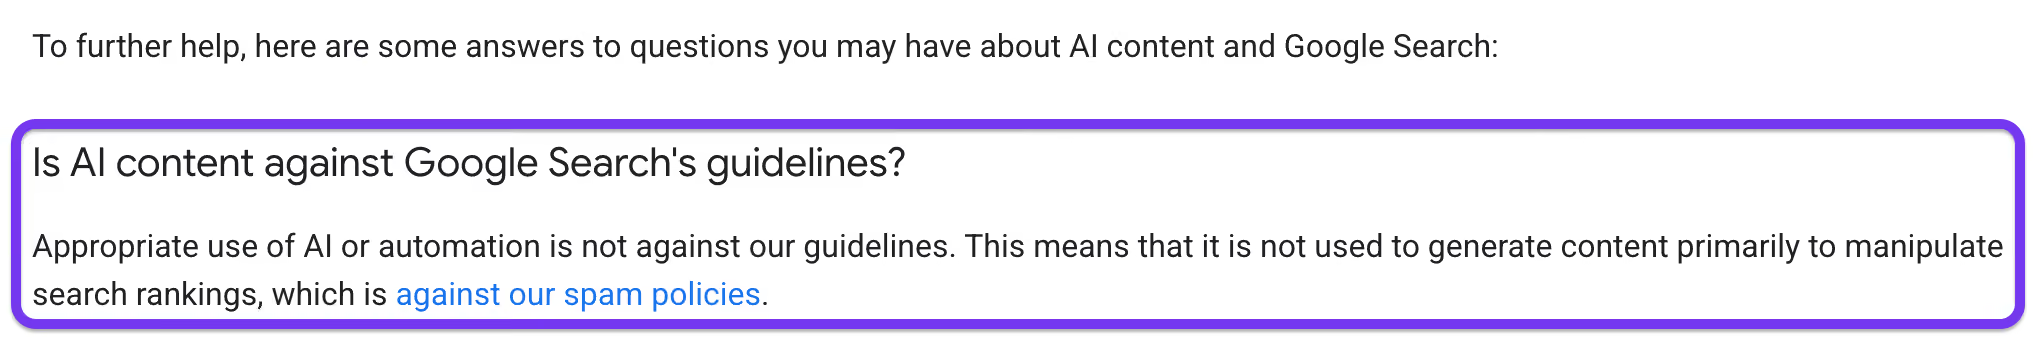
La position de Google sur les contenus générés par l’IA est constante.
Google ne pénalise pas un contenu parce qu’il est généré par l’IA. Ce qu’il pénalise, c’est l’abus de contenu à grande échelle (scaled content abuse) : de grands volumes de pages de faible valeur créées principalement pour manipuler les classements.
Les récentes core updates l’ont confirmé en traçant une frontière plus nette entre :
- Les contenus IA produits en masse et non relus
- Les contenus créés avec une expertise humaine, une supervision et un apport original
Seuls les premiers sont donc pénalisés. Et les données reflètent ce changement.
Une part croissante des pages les mieux positionnées intègre désormais une certaine dose d’assistance par l’IA. L’outil en lui-même n’est donc pas le problème. Ce qui compte, c’est que le contenu apporte quelque chose d’utile, d’exact ou d’original.
En pratique, la différence se voit dans la manière dont le contenu est créé.
- Un contenu assisté par l’IA, guidé, relu et appuyé sur une réelle expertise peut obtenir de bons résultats.
- Un contenu IA non relu qui répète des informations existantes a tendance à être ignoré ou rétrogradé.
Et les données reflètent ce changement.
Une part importante des pages positionnées aujourd’hui intègre une certaine dose d’assistance par l’IA. L’outil en lui-même n’est pas le problème. Ce qui compte, c’est de savoir si le contenu démontre une réelle expertise et apporte des informations nouvelles, ou s’il se contente de reformuler ce qui existe déjà.
C’est là que la nuance devient importante. Un contenu assisté par l’IA peut obtenir de bons résultats, surtout lorsque l’IA sert à :
- Structurer l’information
- Améliorer la clarté et la couverture du sujet
- Soutenir la création de contenu avec un apport humain
Mais un avantage net subsiste tout en haut de la page de résultats.
Marketer Milk en est un excellent exemple.
Le site est entièrement rédigé à partir de l’expérience vécue d’un seul praticien, et il est devenu le site SEO n° 1 en tendance suivi par Gaps.com, devant des blogs d’entreprise bien plus importants. L’auteur l’attribue au fait que Google récompense de plus en plus les vrais signaux E-E-A-T plutôt que les stratégies axées sur le volume.
Dans le même temps, des contenus assistés par l’IA produits à plus grande échelle peuvent toujours se classer, souvent dans les positions intermédiaires à basses de la première page.
Les deux approches « fonctionnent » donc, mais elles mènent à des résultats différents :
- Un contenu pensé d’abord pour l’humain et fondé sur l’expérience a plus de chances d’obtenir les premières positions et de les conserver
- Un contenu assisté par l’IA à grande échelle peut couvrir un plus large éventail de mots-clés, mais il est plus vulnérable aux mises à jour
L’IA est un outil puissant pour créer du contenu, mais elle ne remplace ni l’expertise humaine ni la réflexion stratégique.
Et comme les algorithmes de recherche comme les systèmes d’IA privilégient de plus en plus la crédibilité, l’écart entre un contenu « suffisant » et un contenu réellement utile devient plus visible dans les classements.
12. Les requêtes dérivées (query fan-out) aident à apparaître dans les AI Overviews
Quand une personne fait une recherche dans Google AI Mode ou d’autres moteurs de recherche, les systèmes d’IA ne cherchent pas seulement cette requête exacte. Ils la déclinent en plusieurs sous-requêtes associées, appelées requêtes dérivées (query fan-out), pour construire une réponse complète.
Au lieu de répondre à une seule question, ils puisent donc dans plusieurs questions associées pour produire des résumés générés par l’IA plus complets pour votre requête.
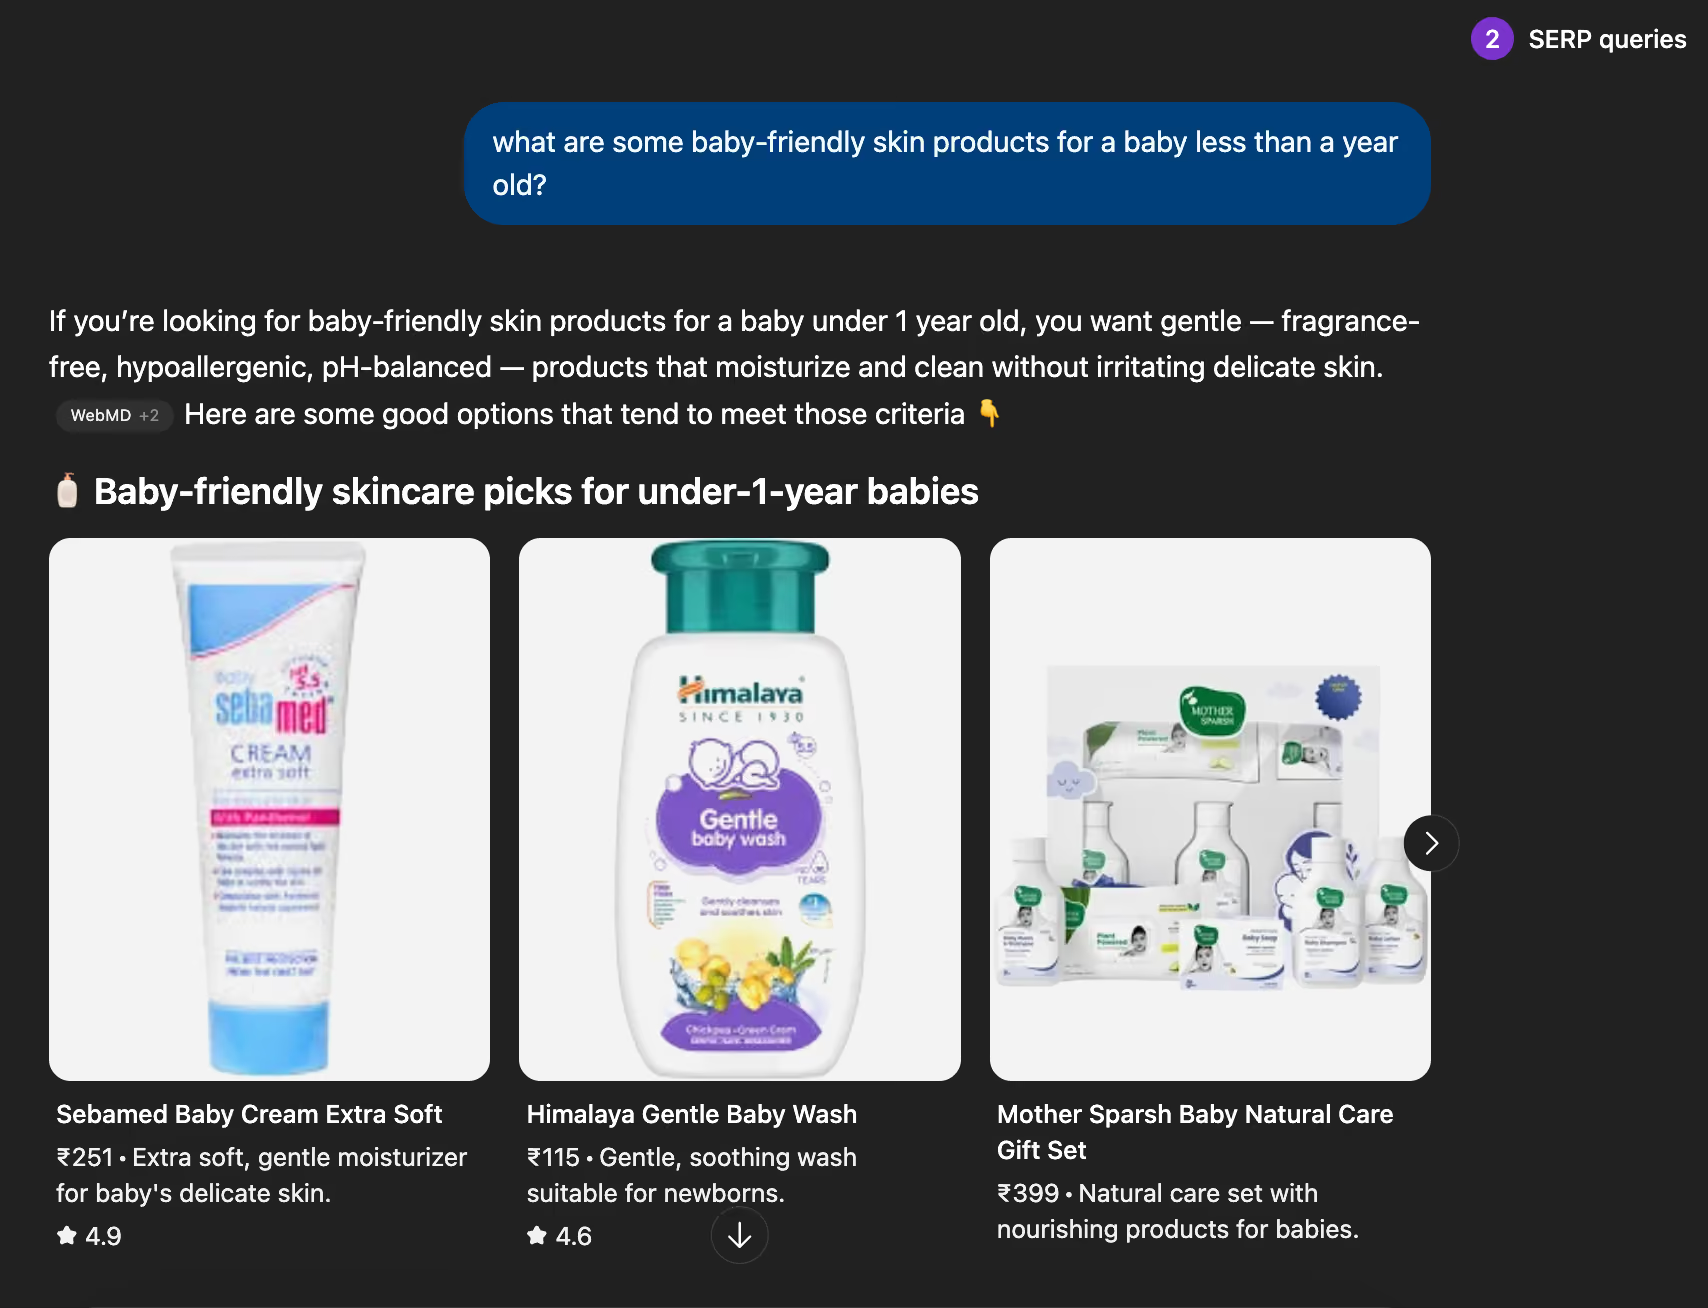
Voici par exemple une recherche que j’ai faite récemment sur ChatGPT :
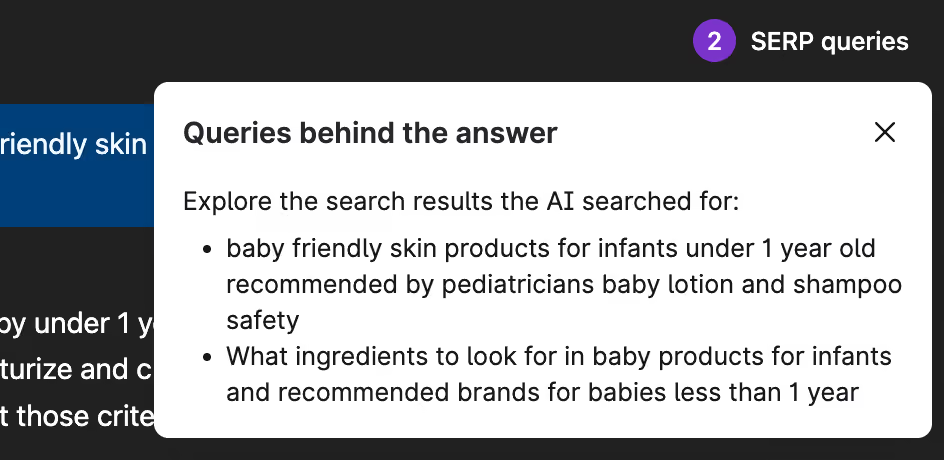
Grâce à l’extension Chrome gratuite Keyword Surfer, je peux voir quelles requêtes dérivées ChatGPT a lancées :
ChatGPT fusionne ensuite toutes les informations recueillies grâce à ces requêtes dérivées en une seule réponse directe (avec les sources citées).
En moyenne, un AI Overview génère environ 6 requêtes dérivées, et plus de 90 % des recherches déclenchent plusieurs variantes.
Cela influe directement sur les sources citées. Search Engine Land a constaté que les pages ont 161 % de chances en plus d’être citées lorsqu’elles se classent à la fois sur la requête principale et sur au moins une requête dérivée associée.
Et plus la couverture augmente, plus la visibilité augmente.
Les pages classées sur au moins 4 requêtes associées sont citées plus de 3 fois plus souvent que celles classées sur une seule.
Cela explique aussi pourquoi beaucoup de pages citées ne sont pas bien classées sur le mot-clé principal.
Une étude de Surfer montre qu’environ 67 % des citations des AI Overviews ne proviennent pas du top 10 des résultats pour la requête principale. Mais beaucoup de ces mêmes pages se classent sur des requêtes associées, et c’est ce qui leur permet d’être retenues.
L’avantage ne vient donc pas d’une seule page bien classée. Il vient de la couverture du sujet.
Votre stratégie de recherche ne doit donc pas se concentrer sur un seul mot-clé par article de blog. Les professionnels du SEO et les équipes de content marketing doivent s’attacher à :
- Répondre à la requête principale
- Couvrir les sous-thèmes associés
- Traiter les questions de suivi
Et les données de Surfer le montrent clairement :
- Plus de 70 % des pages citées se classent sur au moins une requête dérivée
- Moins de 40 % se classent uniquement sur la requête principale
- Les pages couvrant plusieurs requêtes dépassent 60 % de taux de citation, contre moins de 20 % pour les pages ciblant une seule requête
En bref, les AI Overviews ne récompensent pas l’optimisation sur un seul mot-clé ni le volume de recherche, comme le faisaient autrefois les algorithmes des moteurs de recherche. Ils récompensent la qualité avec laquelle vous couvrez le sujet dans son ensemble.
13. Le référencement naturel adopte de nouvelles métriques au lieu des anciens indicateurs de vanité
Pendant des années, les experts SEO ont mesuré leur réussite avec un ensemble familier de métriques : positions sur les mots-clés cibles, volume de recherche, trafic organique et impressions.
Ces métriques SEO clés comptent toujours, mais elles ne racontent plus toute l’histoire.
Quand 47 % des recherches déclenchent des AI Overviews, dont une majorité aboutit à des recherches zéro clic, être en 3e position dans les résultats n’a plus le même poids qu’avant.
Ce changement pousse les professionnels du marketing digital à observer de nouveaux signaux, comme :
- Le taux d’inclusion dans les réponses IA : votre marque apparaît-elle seulement dans les réponses générées par l’IA ?
- La fréquence des citations : à quelle fréquence vous êtes mentionné selon les requêtes
- La perception de la marque dans les mentions : comment votre marque est présentée dans les réponses
- Le trafic référent IA : les visites provenant de ChatGPT, Perplexity ou Gemini
- Les signaux de session : les utilisateurs continuent-ils à chercher après avoir consulté votre page ?
Cette dernière métrique est particulièrement importante.
Dans la synthèse des tendances 2026 de Moz, Veronika Höller (Head of Demand Generation chez Tresorit) souligne que le comportement en session (plus précisément, le fait que les utilisateurs continuent ou non à chercher après être arrivés sur votre page) pourrait devenir un signal SEO central.
Autrement dit, si les utilisateurs retournent immédiatement à la recherche, votre contenu n’a probablement pas répondu à leur intention.
Dans le même temps, mesurer précisément tout cela reste difficile, car il n’existe pas encore d’équivalent de Google Analytics pour la recherche IA.
La plupart des outils s’appuient sur l’échantillonnage de prompts : des requêtes sont lancées régulièrement sur plusieurs plateformes pour vérifier les mentions. Comme les outils d’IA génèrent des réponses différentes selon le contexte, le moment et l’état de l’utilisateur, ces métriques peuvent varier fortement.
C’est pourquoi la plupart des « scores de visibilité IA » doivent être considérés comme indicatifs, et non comme une mesure exacte.
Mais les nouvelles métriques ne sont pas le changement le plus important à surveiller. Il faut surtout regarder à quoi ces métriques sont rattachées.
La mesure du SEO doit se rattacher à des résultats concrets, comme les leads, le chiffre d’affaires et le pipeline générés auprès de votre audience cible, et pas seulement à la visibilité.
Bien sûr, cela a toujours été vrai, mais cela devient plus important encore en raison du manque de fiabilité des nouvelles métriques IA et du caractère de plus en plus superficiel des métriques traditionnelles.
Les positions, le trafic et les impressions comptent toujours. Ils ne suffisent simplement plus à eux seuls.
14. La recherche IA reste étroitement liée au SEO traditionnel
Avec tous les nouveaux termes, outils et débats autour de la recherche IA, il est facile de croire qu’il s’agit d’une discipline complètement distincte du SEO traditionnel.
Ce n’est pas le cas.
Tous les grands moteurs de recherche IA s’appuient toujours sur l’infrastructure existante de la recherche web. ChatGPT puise dans Bing. Perplexity utilise Google et Bing. Les AI Overviews de Google reposent sur le même index que ses résultats organiques.
Ces systèmes ne récupèrent pas leurs informations dans un web distinct « optimisé pour l’IA ». Ils puisent dans les mêmes pages que les SEO optimisent depuis des années.
De plus, des études ont montré qu’une grande partie des sources citées par l’IA se classent déjà sur Google.
Le SEO en 2026 sera marqué par la recherche pilotée par l’IA, l’accent mis sur l’E-E-A-T et un basculement vers les contenus générés par les utilisateurs plutôt que vers les contenus IA synthétiques.
Le moyen le plus fiable d’apparaître dans les résultats de la recherche IA reste donc l’application des bonnes pratiques SEO que nous avons toujours suivies :
- Traiter les sujets en profondeur
- Construire une véritable autorité thématique
- Créer des contenus qui peuvent être récupérés et réutilisés
L’IA a changé la façon dont les contenus sont sélectionnés et présentés. Mais elle n’a pas remplacé les fondations sur lesquelles elle repose.
Si les tactiques évoluent, l’essentiel a donc moins changé qu’il n’y paraît.
Où va réellement le SEO en 2026
Les tendances SEO évoluent vite, mais les fondamentaux ont moins changé qu’il n’y paraît.
Oui, la recherche IA, le RAG et les systèmes pilotés par des agents changent la façon dont les contenus sont récupérés et présentés. Mais ils s’appuient toujours sur le même web et sur les mêmes signaux de fond.
Il existe aussi un net écart entre ce qui fait l’objet d’un battage médiatique et ce que les données confirment réellement.
Beaucoup de tendances SEO dont on parle en ce moment ne tiennent pas la route :
- llms.txt n’est pas utilisé par les robots d’IA
- L’optimisation en Markdown n’a montré aucun impact sur les citations
- De nombreux outils GEO mesurent des choses différentes, si bien que leurs scores ne sont pas comparables
Ce que les données confirment :
- La récupération détermine la visibilité : si votre contenu n’est pas récupéré, il ne sera pas utilisé dans les réponses de l’IA.
- La couverture thématique l’emporte sur les mots-clés isolés : les pages qui couvrent des requêtes associées sont davantage citées.
- L’autorité de marque influe sur les citations : les mentions dans des sources de confiance augmentent la visibilité.
- Les systèmes à base d’agents commencent à compter : les sites utilisables par des agents auront un avantage.
Au final, les tendances SEO de 2026 récompensent toujours les contenus réellement utiles, faciles à trouver, jugés fiables au-delà de votre propre site et qui couvrent suffisamment bien le sujet pour être réutilisés.
La façon dont le web fait ressortir les contenus change, mais ce qui leur vaut d’être mis en avant, lui, n’a pas changé.